2027年2月試験(新シラバス)対応2026年11月20日時点の法令・公表資料基準情報の正確さへの取り組み

生成AIパスポート試験

生成AIパスポートを、法令と公的な指針で確かめながら覚える。

生成AIパスポート試験(2027年2月からの新シラバス)の5章を、シラバスと法令・政府の指針などの一次資料に基づくオリジナル一問一答・論点解説・比較表で学習。間違えた理由まで復習できます。

登録なしで使えます。学習の記録はこの端末に保存されます。

810
○×一問一答
58
論点整理
810
暗記項目
12
記事

学習の進め方

  1. 1

    今日の10問で現在地を測る

    資格ごとの主要な学習分野から選んだ10問です。毎日入れ替わります。

    まずは今日の10問を解く
  2. 2

    間違えた理由を確かめる

    正誤だけでなく、判断の決め手と間違えやすい点を読み、続けて復習したい関連論点へ進めます。

    論点整理を見る
  3. 3

    分野をしぼって解き込む

    AIの基礎と歴史・生成AI・AIエージェント・生成AIのリスク予防・AI倫理・ガバナンス・生成AIの実践と活用事例を、単元で絞り込んで反復します。

    ○×一問一答へ
  4. 4

    取りこぼしを潰す

    間違えた問題は復習リストに自動で入ります。登録なしでも、この端末に保存されます。

    復習ノートを見る

図で覚える

条文で覚えられないなら、
絵で焼きつける。

数字と例外が混ざる論点ほど、文字だけでは残りません。対比の構図と表を一枚にした図解なら、試験中に「あの絵のどこに書いてあったか」で思い出せます。58枚を公開中。
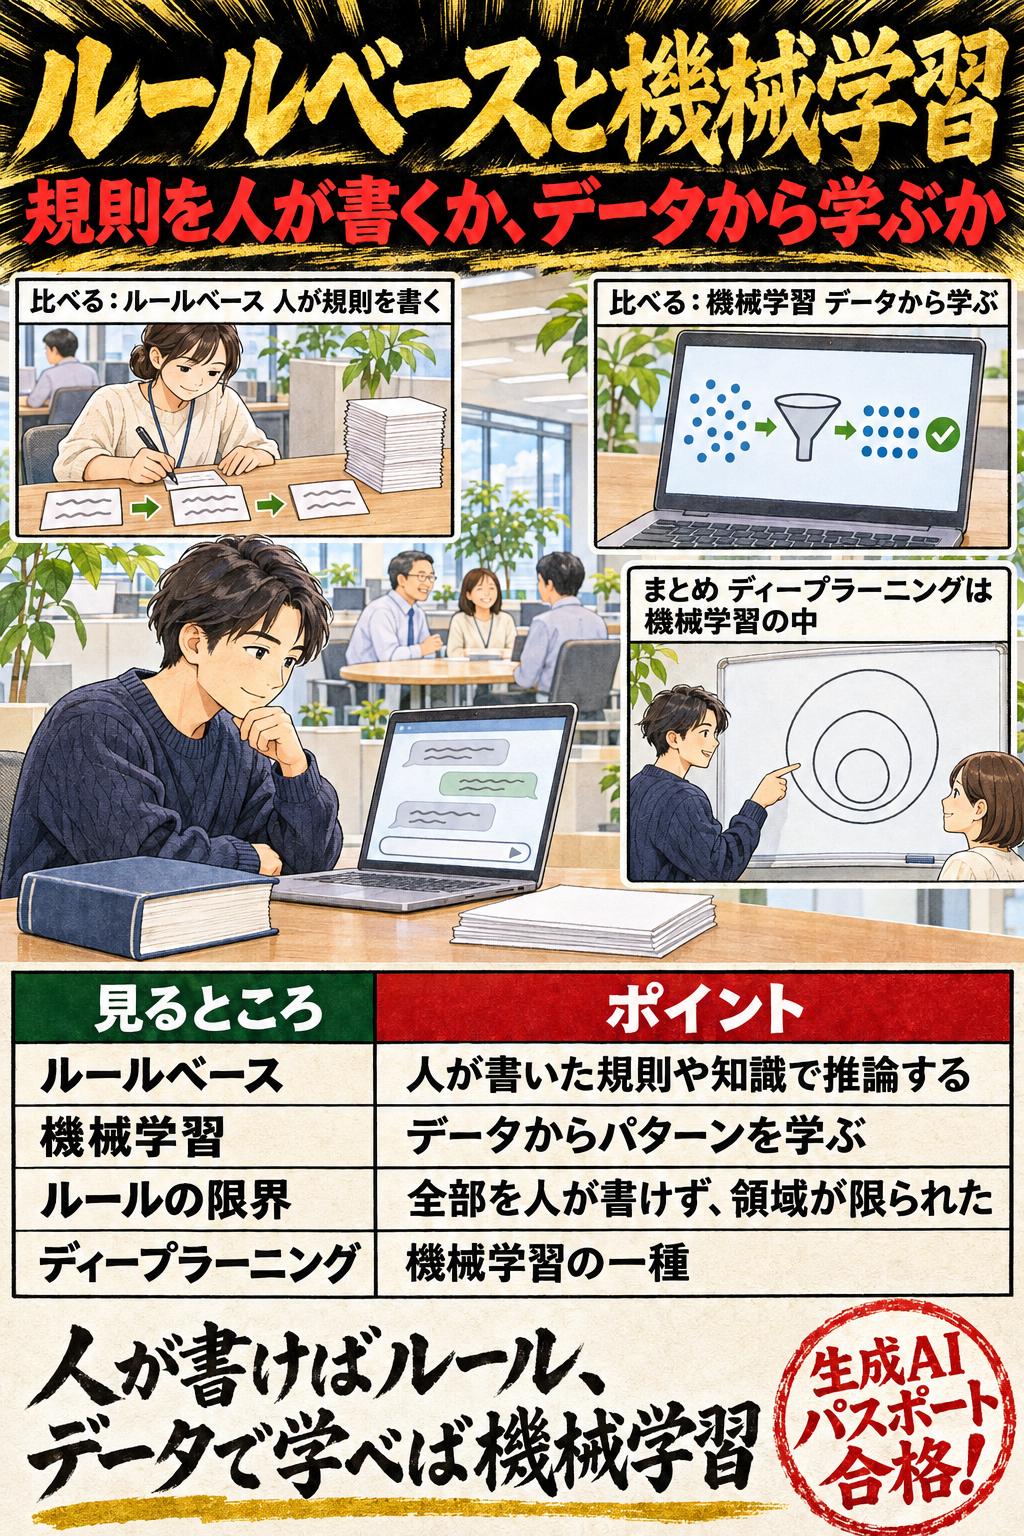
  • AIとは(ルールベースと機械学習)の暗記図解。ルールベースと機械学習。規則を人が書くか、データから学ぶか。ルールベース:人が書いた規則や知識で推論する。機械学習:データからパターンを学ぶ。ルールの限界:全部を人が書けず、領域が限られた。ディープラーニング:機械学習の一種。人が書けばルール、データで学べば機械学習
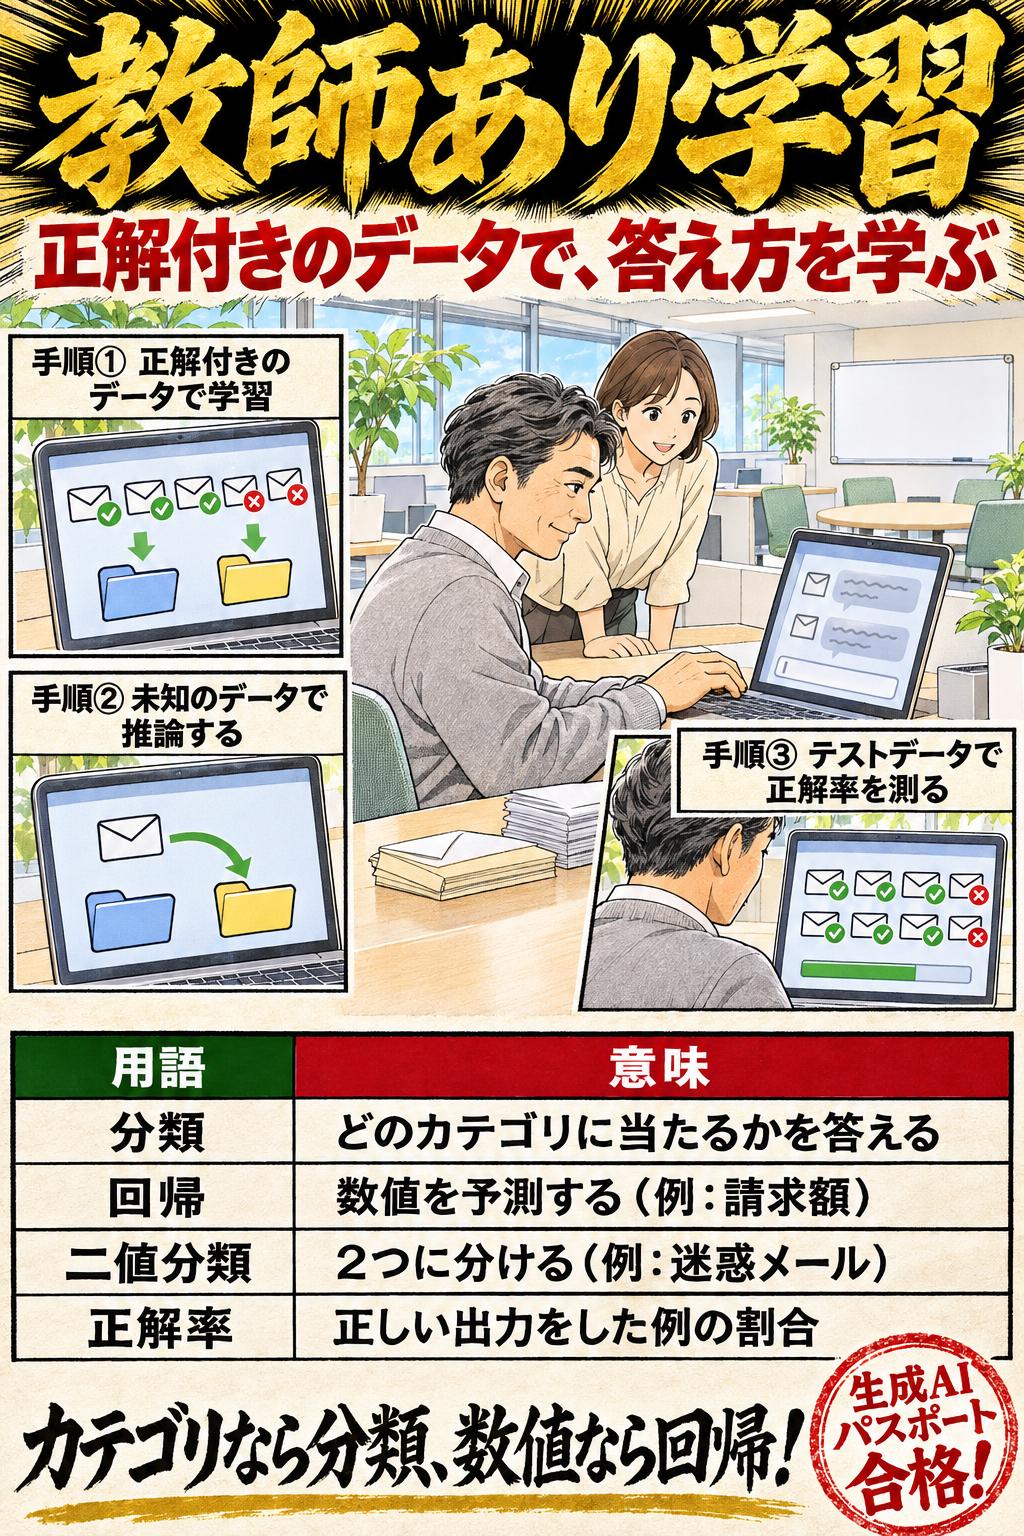
  • 機械学習と教師あり学習(分類・回帰・正解率)の暗記図解。教師あり学習。正解付きのデータで、答え方を学ぶ。分類:どのカテゴリに当たるかを答える。回帰:数値を予測する(例:請求額)。二値分類:2つに分ける(例:迷惑メール)。正解率:正しい出力をした例の割合。カテゴリなら分類、数値なら回帰!
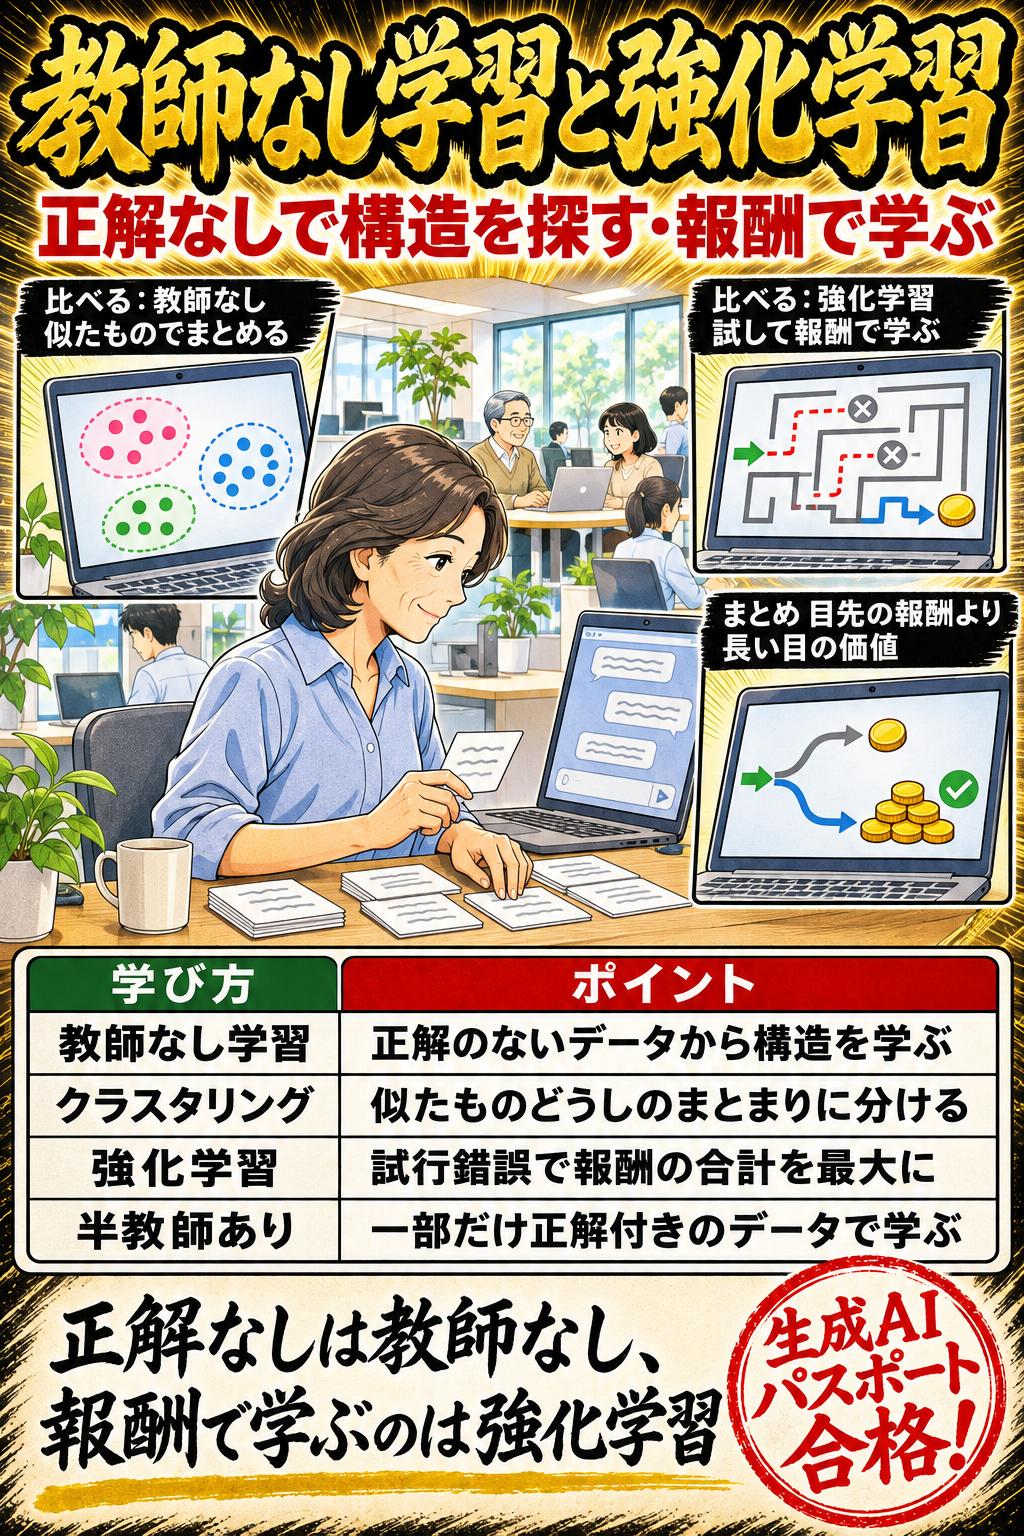
  • 教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理の暗記図解。教師なし学習と強化学習。正解なしで構造を探す・報酬で学ぶ。教師なし学習:正解のないデータから構造を学ぶ。クラスタリング:似たものどうしのまとまりに分ける。強化学習:試行錯誤で報酬の合計を最大に。半教師あり:一部だけ正解付きのデータで学ぶ。正解なしは教師なし、報酬で学ぶのは強化学習
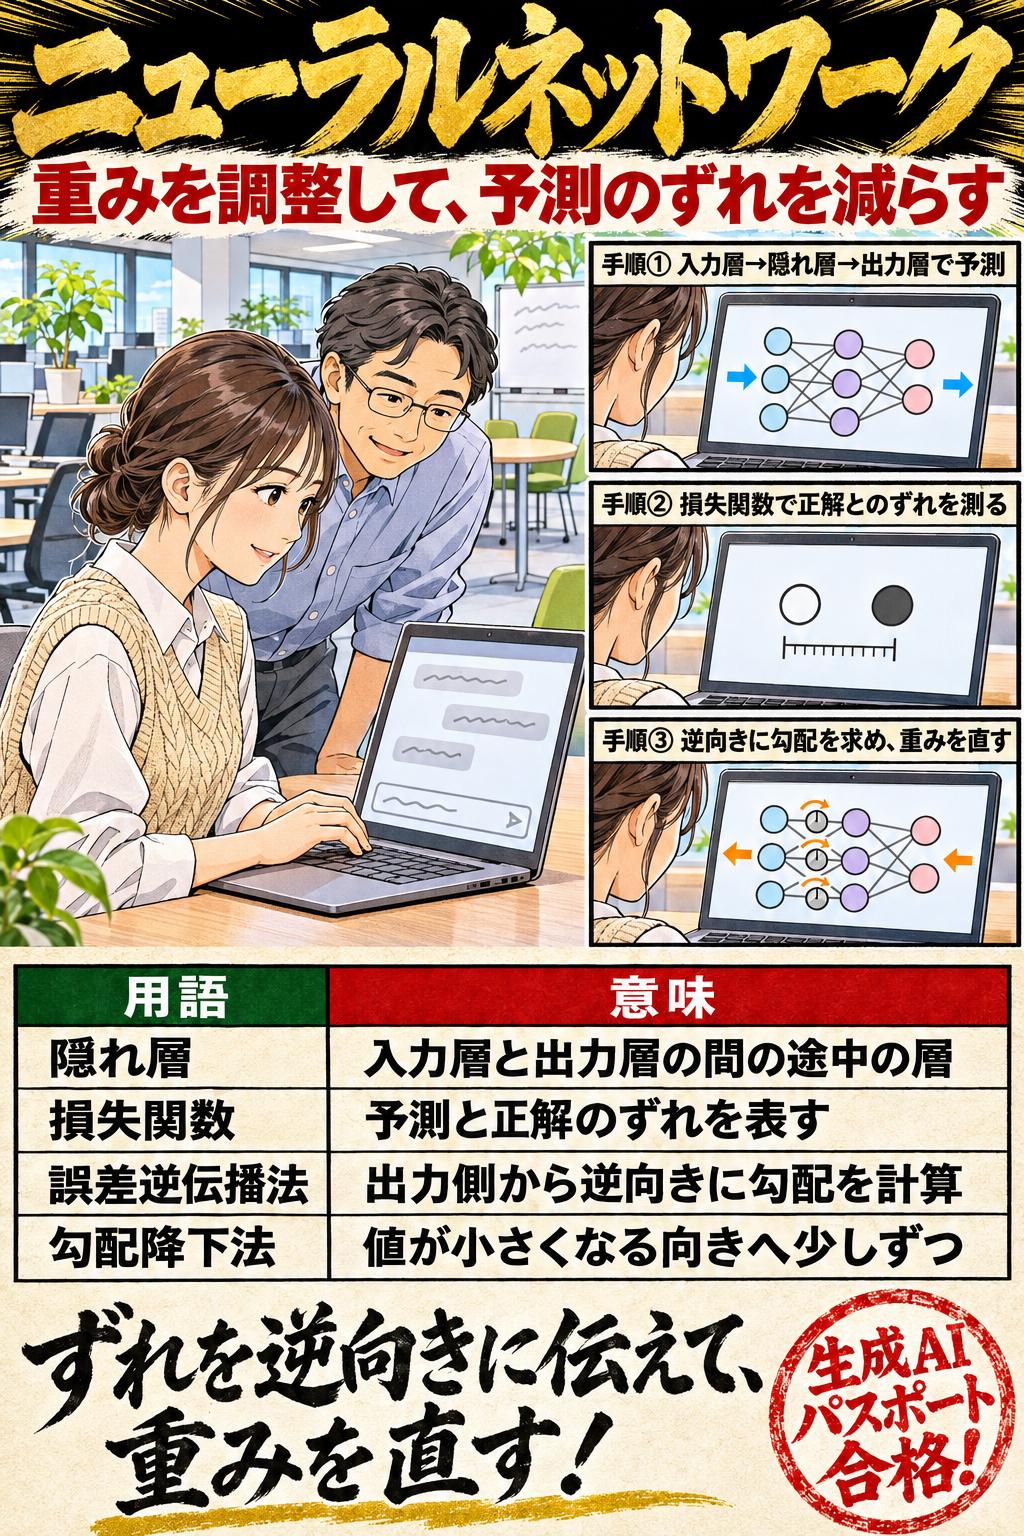
  • ニューラルネットワークとディープラーニング(重みの調整と誤差逆伝播法)の暗記図解。ニューラルネットワーク。重みを調整して、予測のずれを減らす。隠れ層:入力層と出力層の間の途中の層。損失関数:予測と正解のずれを表す。誤差逆伝播法:出力側から逆向きに勾配を計算。勾配降下法:値が小さくなる向きへ少しずつ。ずれを逆向きに伝えて、重みを直す!
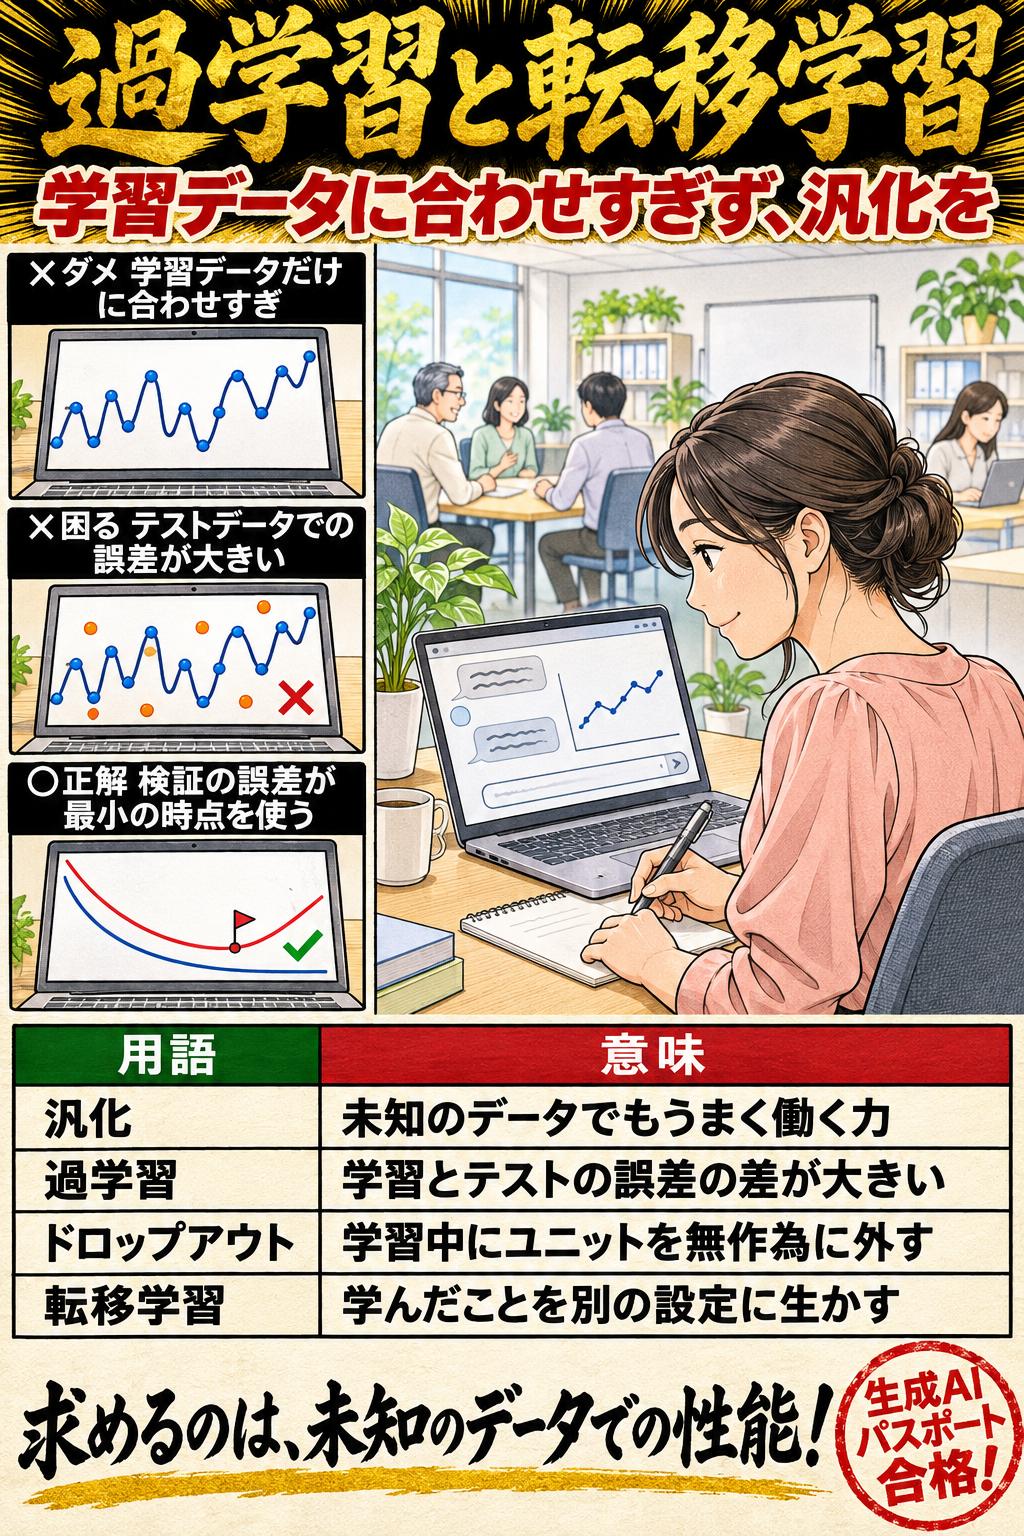
  • 過学習と対策・転移学習の暗記図解。過学習と転移学習。学習データに合わせすぎず、汎化を。汎化:未知のデータでもうまく働く力。過学習:学習とテストの誤差の差が大きい。ドロップアウト:学習中にユニットを無作為に外す。転移学習:学んだことを別の設定に生かす。求めるのは、未知のデータでの性能!
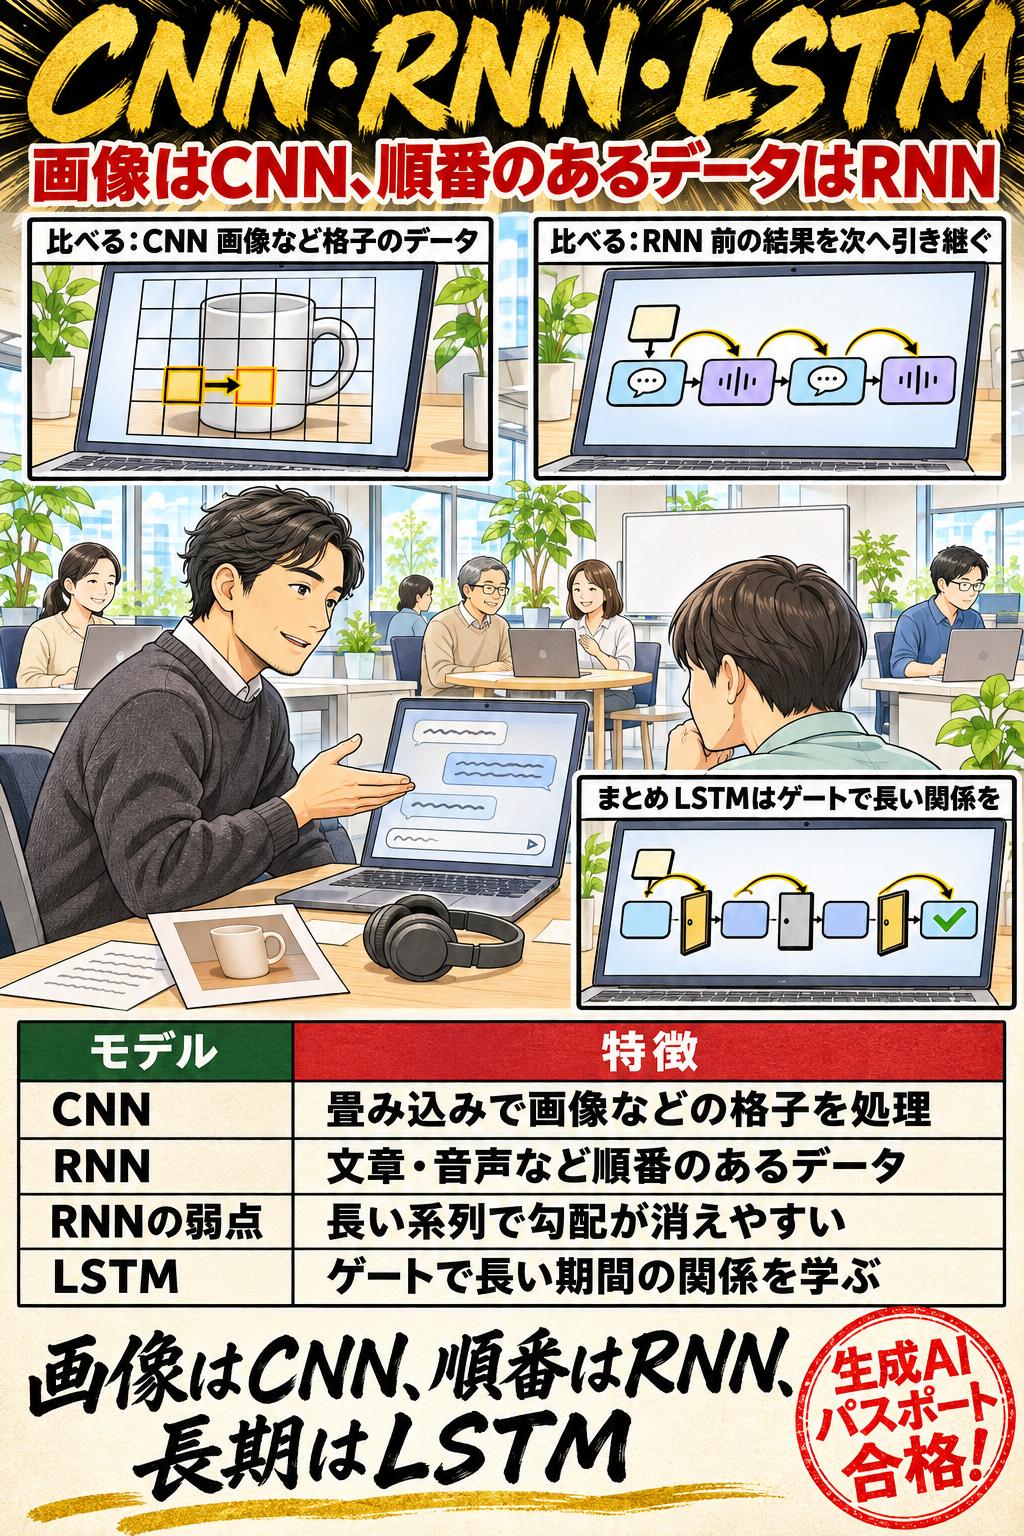
  • CNN・RNN・LSTMの暗記図解。CNN・RNN・LSTM。画像はCNN、順番のあるデータはRNN。CNN:畳み込みで画像などの格子を処理。RNN:文章・音声など順番のあるデータ。RNNの弱点:長い系列で勾配が消えやすい。LSTM:ゲートで長い期間の関係を学ぶ。画像はCNN、順番はRNN、長期はLSTM
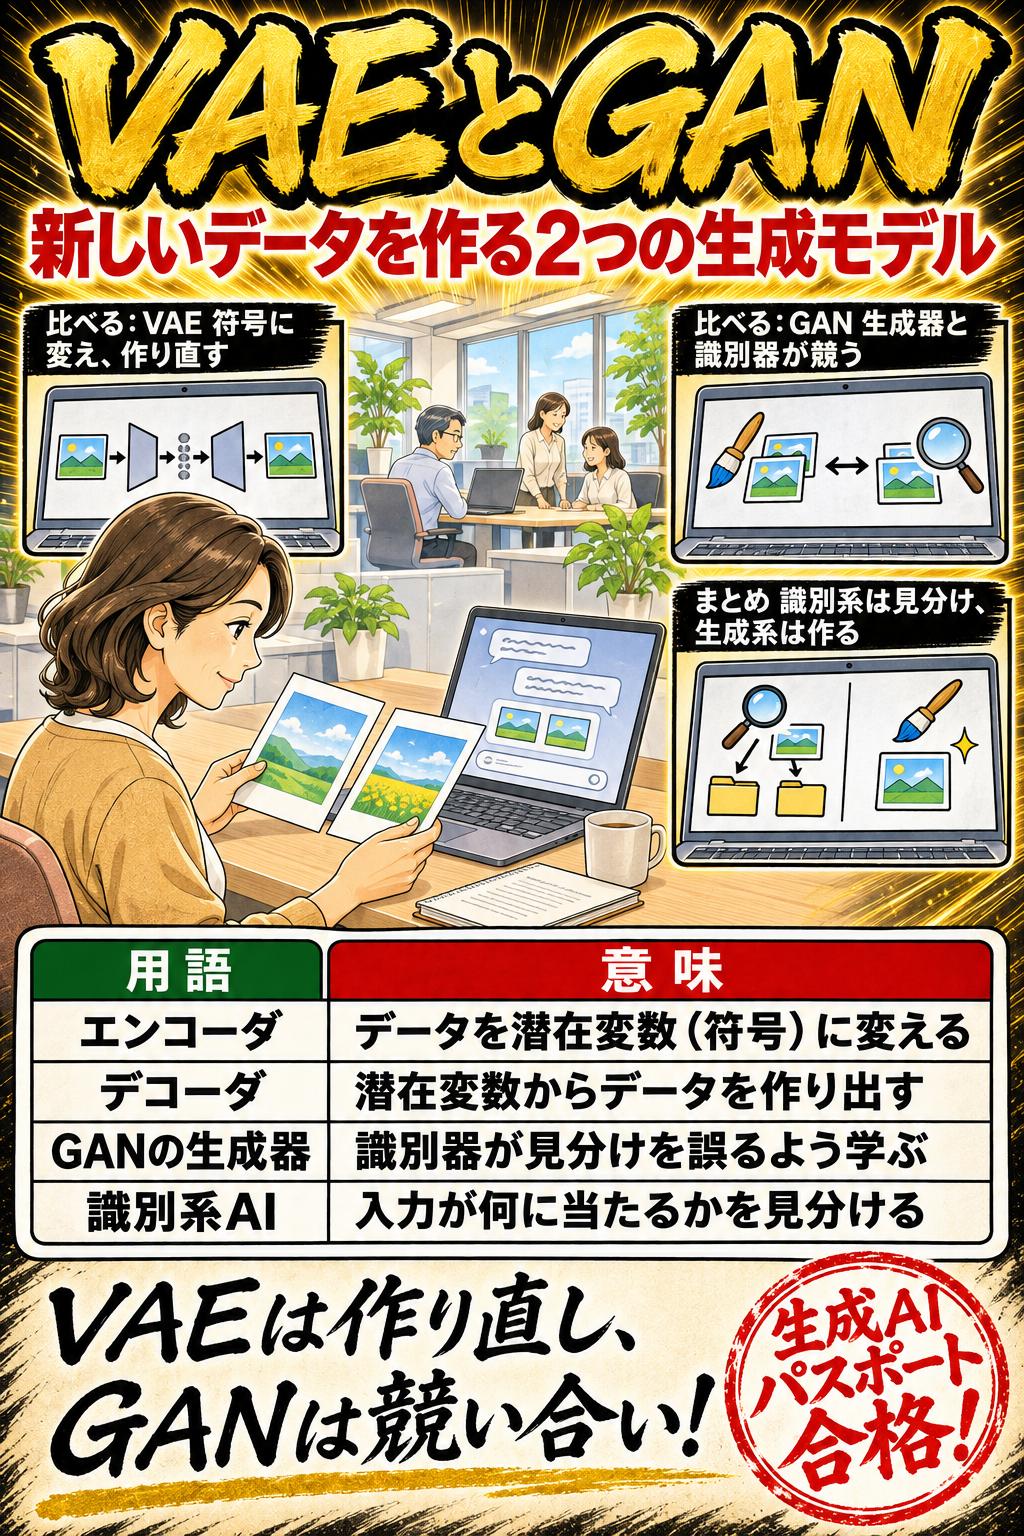
  • VAE・GANと識別系AI・生成系AIの違いの暗記図解。VAEとGAN。新しいデータを作る2つの生成モデル。エンコーダ:データを潜在変数(符号)に変える。デコーダ:潜在変数からデータを作り出す。GANの生成器:識別器が見分けを誤るよう学ぶ。識別系AI:入力が何に当たるかを見分ける。VAEは作り直し、GANは競い合い!
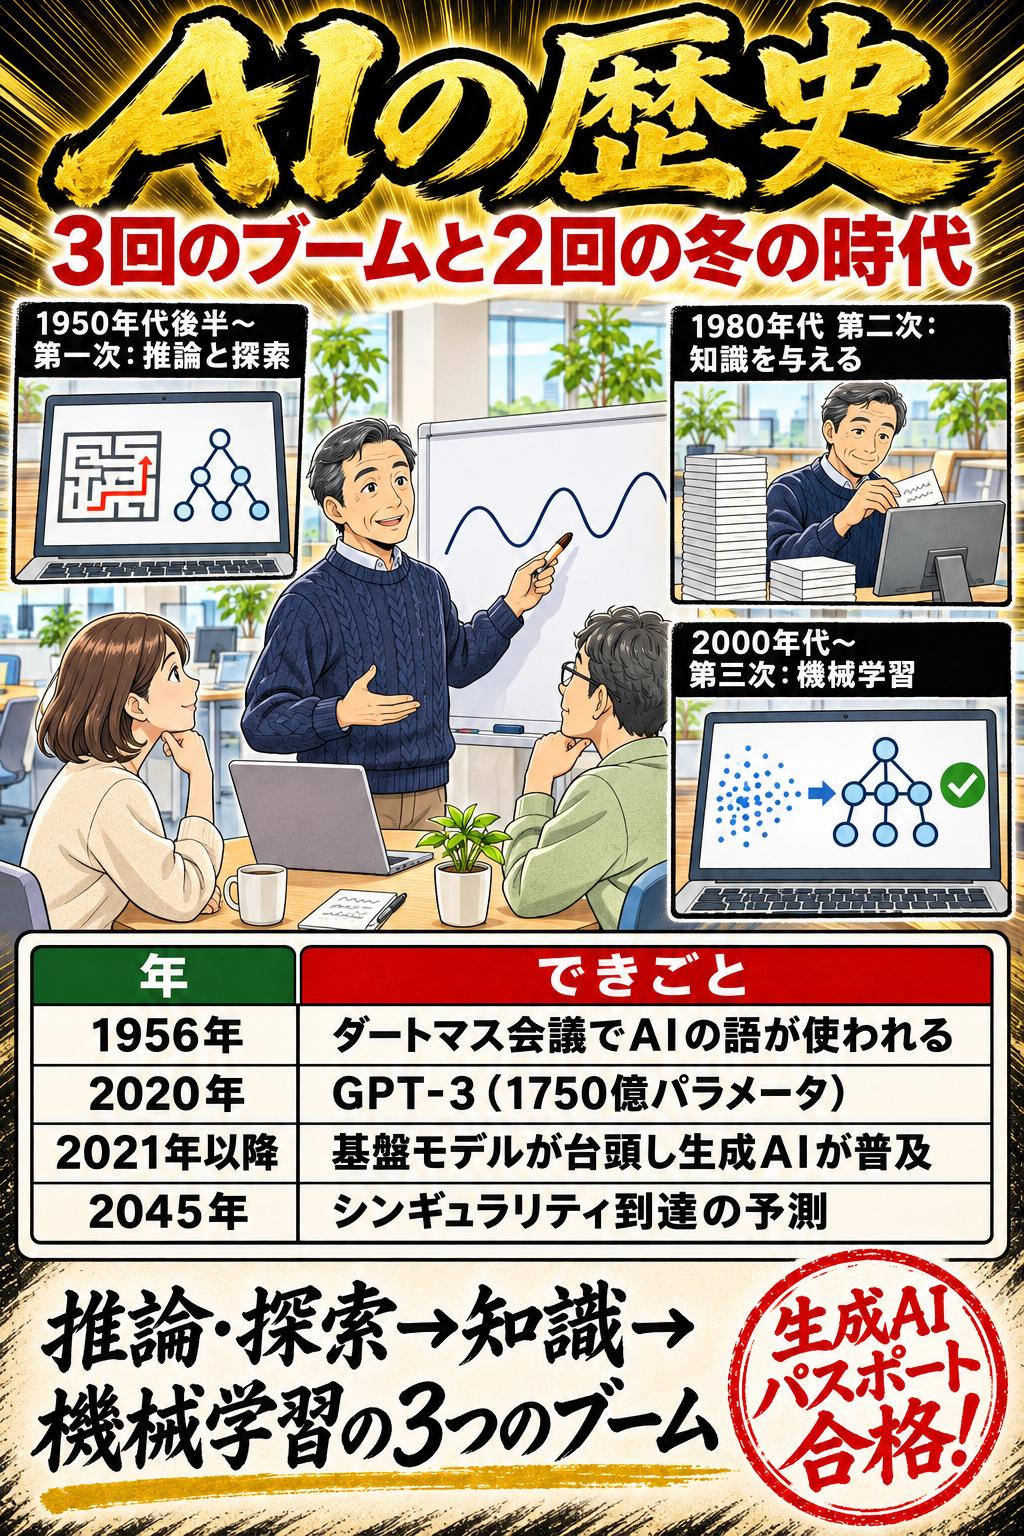
  • AIの歴史(ダートマス会議から生成AI・シンギュラリティまで)の暗記図解。AIの歴史。3回のブームと2回の冬の時代。1956年:ダートマス会議でAIの語が使われる。2020年:GPT-3(1750億パラメータ)。2021年以降:基盤モデルが台頭し生成AIが普及。2045年:シンギュラリティ到達の予測。推論・探索→知識→機械学習の3つのブーム
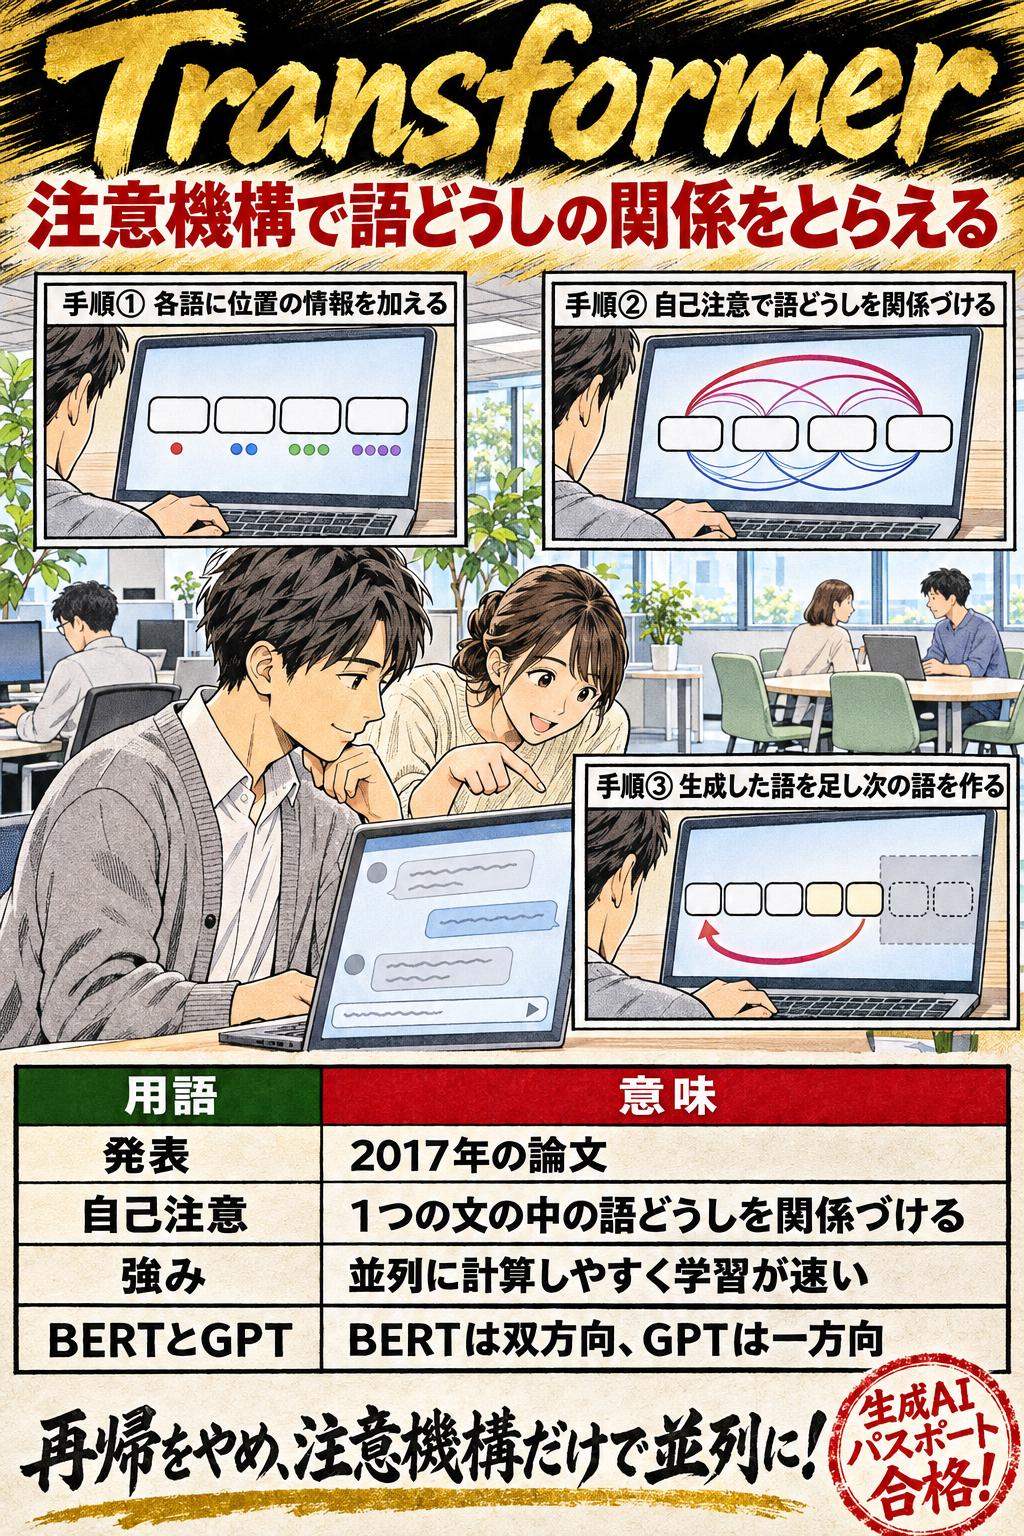
  • Transformerと自己注意機構・派生モデルの系譜の暗記図解。Transformer。注意機構で語どうしの関係をとらえる。発表:2017年の論文。自己注意:1つの文の中の語どうしを関係づける。強み:並列に計算しやすく学習が速い。BERTとGPT:BERTは双方向、GPTは一方向。再帰をやめ、注意機構だけで並列に!
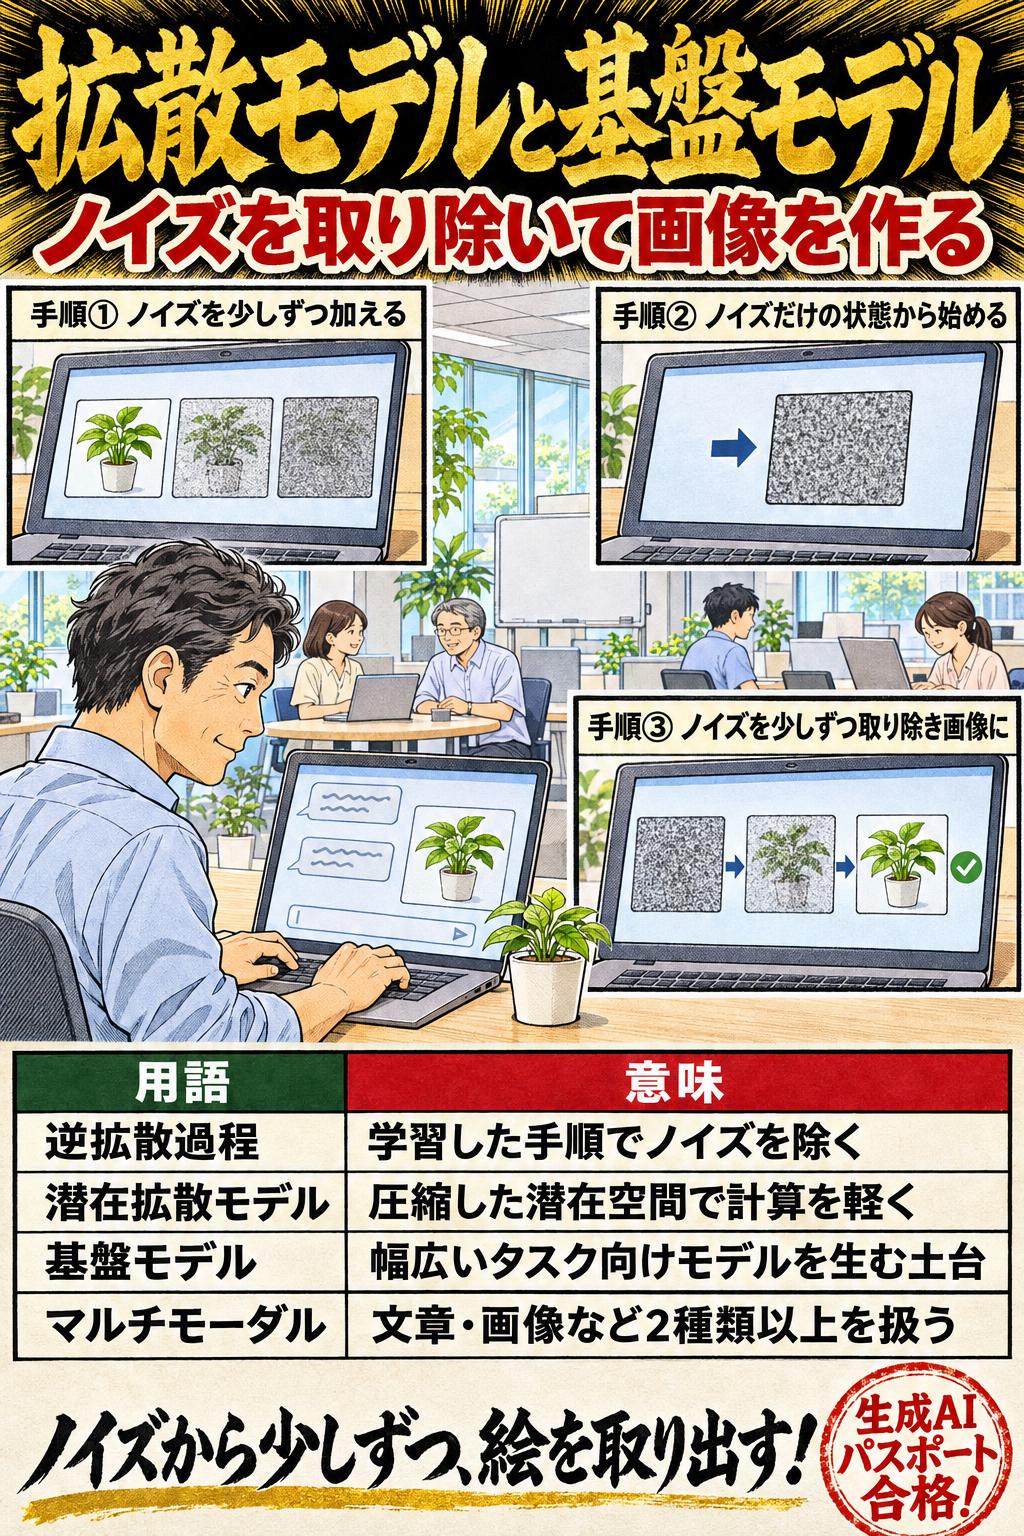
  • 拡散モデル・基盤モデル・マルチモーダルモデルの暗記図解。拡散モデルと基盤モデル。ノイズを取り除いて画像を作る。逆拡散過程:学習した手順でノイズを除く。潜在拡散モデル:圧縮した潜在空間で計算を軽く。基盤モデル:幅広いタスク向けモデルを生む土台。マルチモーダル:文章・画像など2種類以上を扱う。ノイズから少しずつ、絵を取り出す!
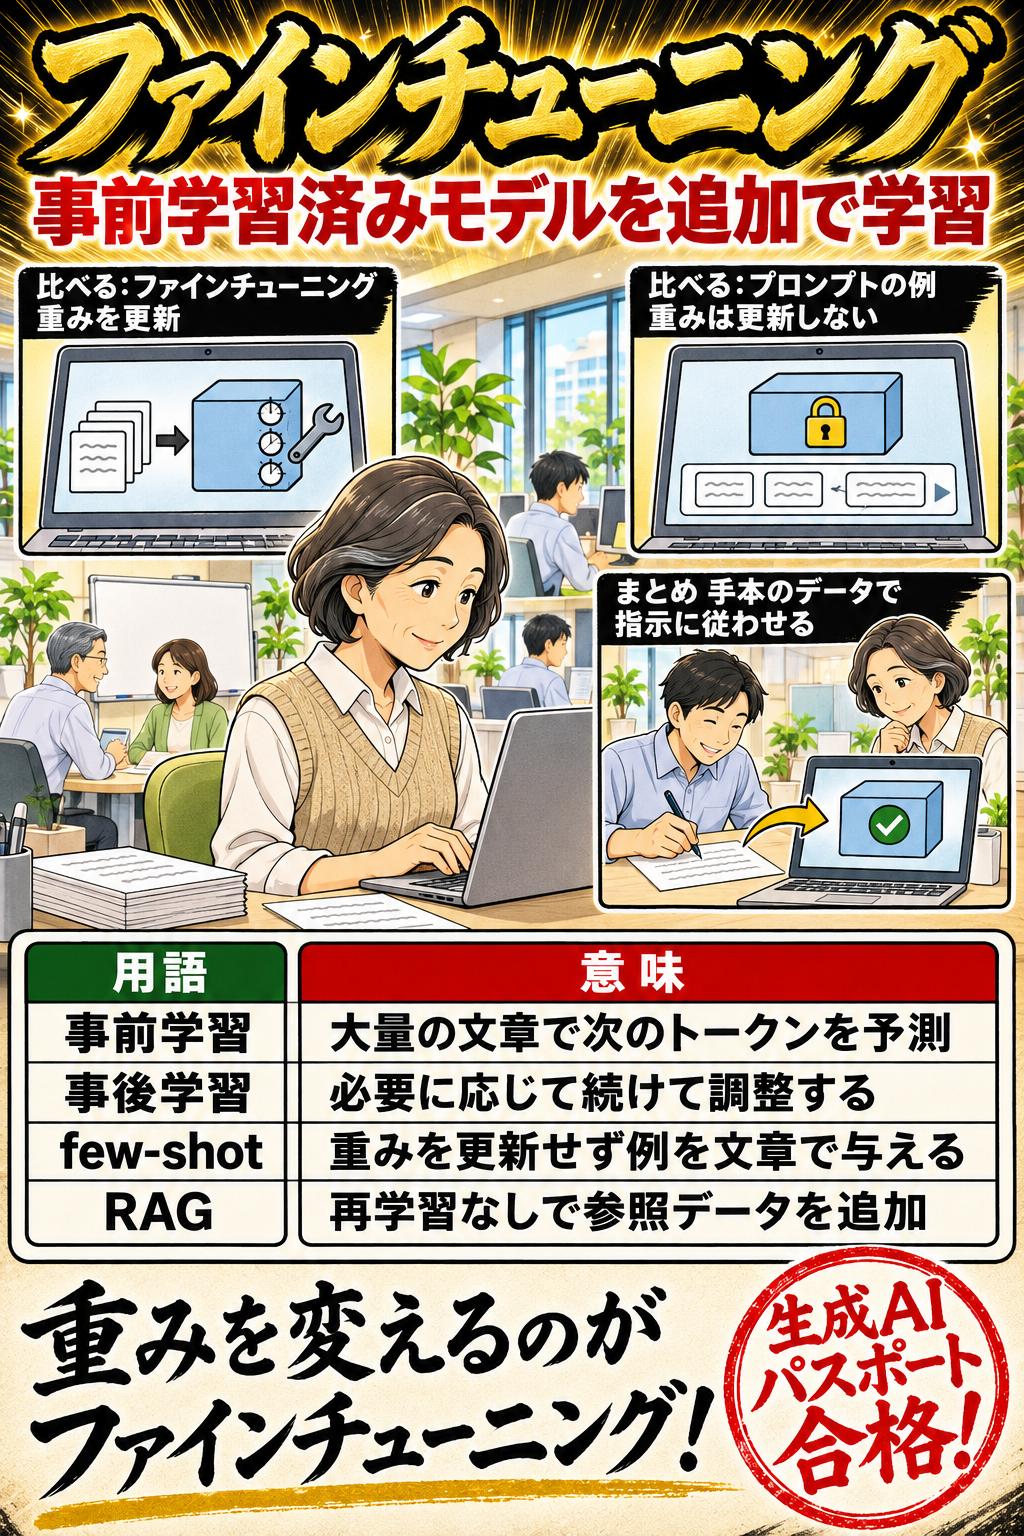
  • 事前学習とファインチューニング(指示チューニング)の暗記図解。ファインチューニング。事前学習済みモデルを追加で学習。事前学習:大量の文章で次のトークンを予測。事後学習:必要に応じて続けて調整する。few-shot:重みを更新せず例を文章で与える。RAG:再学習なしで参照データを追加。重みを変えるのがファインチューニング!
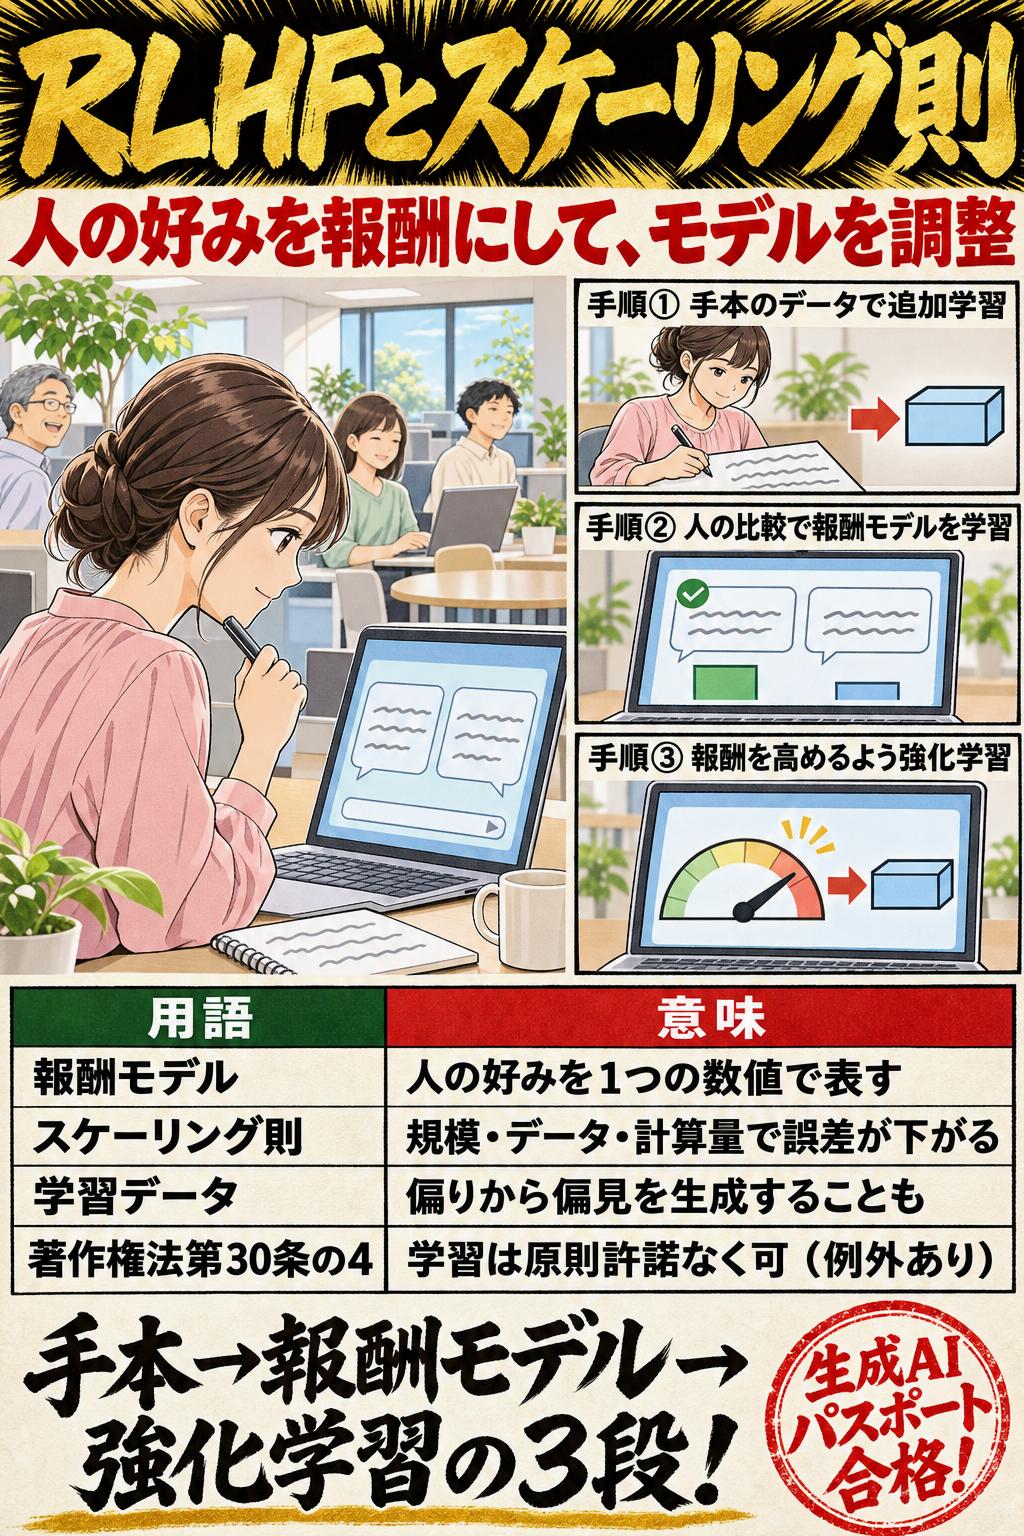
  • RLHF・学習データの課題・スケーリング則の暗記図解。RLHFとスケーリング則。人の好みを報酬にして、モデルを調整。報酬モデル:人の好みを1つの数値で表す。スケーリング則:規模・データ・計算量で誤差が下がる。学習データ:偏りから偏見を生成することも。著作権法第30条の4:学習は原則許諾なく可(例外あり)。手本→報酬モデル→強化学習の3段!
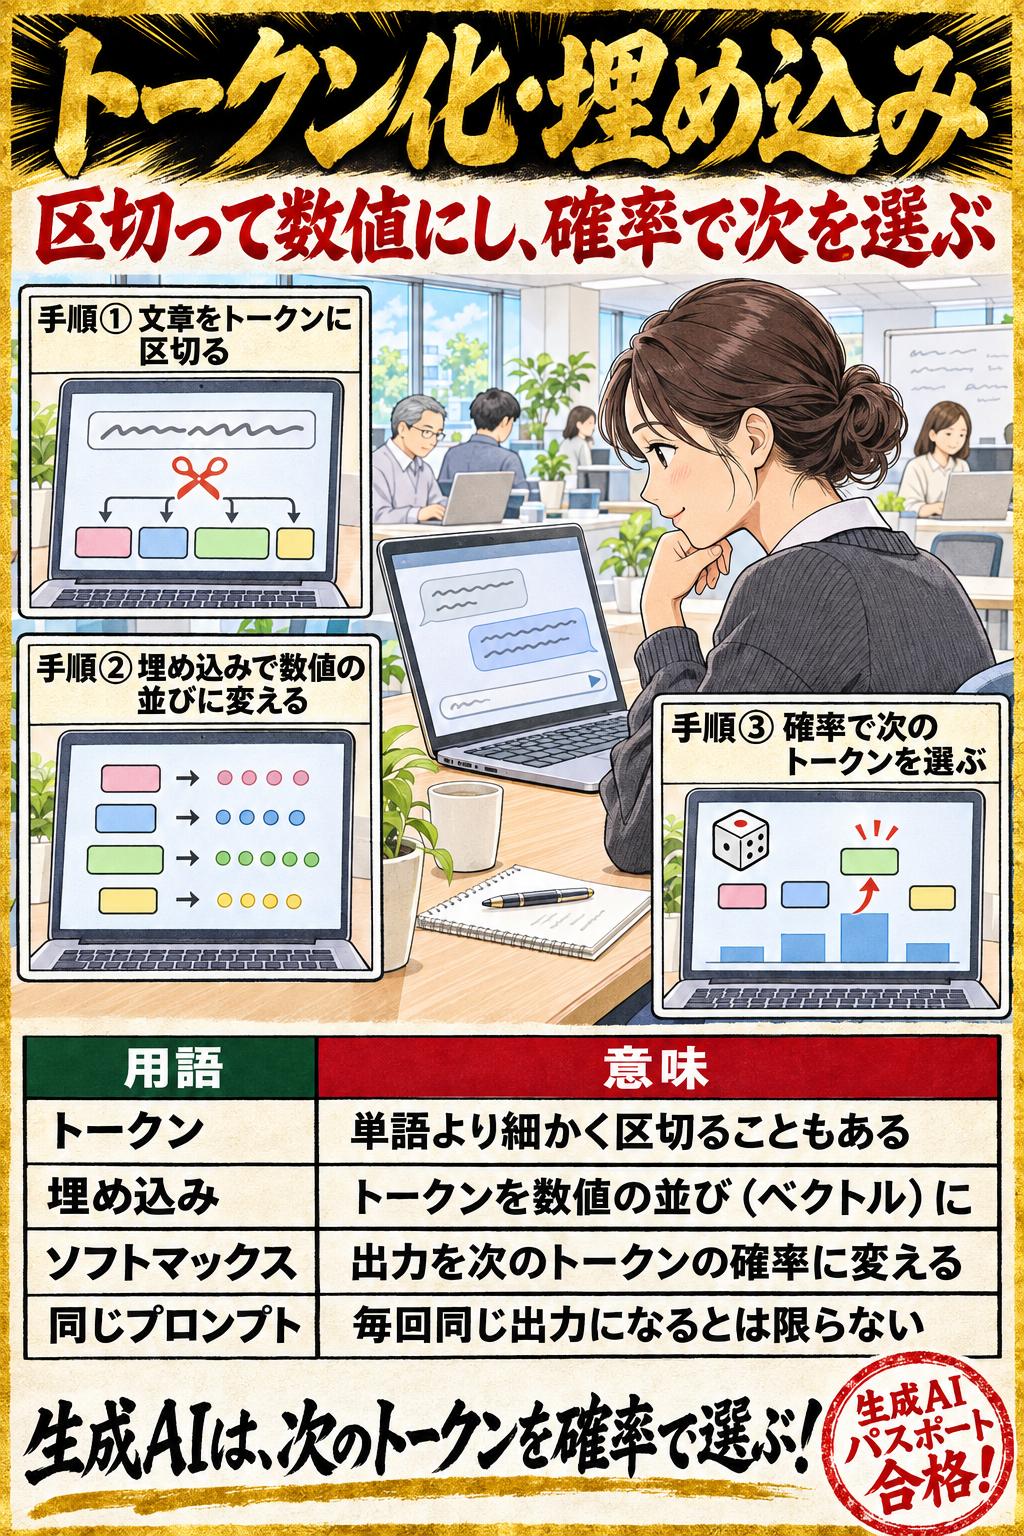
  • トークン化・埋め込み・確率的な次トークン予測の暗記図解。トークン化・埋め込み。区切って数値にし、確率で次を選ぶ。トークン:単語より細かく区切ることもある。埋め込み:トークンを数値の並び(ベクトル)に。ソフトマックス:出力を次のトークンの確率に変える。同じプロンプト:毎回同じ出力になるとは限らない。生成AIは、次のトークンを確率で選ぶ!
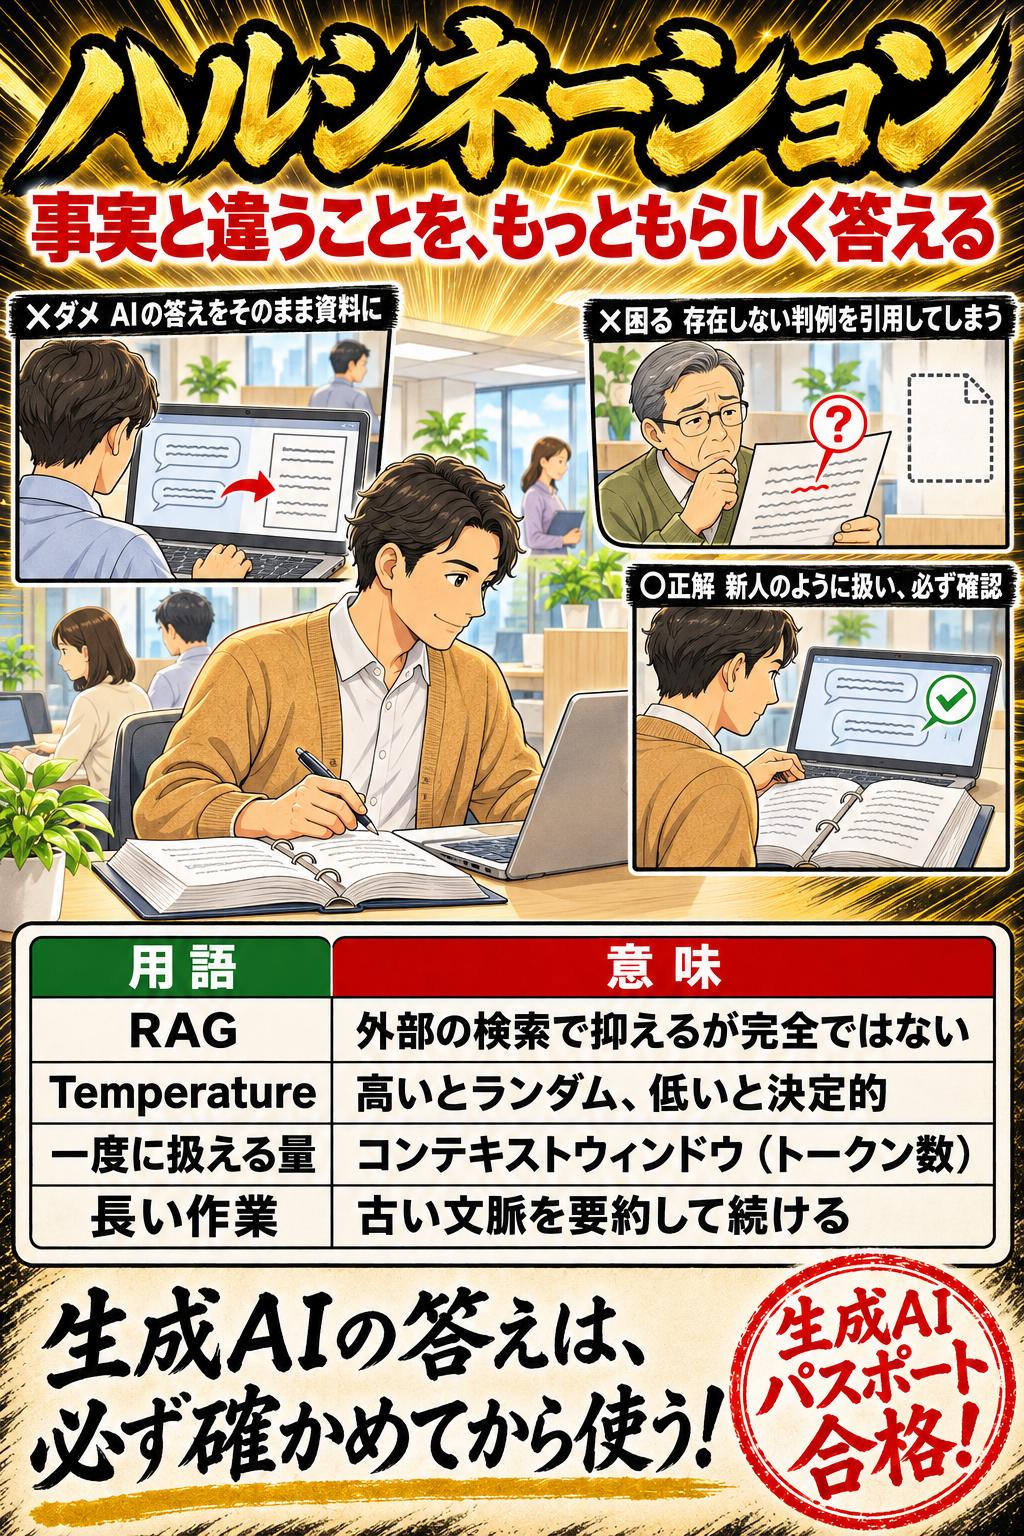
  • ハルシネーション・生成パラメータ・コンテキストウィンドウの暗記図解。ハルシネーション。事実と違うことを、もっともらしく答える。RAG:外部の検索で抑えるが完全ではない。Temperature:高いとランダム、低いと決定的。一度に扱える量:コンテキストウィンドウ(トークン数)。長い作業:古い文脈を要約して続ける。生成AIの答えは、必ず確かめてから使う!

試験情報

試験は年5回(2・4・6・8・10月)で、各回に1か月の受験期間があり、その中でオンライン(IBT方式)で受験します。新しいシラバスは2027年2月試験から使われます。日程は一般社団法人生成AI活用普及協会(GUGA)の公表内容を確認してください。

料金について

無料で使える範囲

一問一答、暗記表、論点整理は登録なしで使えます。公式過去問は実施団体の公開ページへご案内します。無料の会員登録をすると、学習の記録を別の端末へ引き継げます。

現在の公開教材

現在公開している記事・一問一答・暗記表・論点整理・オリジナル模試は、 すべて無料です。有料教材を公開するときは、内容と利用期間を事前に明記します。

公開中の記事を見る

内容の根拠

2026年11月20日時点の法令・公表資料基準で作成しています。条文と一般社団法人生成AI活用普及協会(GUGA)の公表資料に当たって確認し、修正した内容は訂正履歴に残します。