分野別・章別に引ける
810項目の暗記表を、
分野から引く。
覚えるべき項目を分野別・章別の表に整理しました。各項目に「覚え方」 「ひっかけ注意」がつき、その場で○×問題に飛べます。ページ内検索 (Ctrl+F / ページ内を検索)でも引けます。
分野別の暗記表
AIの基礎と歴史の要点を、GUGA のシラバスと公表資料・法令に基づく一問一答で確かめます。
113項目8章 →
生成AIの要点を、GUGA のシラバスと公表資料・法令に基づく一問一答で確かめます。
149項目11章 →
AIエージェントの要点を、GUGA のシラバスと公表資料・法令に基づく一問一答で確かめます。
144項目10章 →
生成AIのリスク予防・AI倫理・ガバナンスの要点を、GUGA のシラバスと公表資料・法令に基づく一問一答で確かめます。
294項目21章 →
生成AIの実践と活用事例の要点を、GUGA のシラバスと公表資料・法令に基づく一問一答で確かめます。
110項目8章 →
図で覚える重要論点58枚
スワイプで覚える重要論点を一枚で思い出し、リンク先の要点と○×問題で判断条件まで確認できます。 イメージ暗記カードなら「覚えた/まだ」に仕分けながら反復できます。
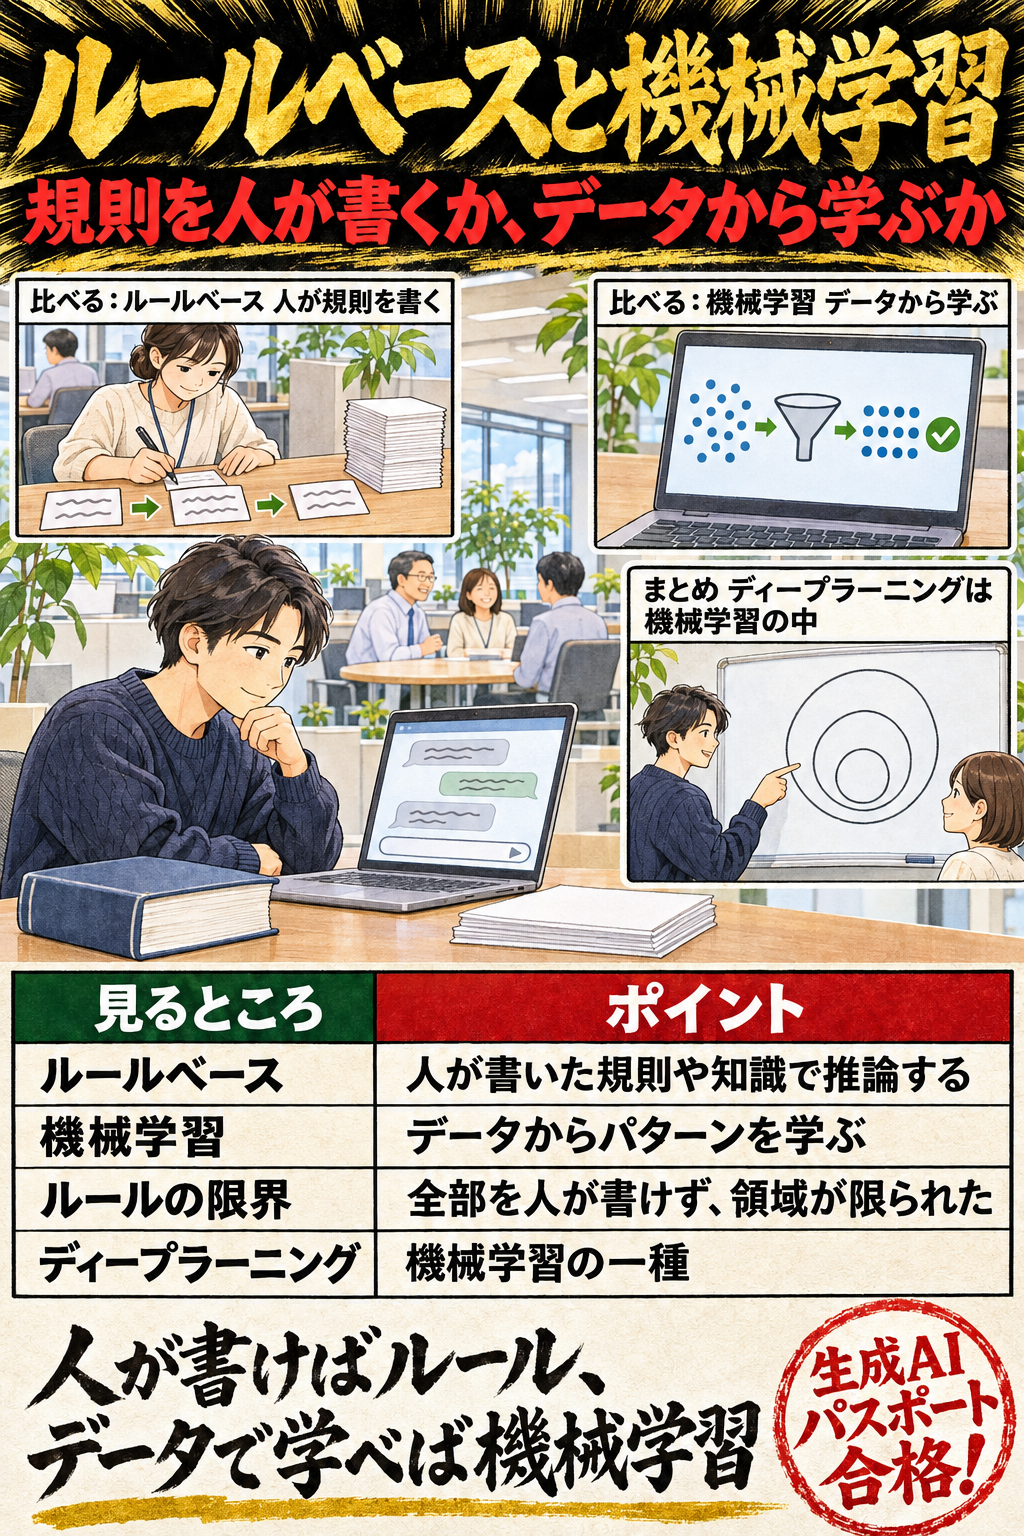
AIには現時点で確立された定義がないこと、AIに知能をもたらす仕組みには、人が規則や知識を書き込んで推論させるルールベース(知識ベース・エキスパートシステム)と、データからパターンを取り出して自ら知識を獲得する機械学習があること、人がすべてを記述するルールベースの限界から機械学習へ発展したことを押さえると解けます。
要点と○×問題へ →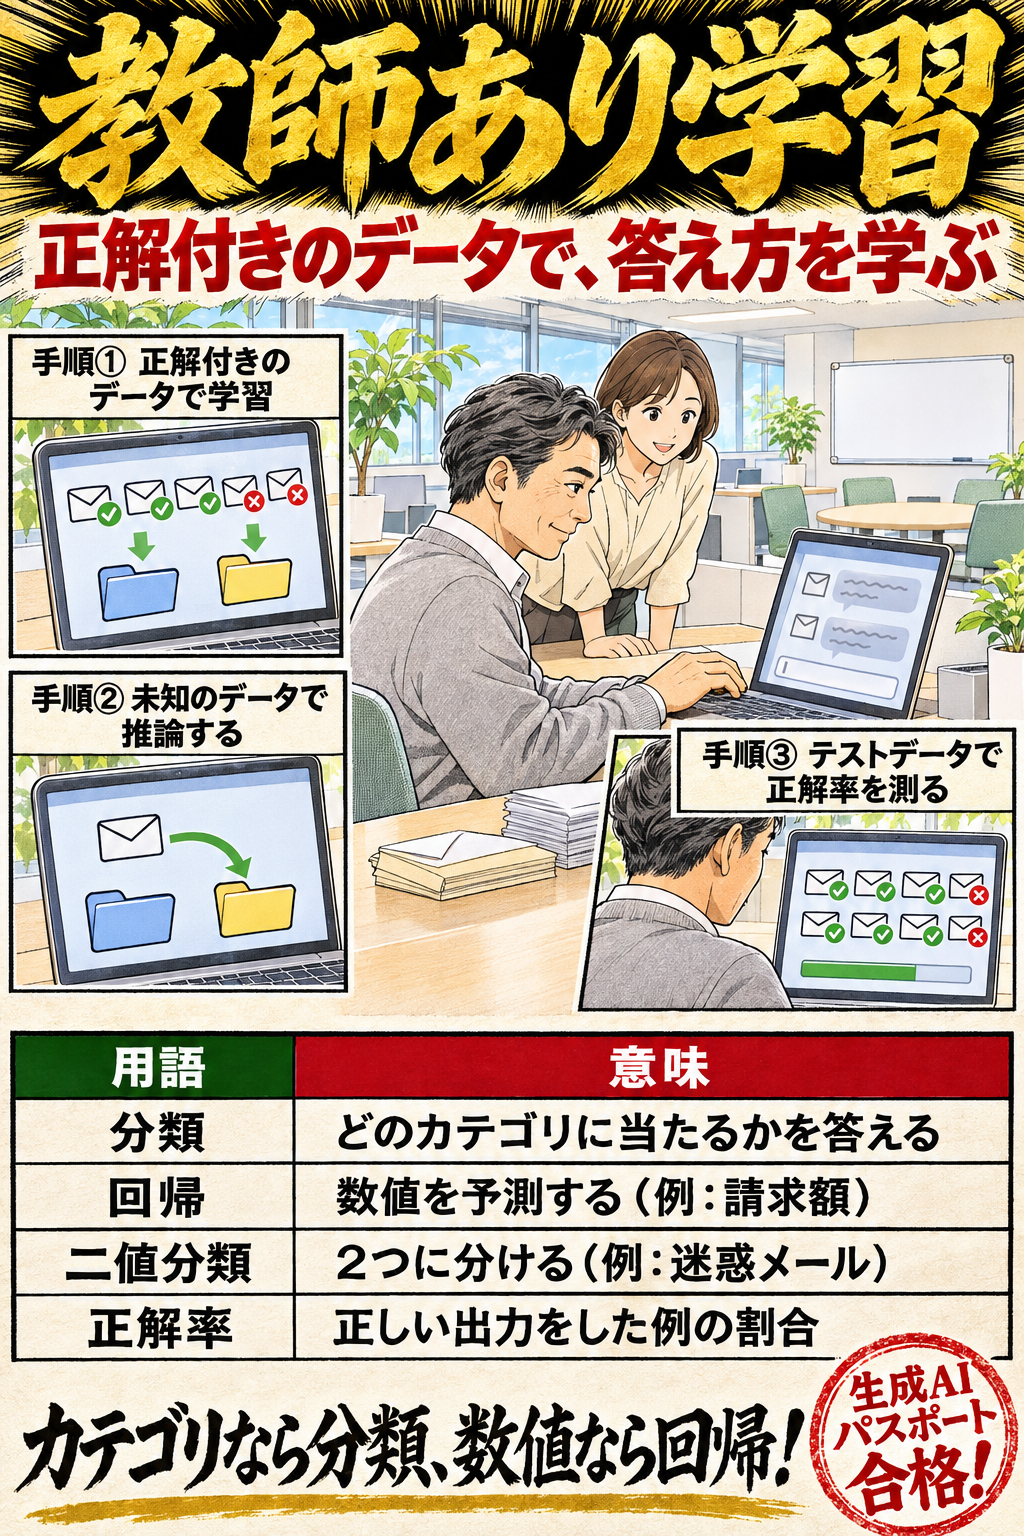
機械学習は、データを使ってAIモデルのパラメータを決める「学習」で学習済みモデルを作り、未知のデータに当てる「推論」で使います。教師あり学習は、正解(ラベル)付きの教師データから入力→正解を予測する方法で、カテゴリを当てる分類(二値分類・多値分類)と数値を当てる回帰があり、性能は学習に使っていないテストデータで正解率などを測ることを押さえると解けます。
要点と○×問題へ →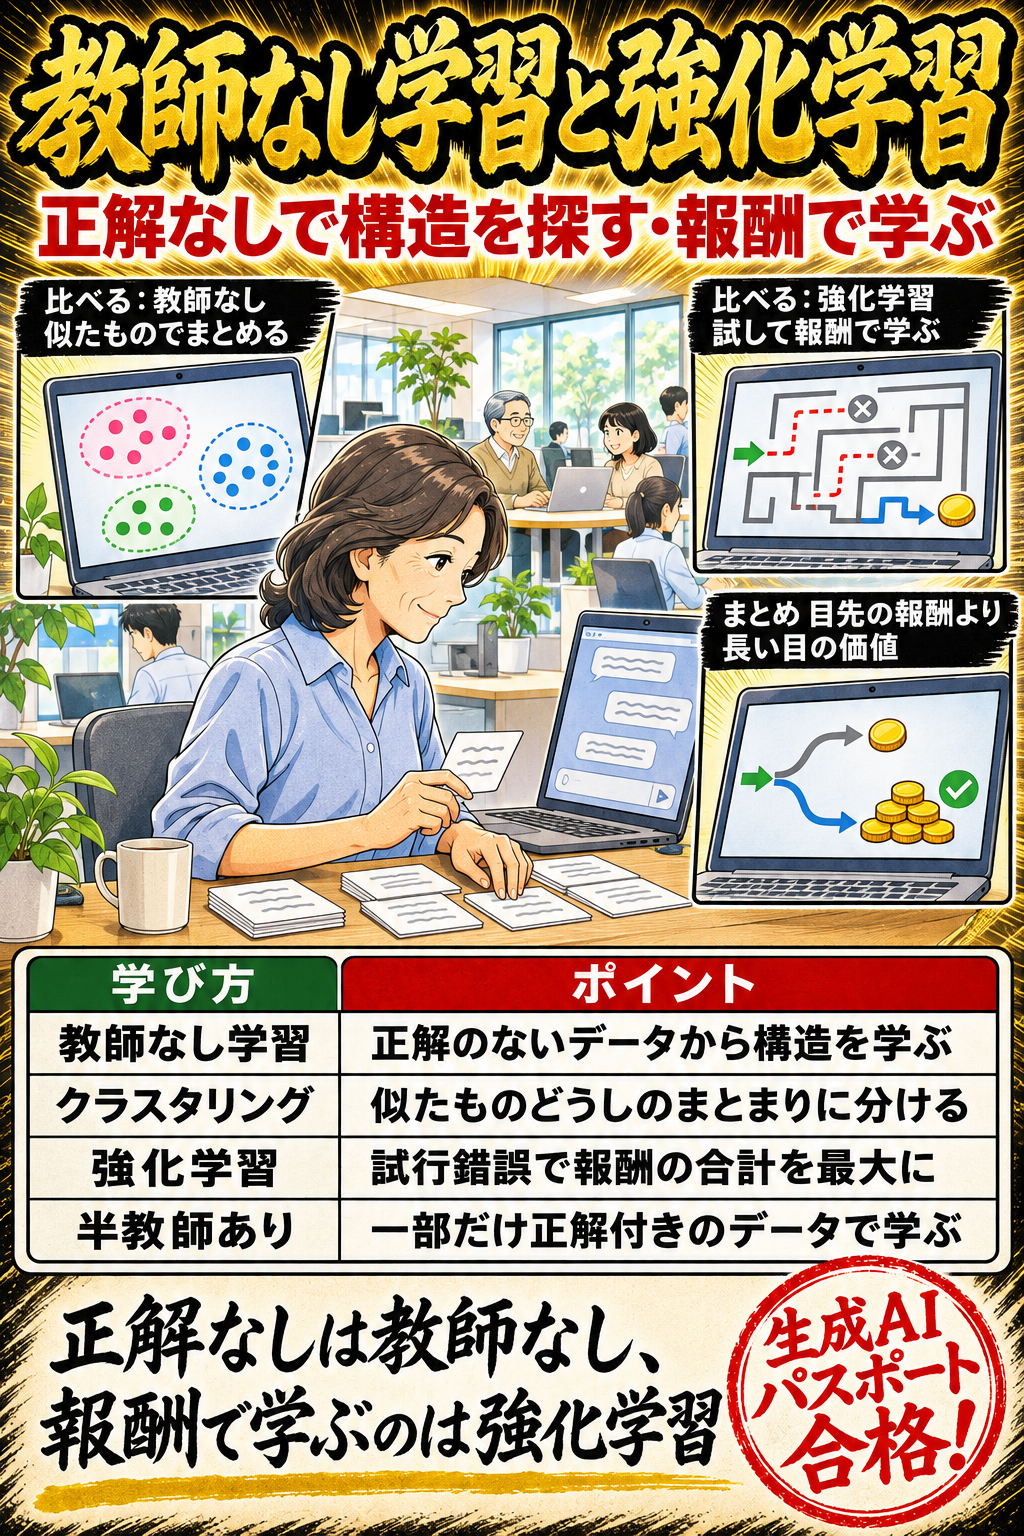
教師なし学習は正解のないデータから構造を見つける方法(似たものをまとめるクラスタリング、次元を減らす次元削減)、強化学習は環境とのやり取りで試行錯誤しながら報酬の合計を最大にする行動の選び方(方策)を学ぶ方法で、行動は目先の報酬ではなく長い目で見た価値で選びます。半教師あり学習は正解付きの少ないデータと正解なしの大量のデータを合わせて使い、ノーフリーランチ定理はどんな課題にも最も良い万能のアルゴリズムはないことを示す、を押さえると解けます。
要点と○×問題へ →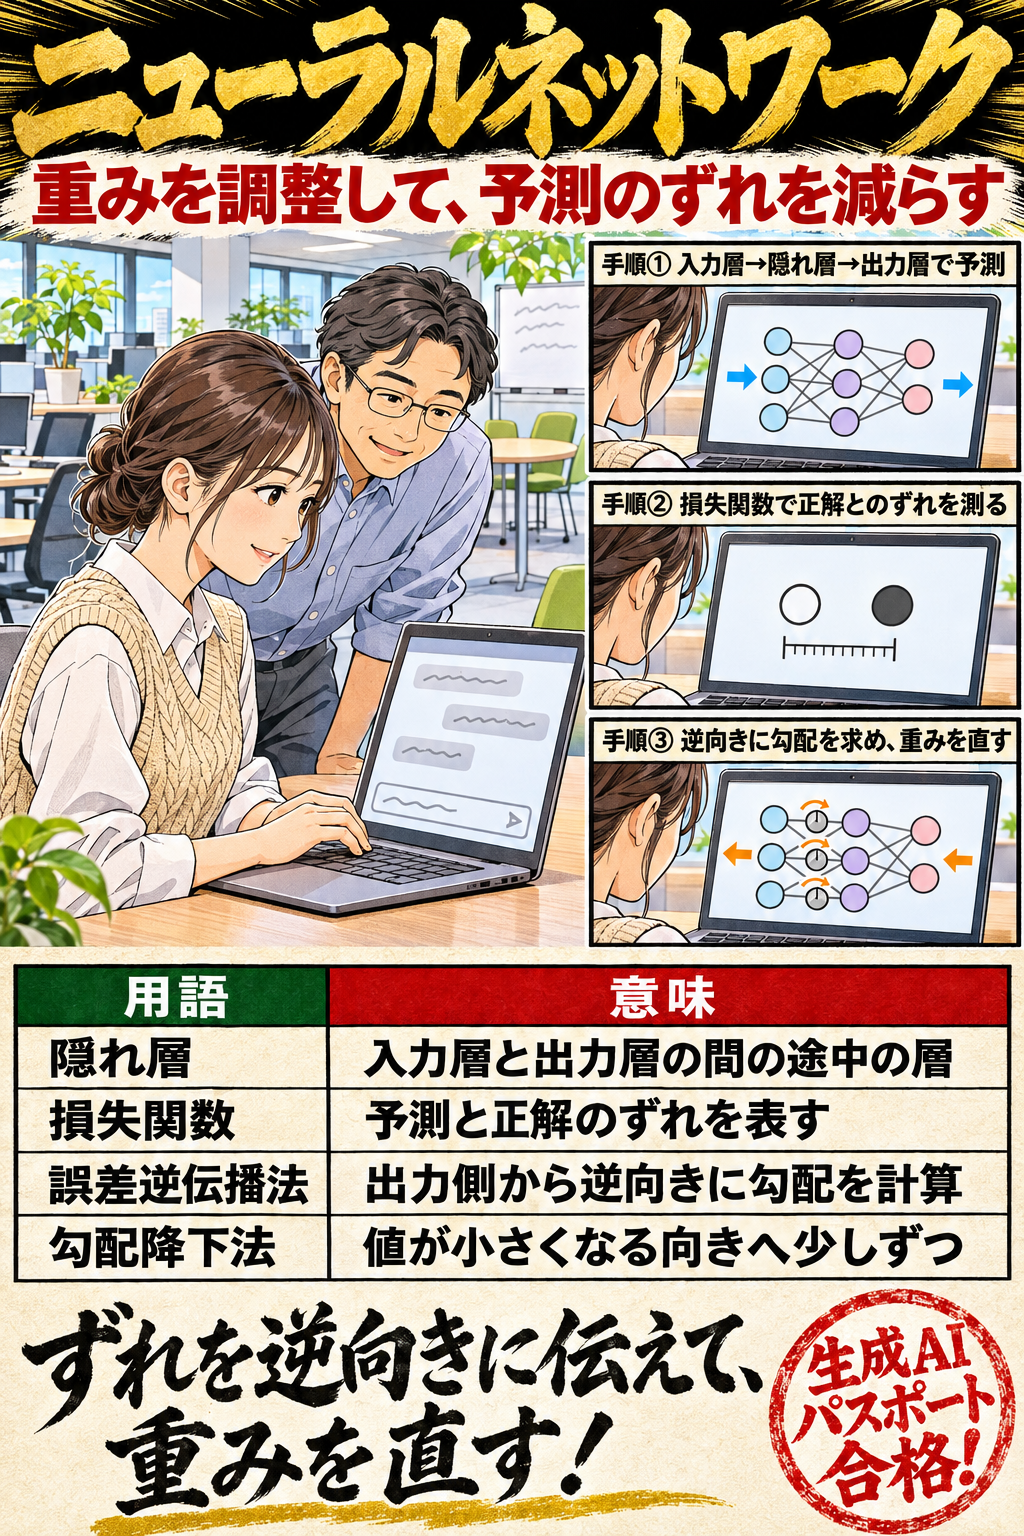
ニューラルネットワークは脳の神経細胞のつながりにおおまかに着想を得た仕組みで(脳の正確な模型ではない)、入力層・隠れ層・出力層からなり、層を深く重ねたものがディープラーニング(特徴量を自ら学ぶ)です。学習では、予測と正解のずれを表す損失関数が小さくなるよう、誤差逆伝播法で求めた勾配を使い、勾配降下法で重みを少しずつ調整することを押さえると解けます。
要点と○×問題へ →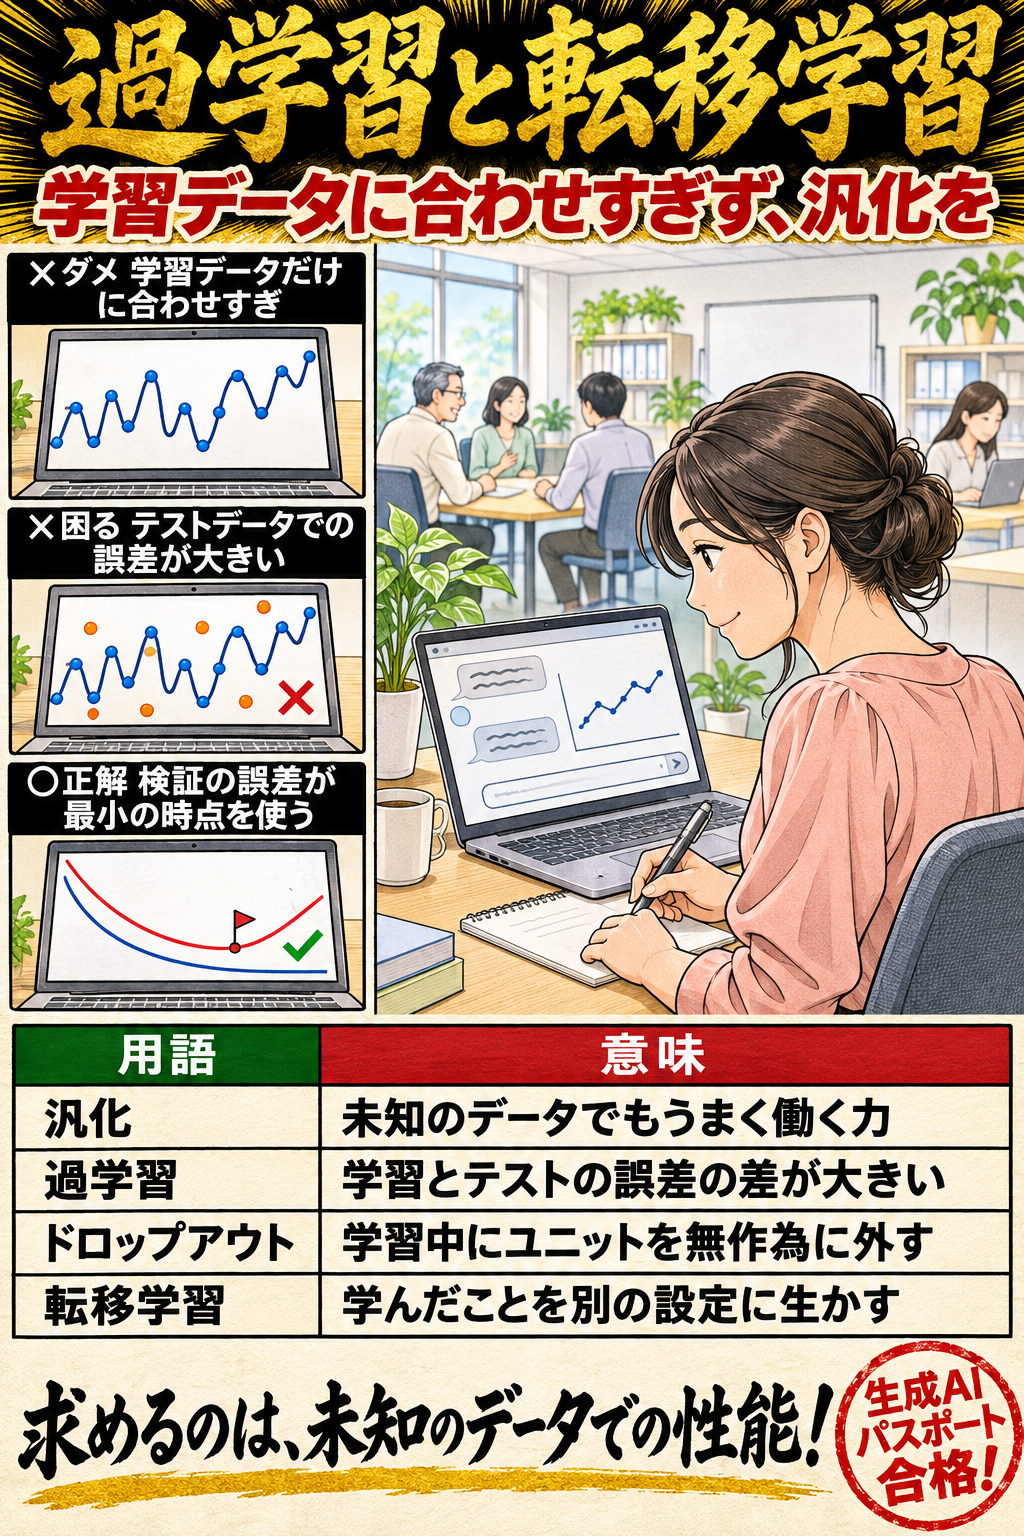
汎化は学習に使っていない未知のデータでもうまく働く能力で、過学習は学習データでの誤差とテストデータでの誤差の差が大きくなりすぎた状態です。対策のアーリーストッピング(検証データの誤差が最も小さい時点を使う)・正則化(汎化誤差を減らす工夫の総称。重みの罰則など)・ドロップアウト(学習中にユニットを無作為に外す)の違いと、ある課題で学んだことを別の課題に生かす転移学習、学習済みモデルを用途に合わせて追加で学習させるファインチューニングを押さえると解けます。
要点と○×問題へ →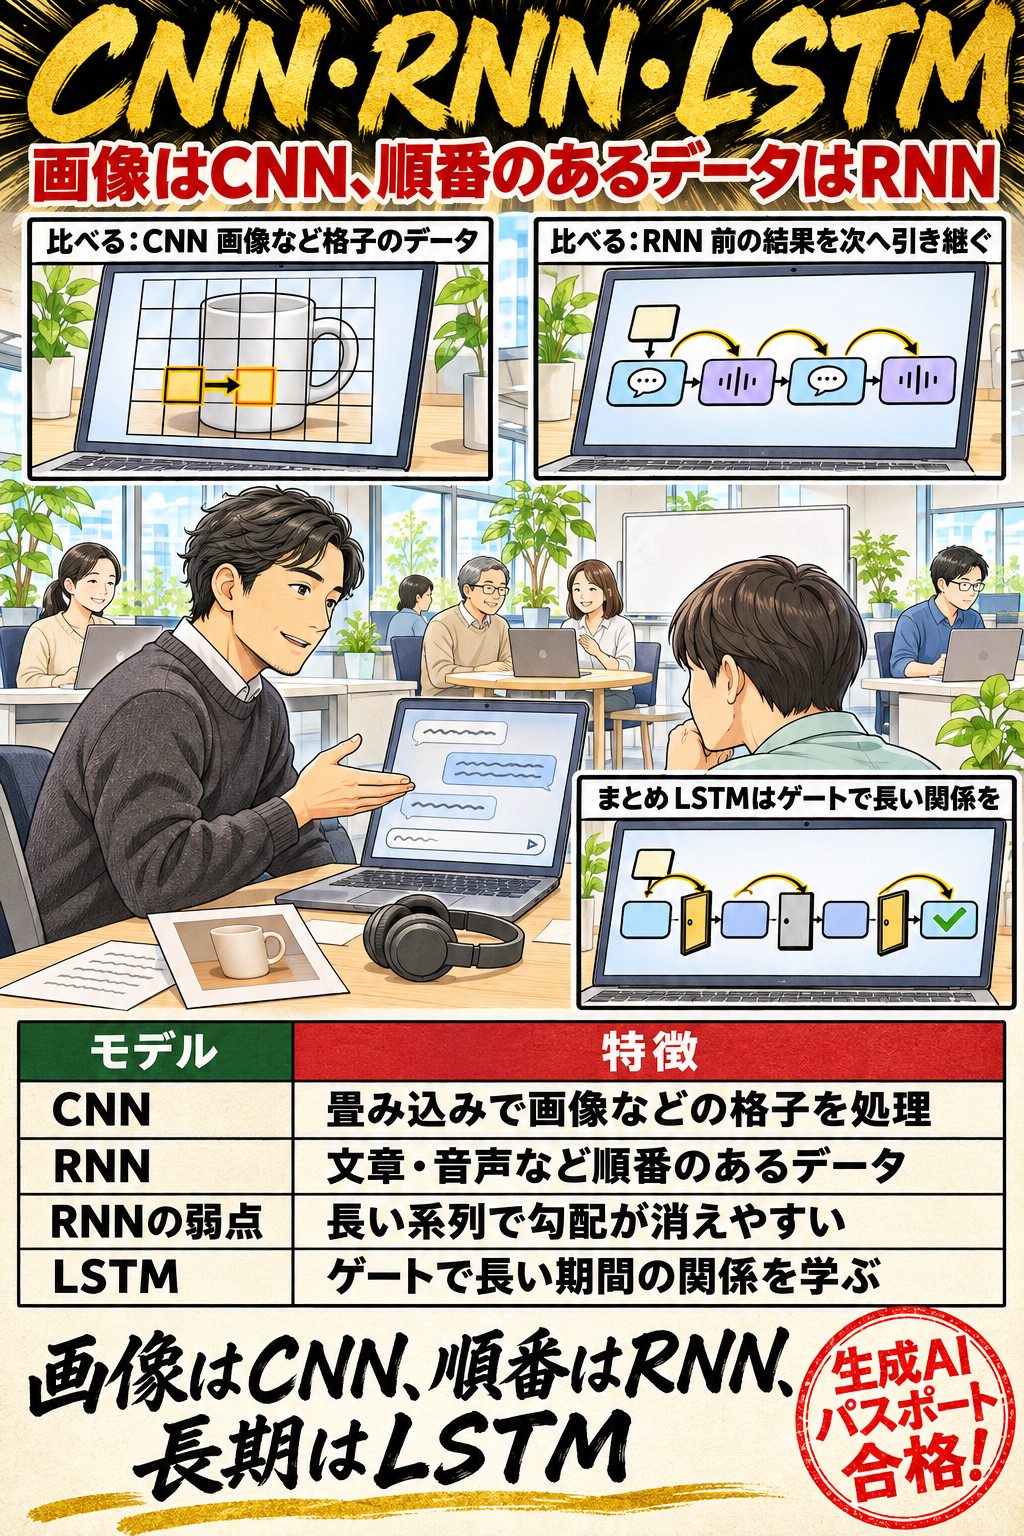
CNN(畳み込みニューラルネットワーク)は画像のような格子状のデータを畳み込みという演算で処理し、物体認識などのコンピュータビジョンで成果を上げました。RNN(再帰型ニューラルネットワーク)は文章や音声のような順番のあるシーケンスデータを、前の時点の計算結果を引き継いで処理しますが、長い系列では勾配消失問題・勾配爆発問題が起きやすく、LSTMはゲートで情報の出し入れを調整してこれを和らげました。Transformerは再帰も畳み込みも使わず、系列の中の関係をAttentionでとらえます。
要点と○×問題へ →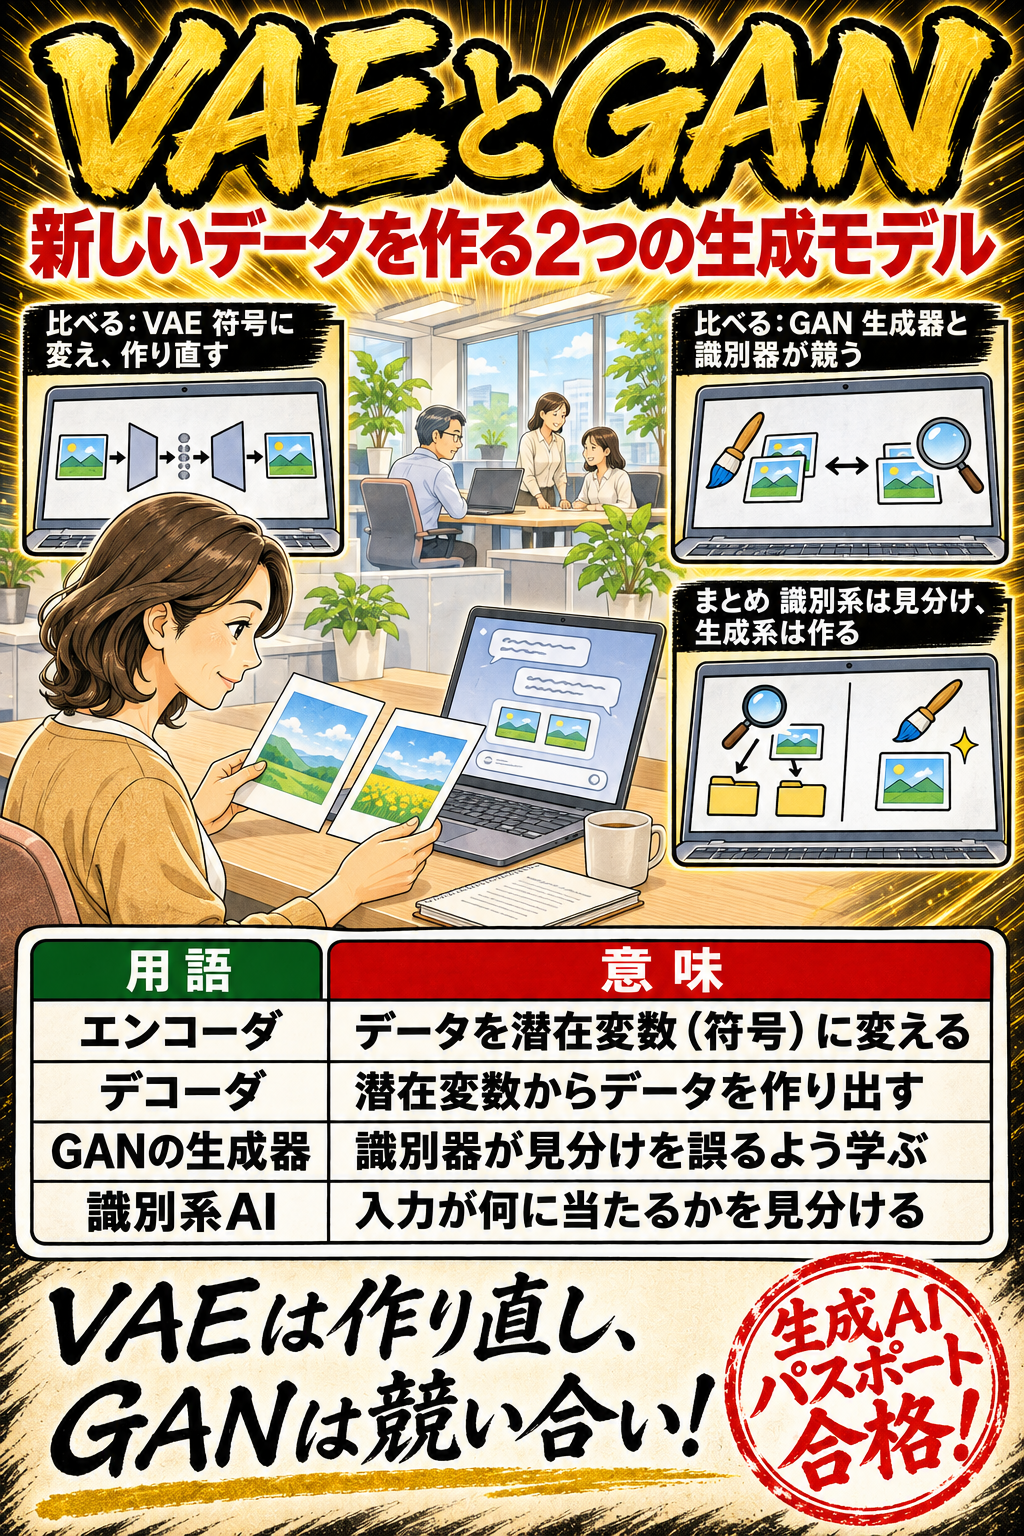
VAE(変分オートエンコーダ)は、エンコーダで入力を潜在変数(潜在ベクトル)の分布に写し、デコーダでデータに戻すように学ぶ生成モデルで、生成するときは潜在変数の分布から取り出した値をデコーダに通します。GAN(敵対的生成ネットワーク)は、本物らしいデータを作る生成器と、本物か生成されたものかを見分ける識別器を競わせて学びます。入力が何かを見分け・予測する識別系AIと、新しいデータを作る生成系AIの違い、生成AIの悪用であるディープフェイクを押さえると解けます。
要点と○×問題へ →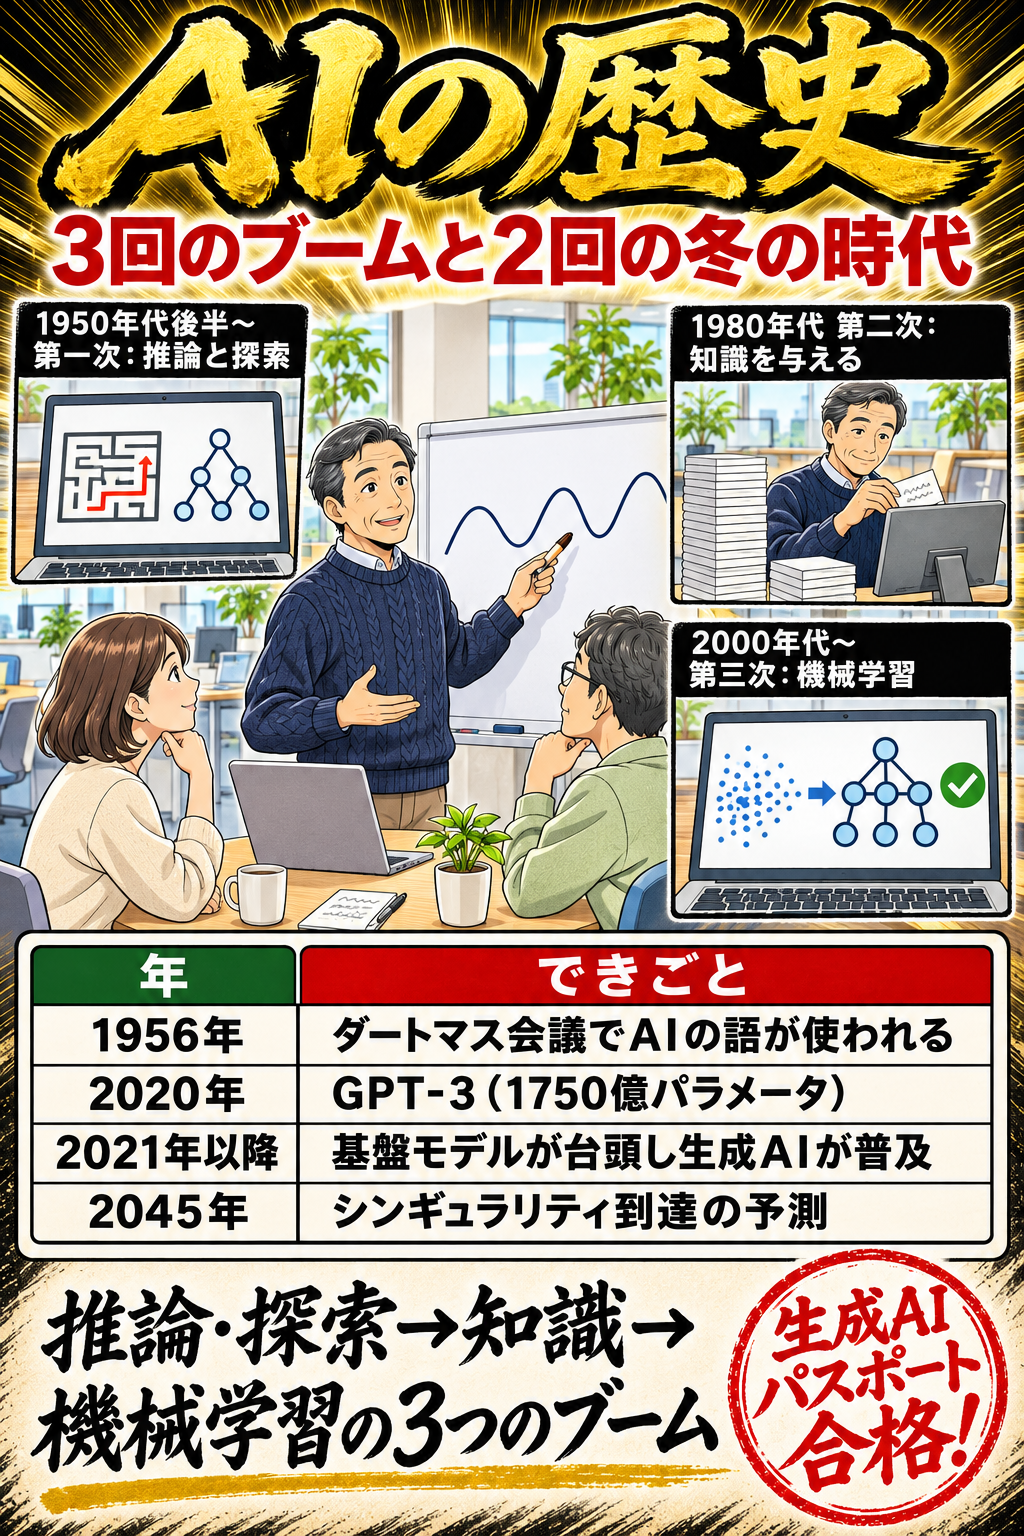
AIという言葉がダートマスの研究会(1955年の提案書・1956年夏の開催)から使われ始めたこと、第一次ブーム(1950年代後半〜1960年代・探索と推論)、第二次ブーム(1980年代・知識とエキスパートシステム)、第三次ブーム(2000年代〜・ビッグデータと機械学習、次いでディープラーニング)とその間の冬の時代、2017年のTransformerから大規模言語モデル(LLM)や拡散モデルによる生成AIへ進んだ流れを出来事の順で押さえ、カーツワイルが2045年に到達すると予測したシンギュラリティと、それに対する総務省の研究会(2015年)の見方を知っておくと解けます。
要点と○×問題へ →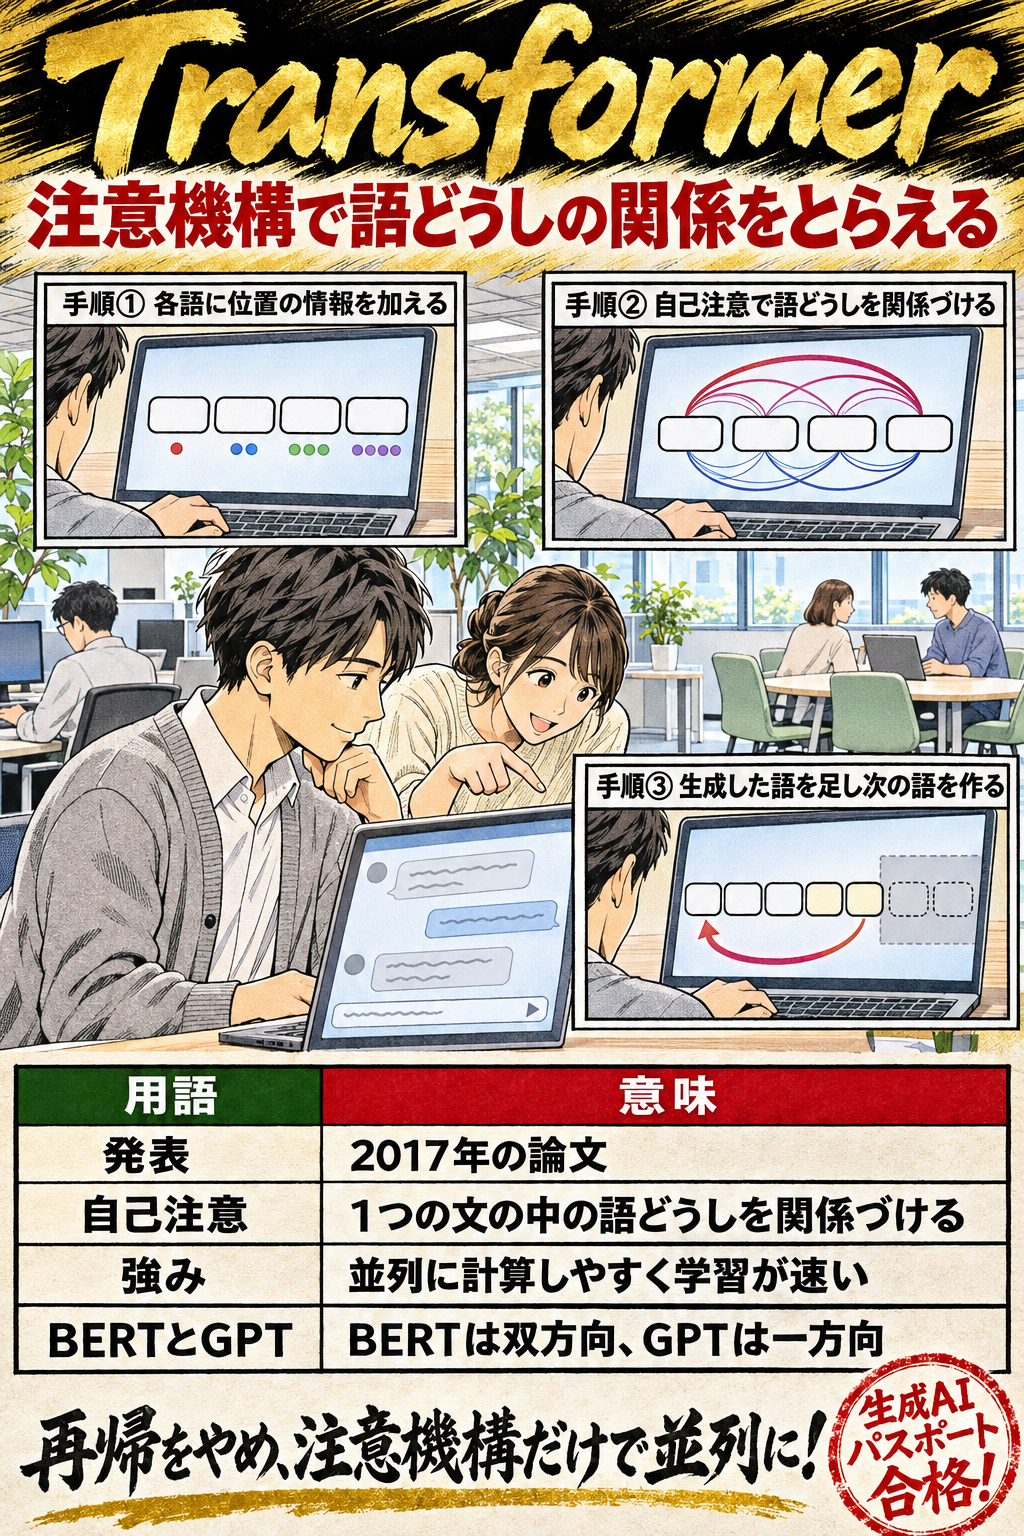
Transformer は、文中の語どうしの関係を扱うのに、再帰(RNN)や畳み込みの代わりに注意機構(どの語とどの語が関係するかを重みで表す仕組み)を使うモデルです。自己注意で文中の語どうしを直接結ぶので、並列に計算しやすく、離れた語の関係(長距離依存)も捉えやすくなりました。Query・Key・Value の役割、エンコーダとデコーダの分担、GPT など後のモデルへのつながりを押さえると解けます。
要点と○×問題へ →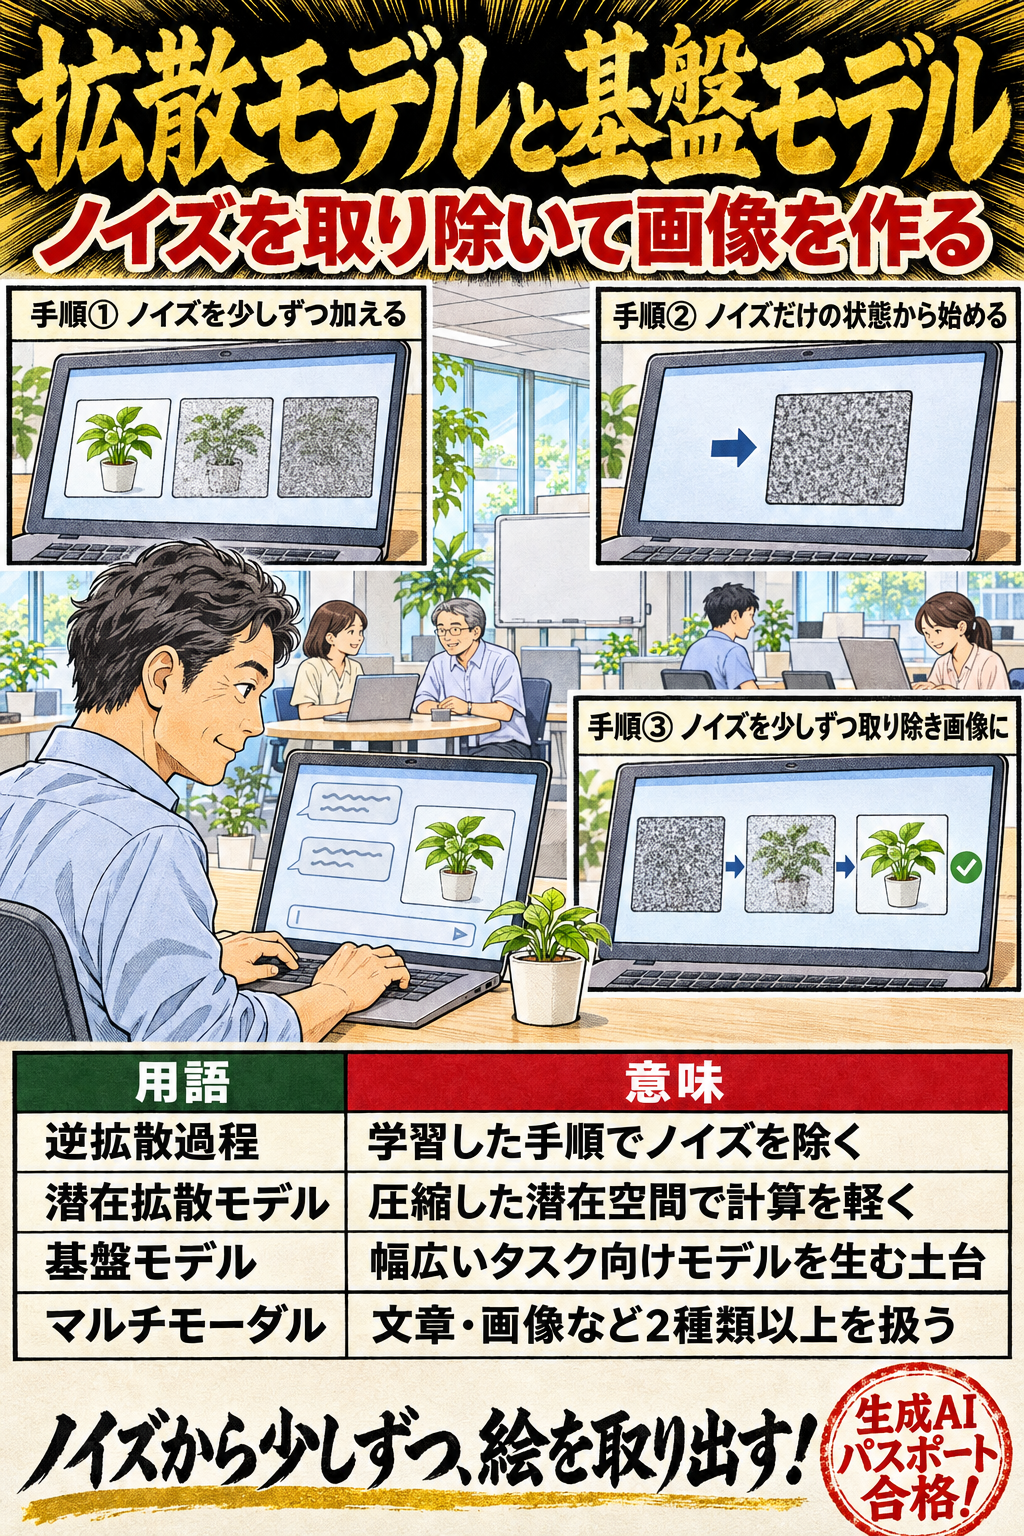
拡散モデルは、データに少しずつノイズを加える拡散過程と、その逆をたどってノイズから画像を作る逆拡散過程からなり、潜在拡散モデルは画像を圧縮した潜在空間で計算を軽くしました。基盤モデルは多くの個別のモデルを生み出す土台で、マルチモーダルモデルは2つ以上のデータの種類(モダリティ)を統合して扱う、と押さえると解けます。
要点と○×問題へ →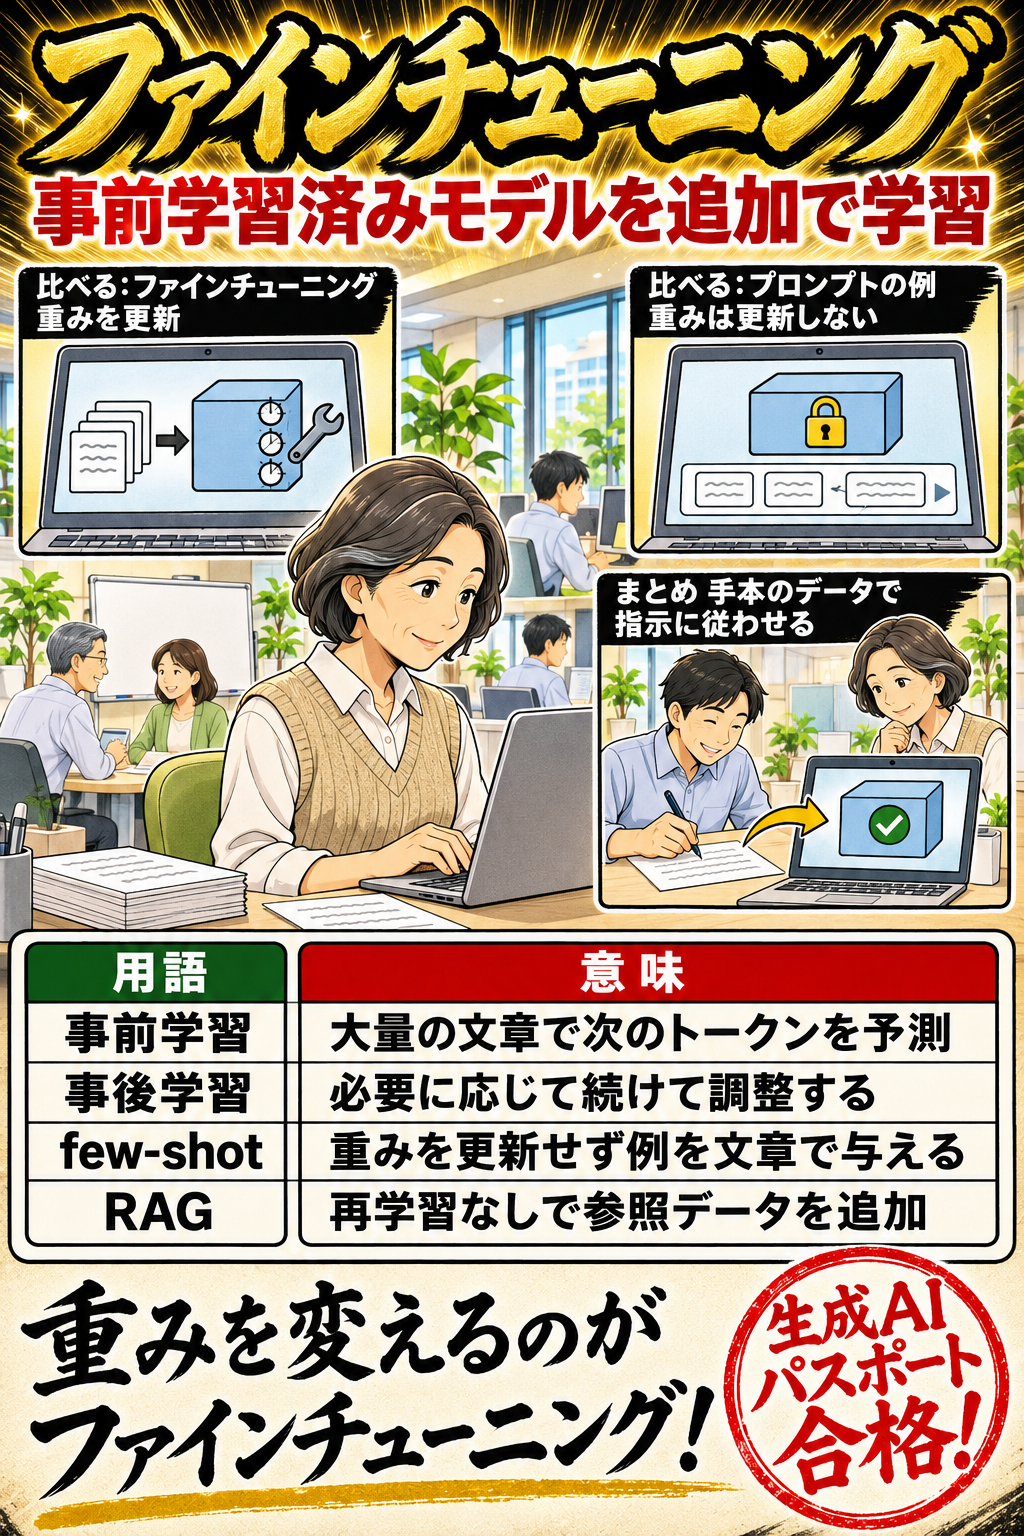
大規模言語モデルは、まず大量の文章で次に来るトークン(語のかけら)を予測する事前学習を行い、そのあと追加の学習で重みを調整するファインチューニング(正解付きの手本のデータで学ぶ方法や、人のフィードバックを使う方法など)で用途や指示に合わせます。ファインチューニング(モデルの重みを更新する)と、プロンプトに例や指示を書くだけのコンテキスト内学習(重みを更新しない)を区別すると解けます。
要点と○×問題へ →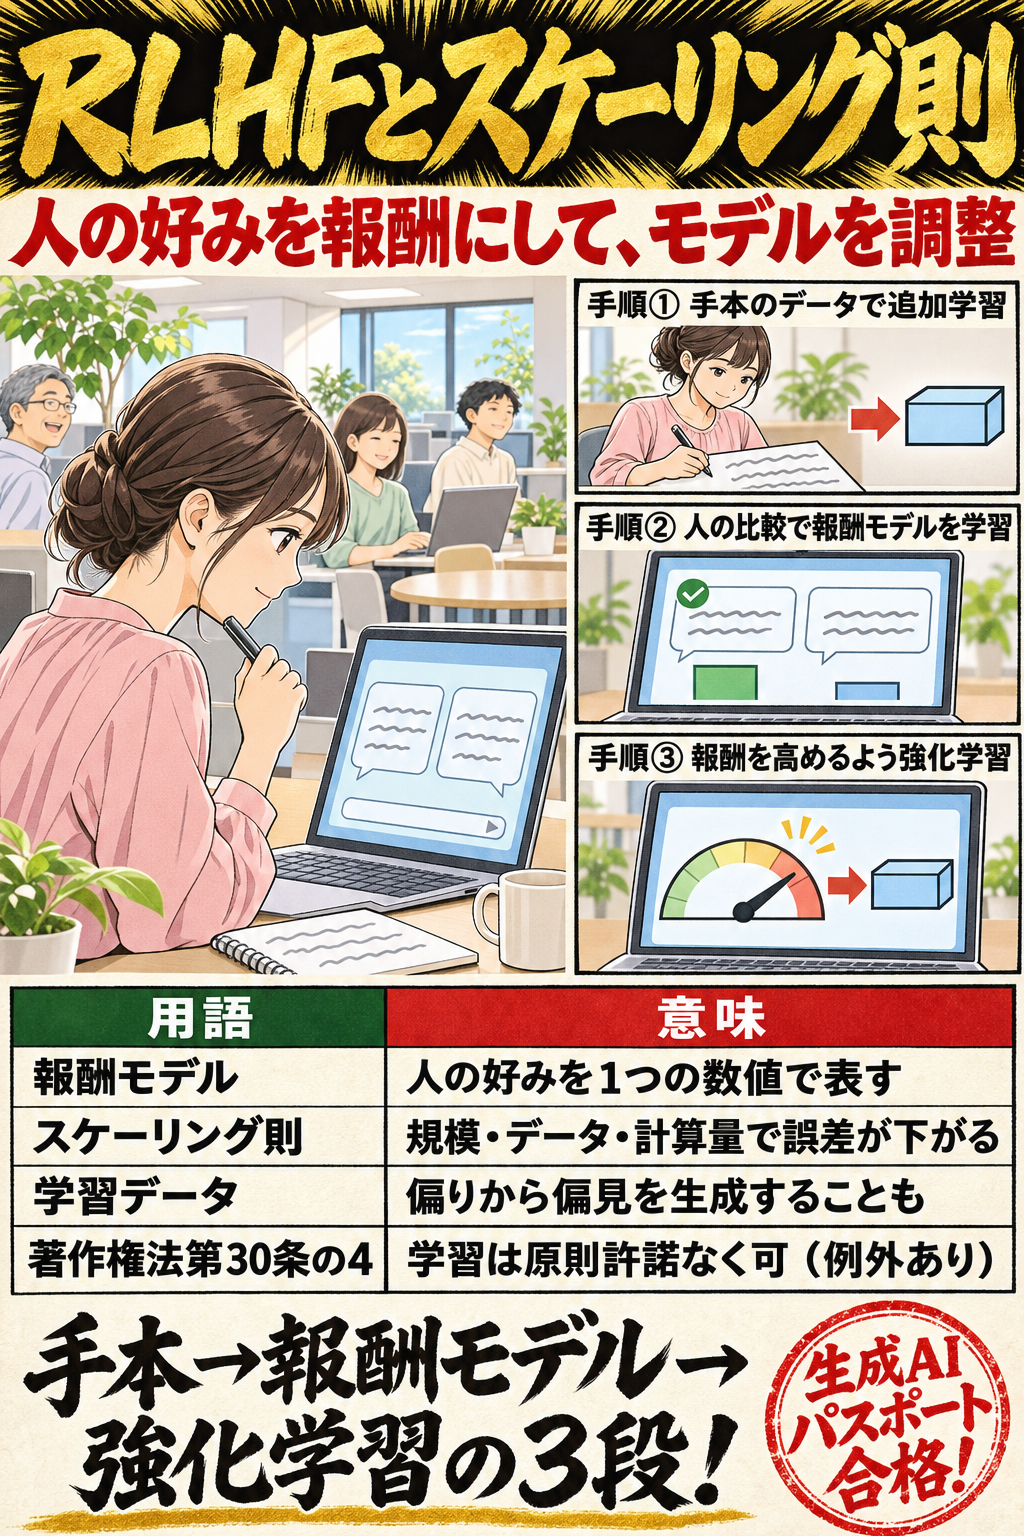
RLHF(人間のフィードバックによる強化学習)は、人が出力を比べて順位を付けたデータで報酬モデルを学習し、その報酬が高くなるよう強化学習でモデルを調整する方法です。学習データは量だけでなく品質・偏り(バイアス)・評価用データの混入・著作権が課題になります。スケーリング則は、ほかが足かせにならない条件で、モデル・データ・計算量を大きくすると誤差がべき乗則に従って下がるという経験則、と押さえると解けます。
要点と○×問題へ →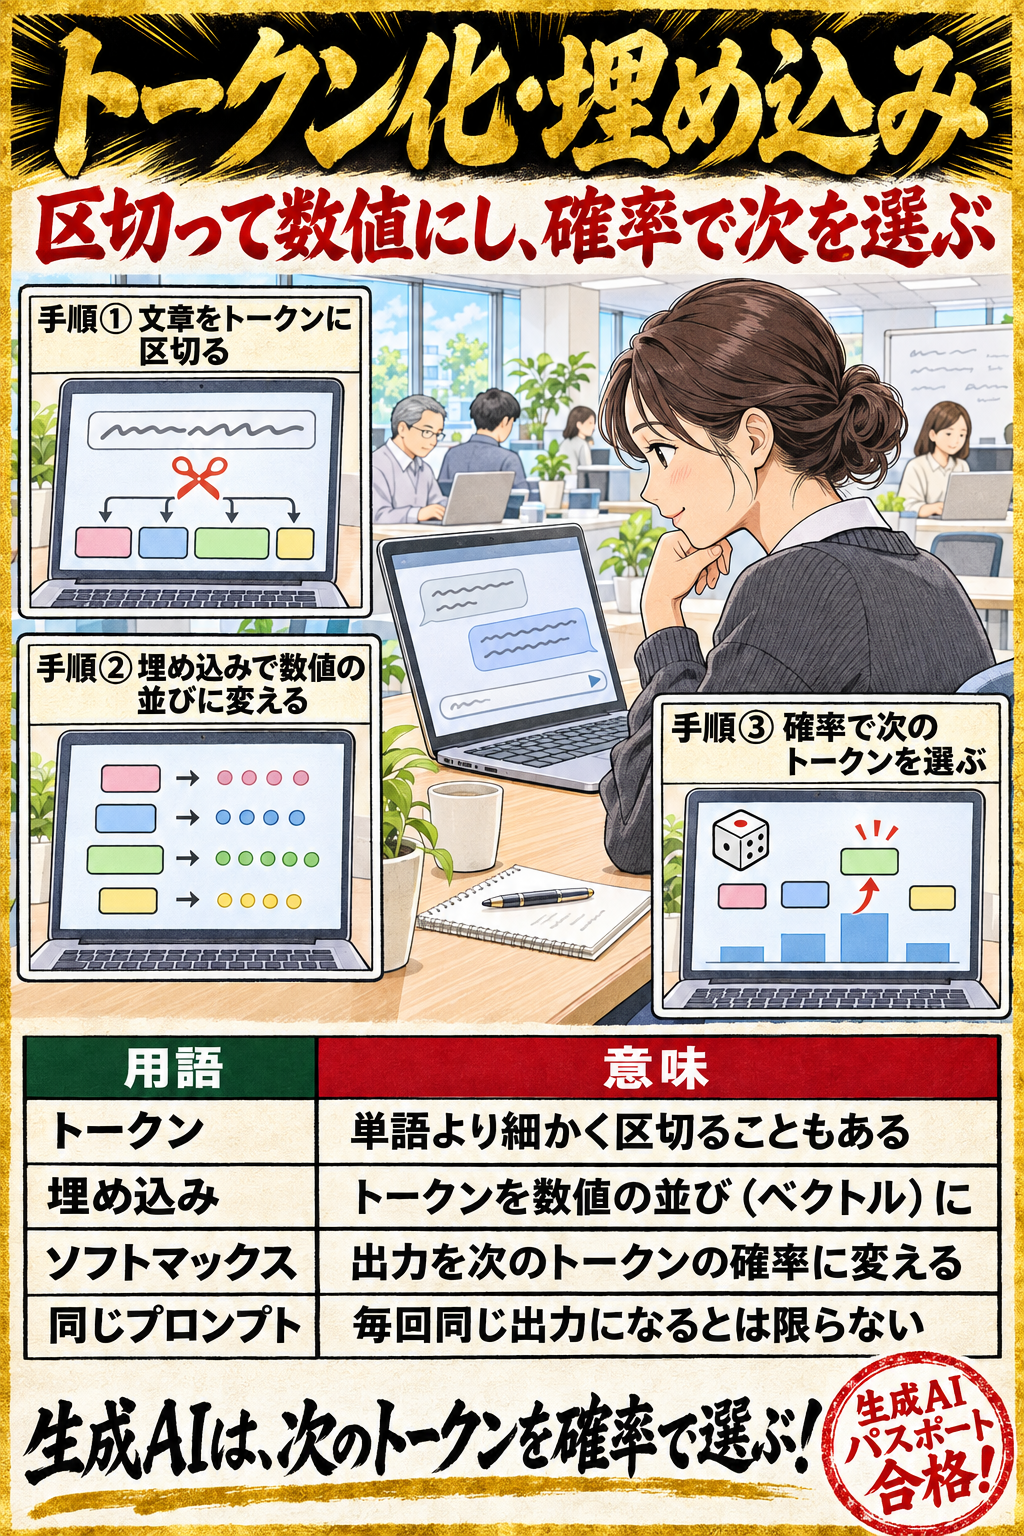
生成AIは、文章をトークン(単語や、単語より細かいサブワードなどの単位)に区切り、各トークンを埋め込みで数値の並び(ベクトル)に変え、次に来るトークンの確率を計算して1つずつ選びながら文章を作ります。確率にもとづいて選ぶため、同じ入力でも出力が変わりうることを押さえると解けます。
要点と○×問題へ →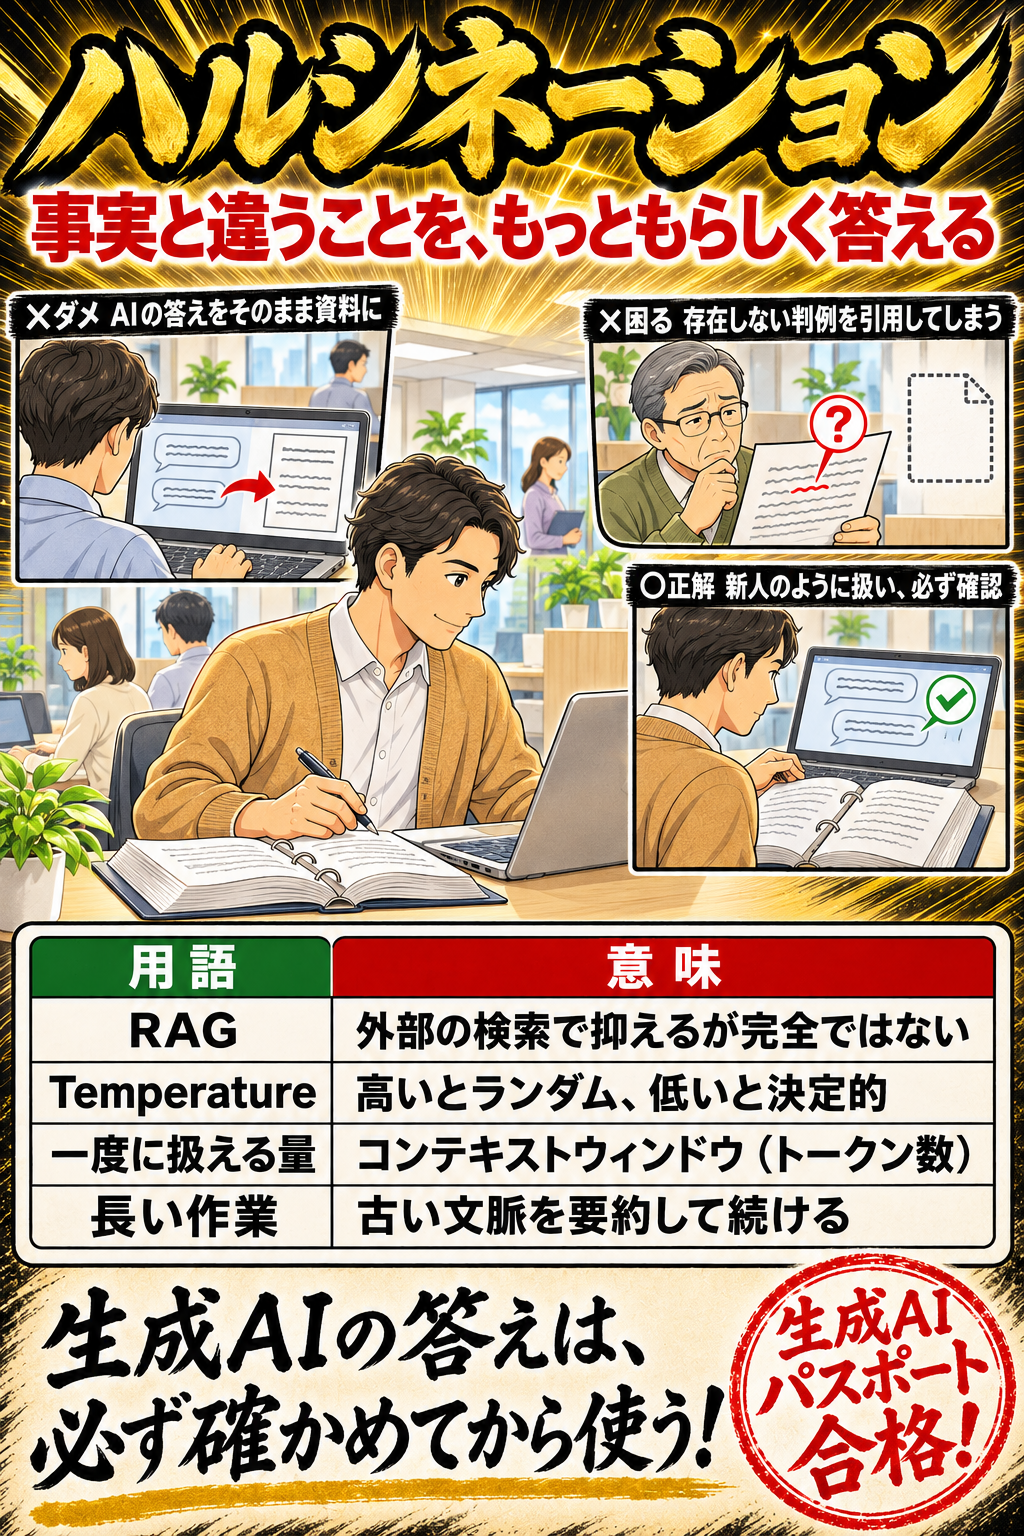
ハルシネーションは、生成AIが事実と異なることをもっともらしく答える現象で、完全に防ぐ方法はまだ分かっていません。RAG で外部の情報を補うと抑制や根拠の明示が期待できます。Temperature や Top-p はトークンの選び方を調整する生成パラメータで、使えるかはモデルによります。コンテキストウィンドウは一度に扱える量の上限(トークンで数える)、と押さえると解けます。
要点と○×問題へ →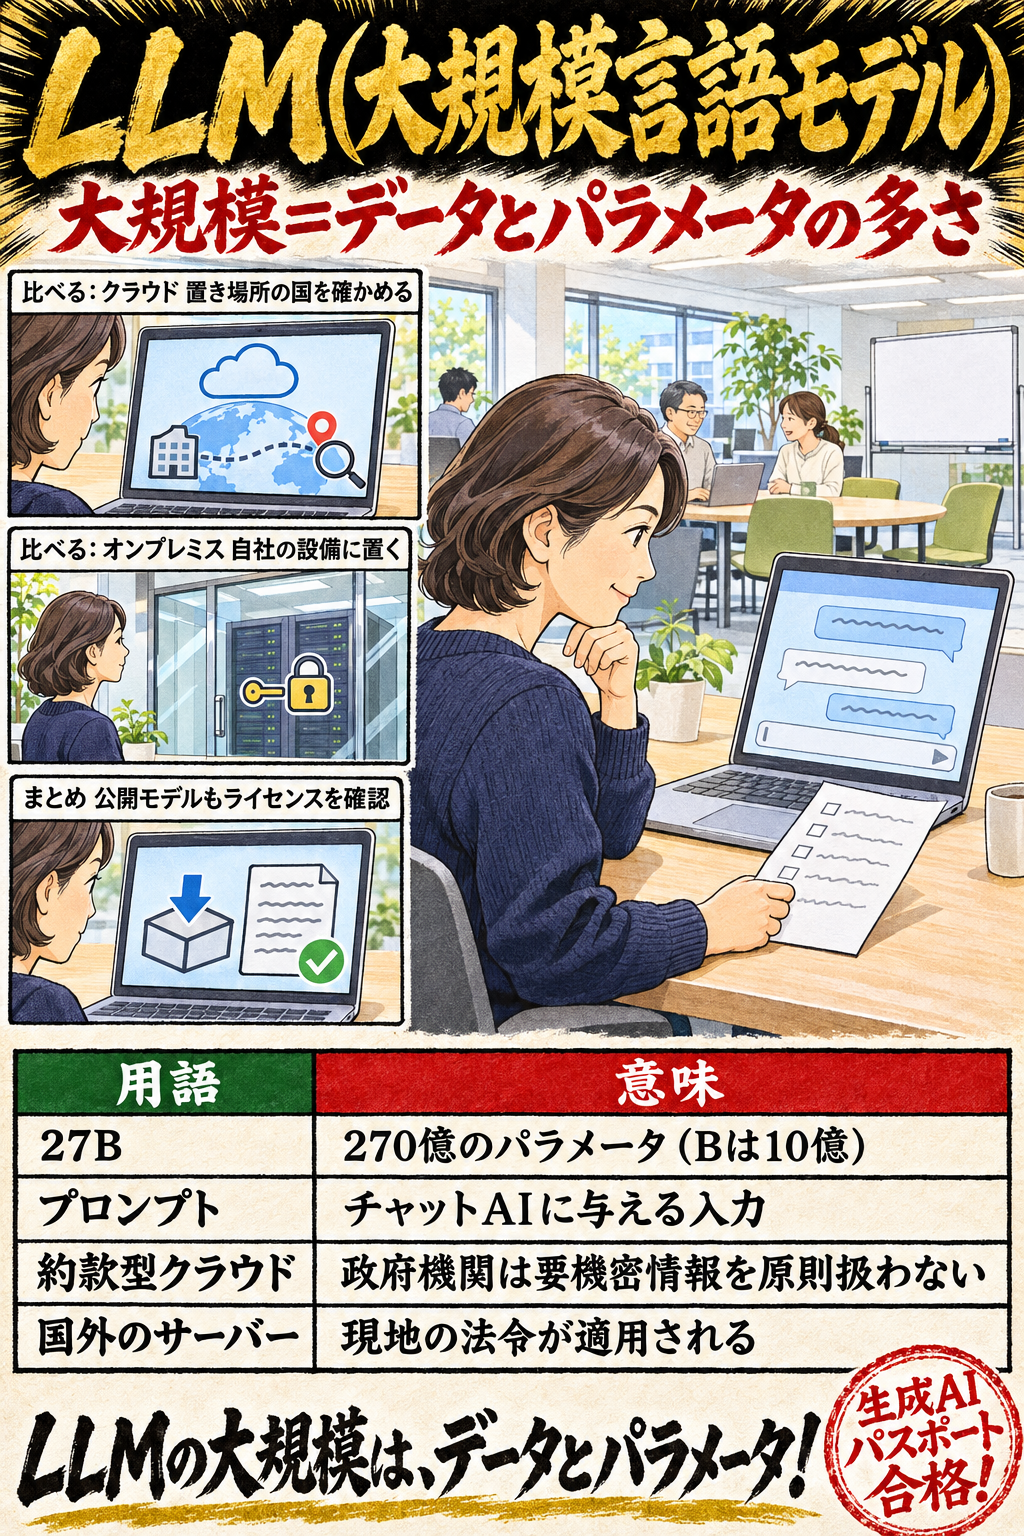
言語モデル(LM)は文章や単語の出現確率を扱うモデルで、それを非常に大量のデータで構築したものが大規模言語モデル(LLM)です。LLM はプロンプト(指示文)で翻訳・要約などさまざまなタスクをこなせます。クラウド型とオンプレミス型の違い(データをどこで扱うか・どの国の法令が適用されるか)と、公開されたモデルを使うときのライセンスと入手経路の確認を押さえると解けます。
要点と○×問題へ →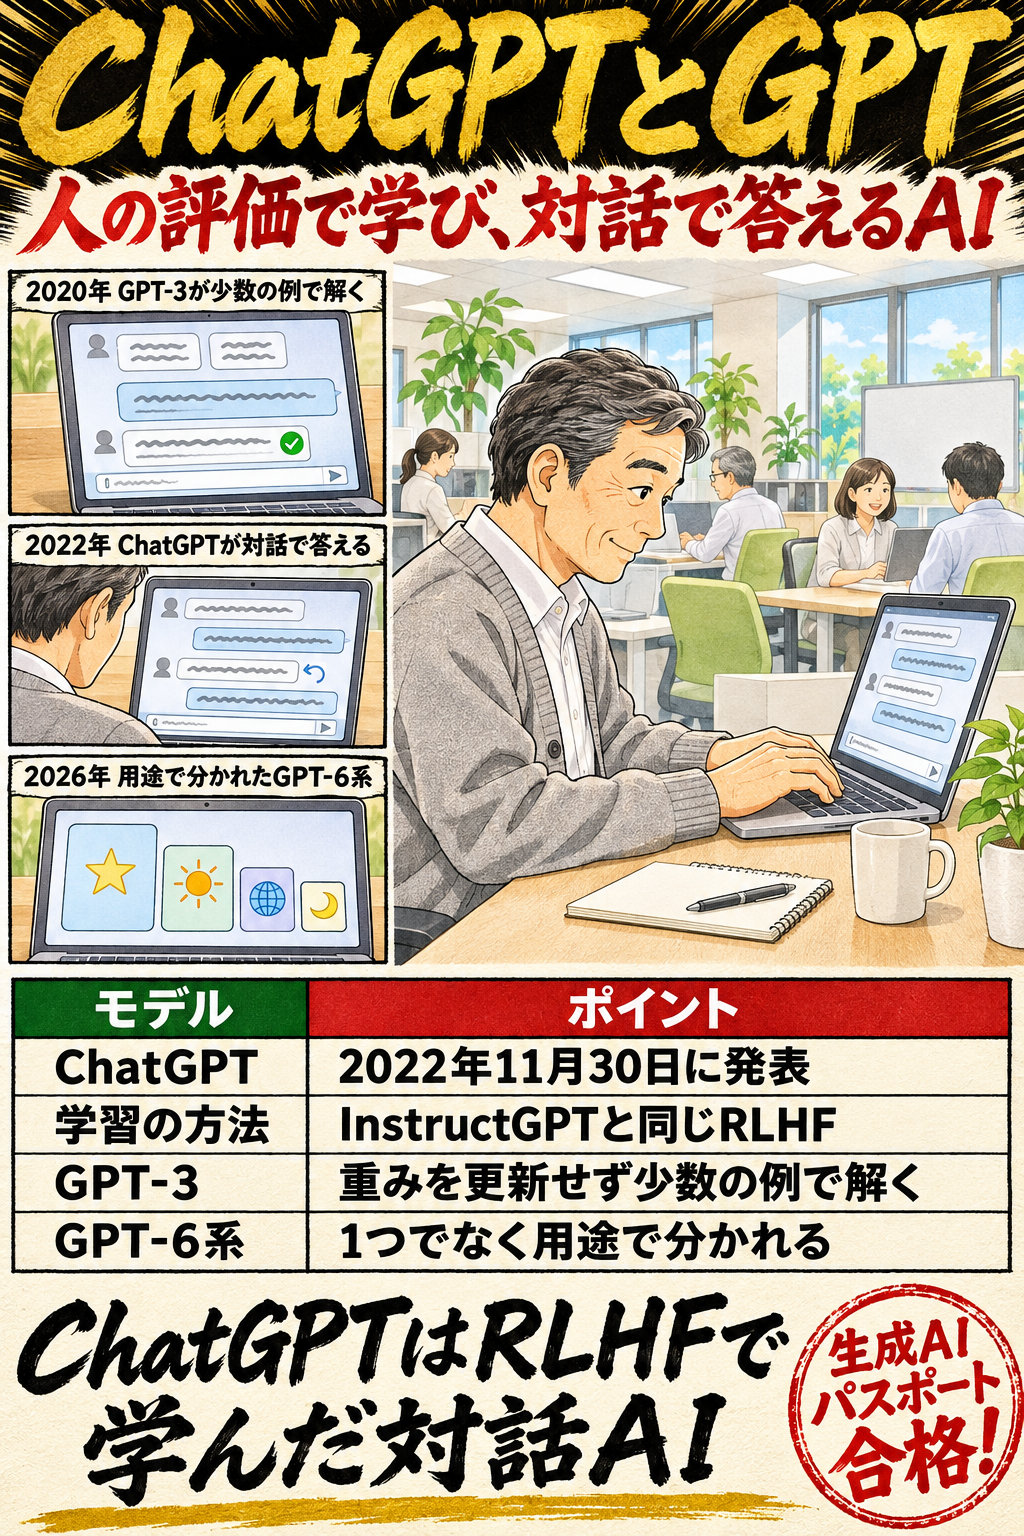
ChatGPT は OpenAI の対話型の生成AIです。GPT シリーズは、GPT-2 の構造を受け継いで規模を大きくした GPT-3、人のフィードバックで調整した InstructGPT、推論モデルを経て GPT-6 系へ進みました。2026年11月時点では GPT-6 系が用途ごとのモデル(最上位の Astra など)に分かれ、後継の GPT-6.2 Astra も出ていること、ChatGPT で使えるモデルと API のモデルは別に管理されることを押さえると解けます。
要点と○×問題へ →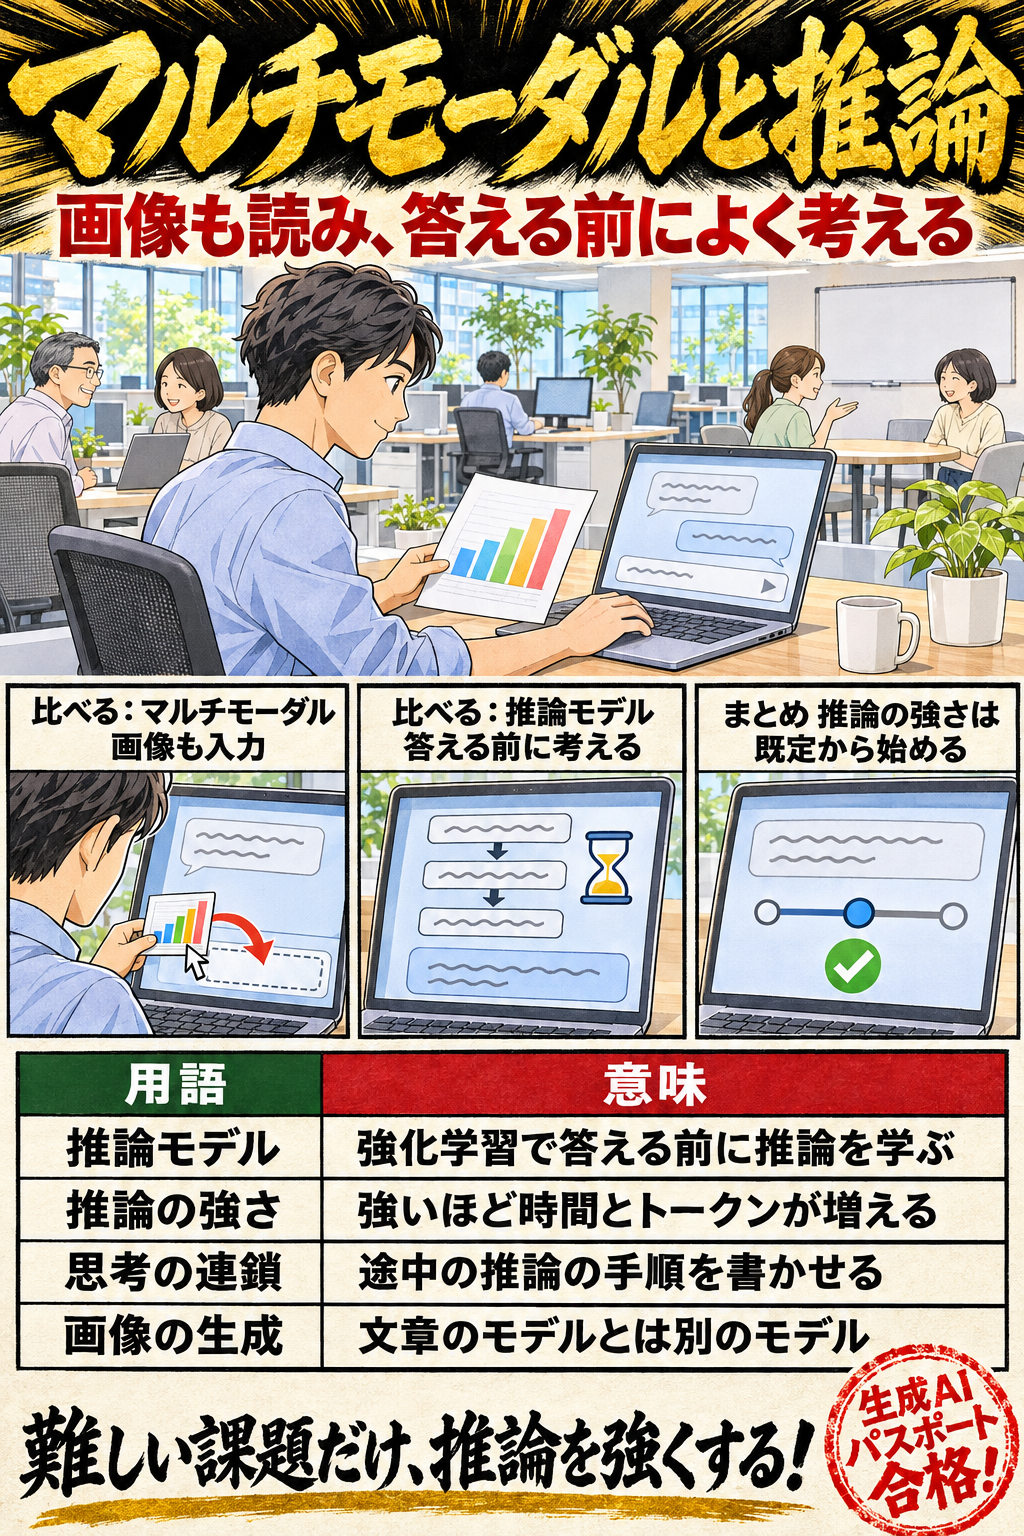
GPT シリーズは2024年に画像の入力や音声の入出力に対応したモデルが加わり、マルチモーダル化が進みました。2024年の o1 からは、強化学習で複雑な推論を行うよう学習した推論モデルが登場し、答える前に考える量(推論の強さ)を増やすほど難しい課題の結果がよくなりうる一方、時間とトークンが増えます。各社のモデルが何を入力・出力できるか、思考の連鎖(途中の手順を書かせる)を押さえると解けます。
要点と○×問題へ →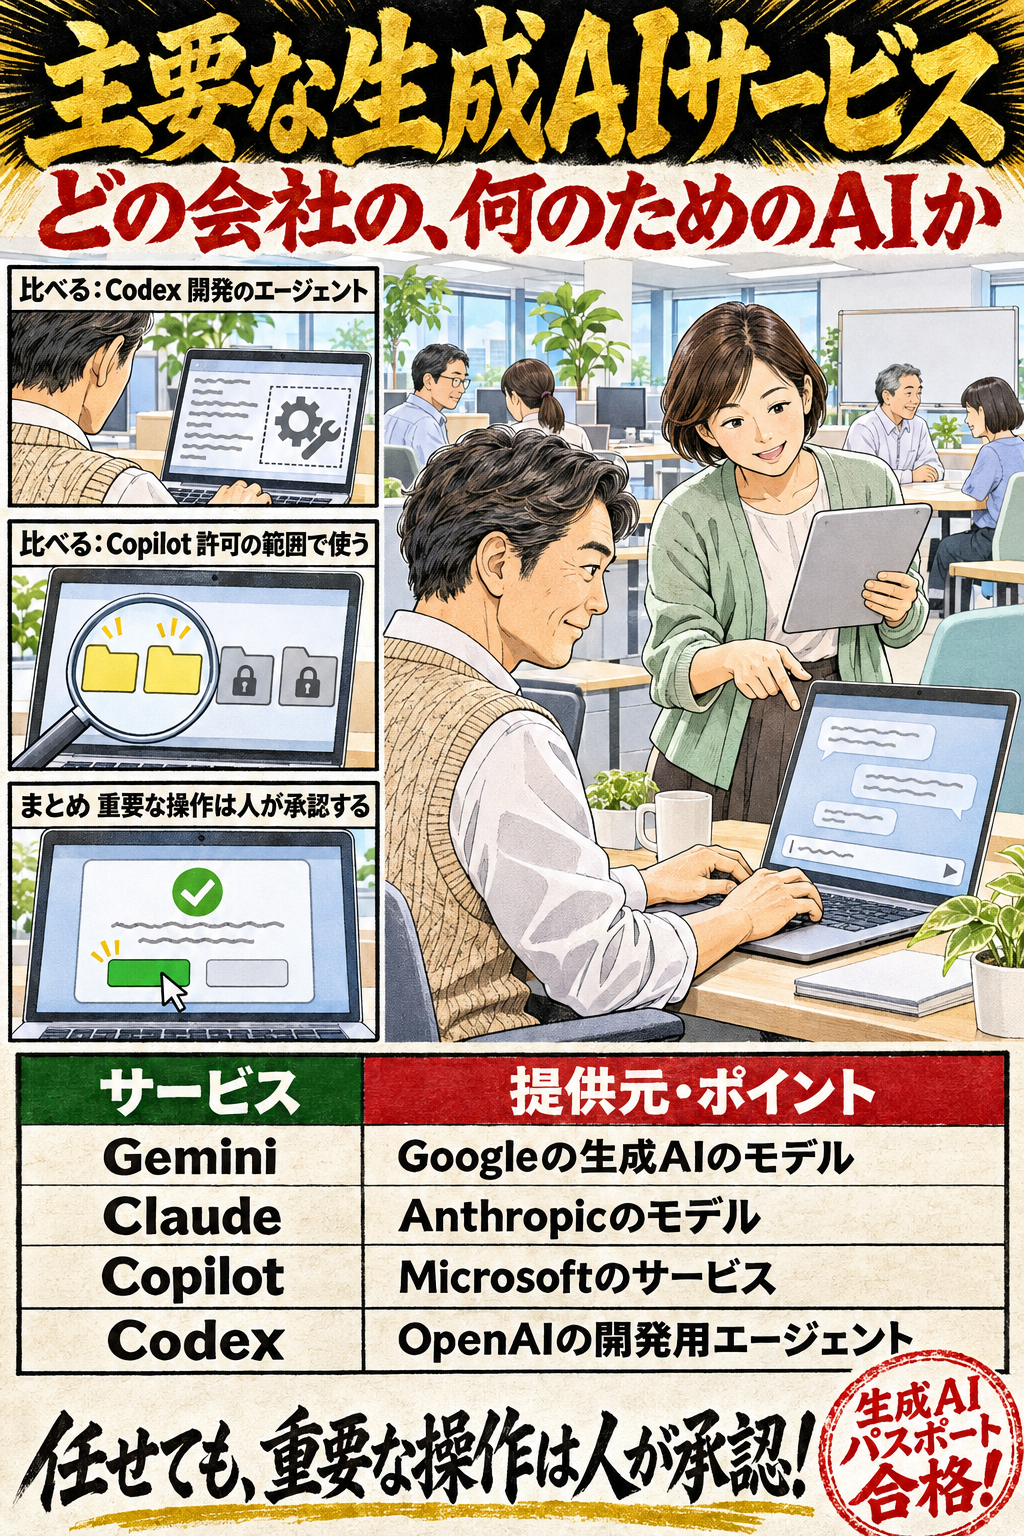
OpenAI の Operator(2025年1月発表)は、2026年11月時点では単体のサービスではなく、機能は ChatGPT agent を経て ChatGPT Work に、API では画面を操作する computer use ツールに引き継がれています。Codex は OpenAI のコーディングエージェント、Image Generation は GPT Image のモデルです。Gemini は Google、Claude は Anthropic、Copilot は Microsoft で、Copilot Chat(主に Web のデータ)と Microsoft 365 Copilot(組織のデータとつながる)を取り違えないことが要点です。
要点と○×問題へ →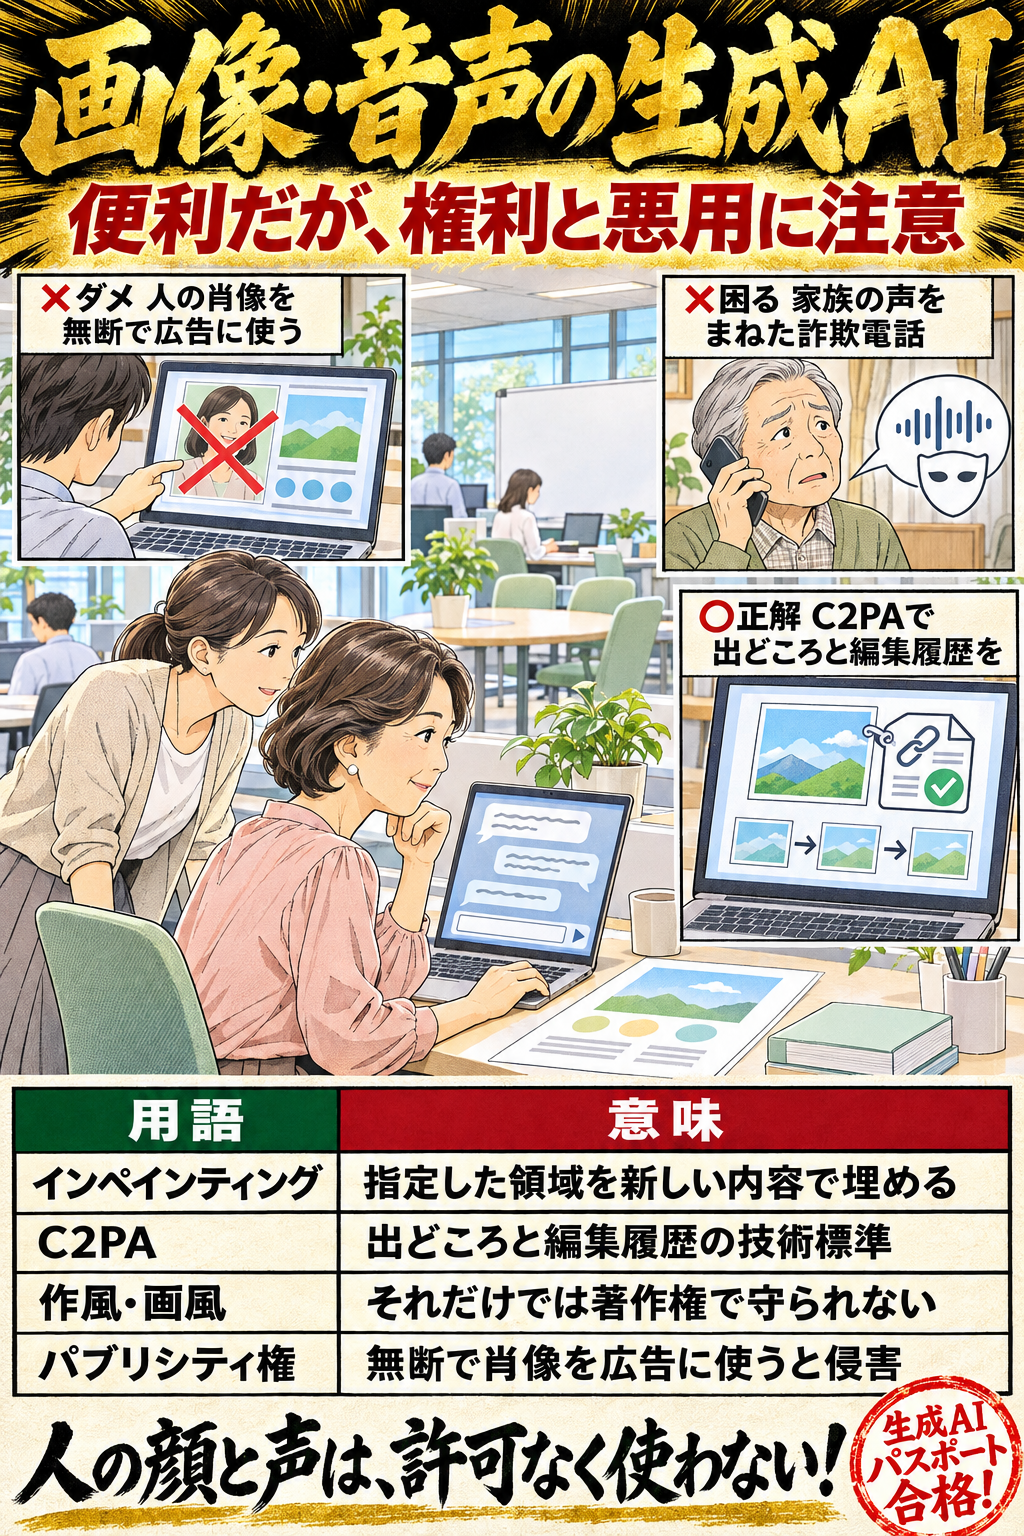
画像生成AIは拡散モデルなどで画像を作り、画像の一部を描き直すインペインティングもできます。生成物の出どころを示す来歴情報には C2PA(Content Credentials)があり、見えない電子透かしは、来歴情報の写しがほかに保管されていれば、それを探し直す手がかりになります。音声・動画の生成は、声をまねた詐欺やディープフェイク(本物そっくりの偽の画像・動画)に悪用されることがあり、作風や声は著作権の対象外とされる一方、肖像等を本人に無断で使うとパブリシティ権の問題になりうる、と押さえると解けます。
要点と○×問題へ →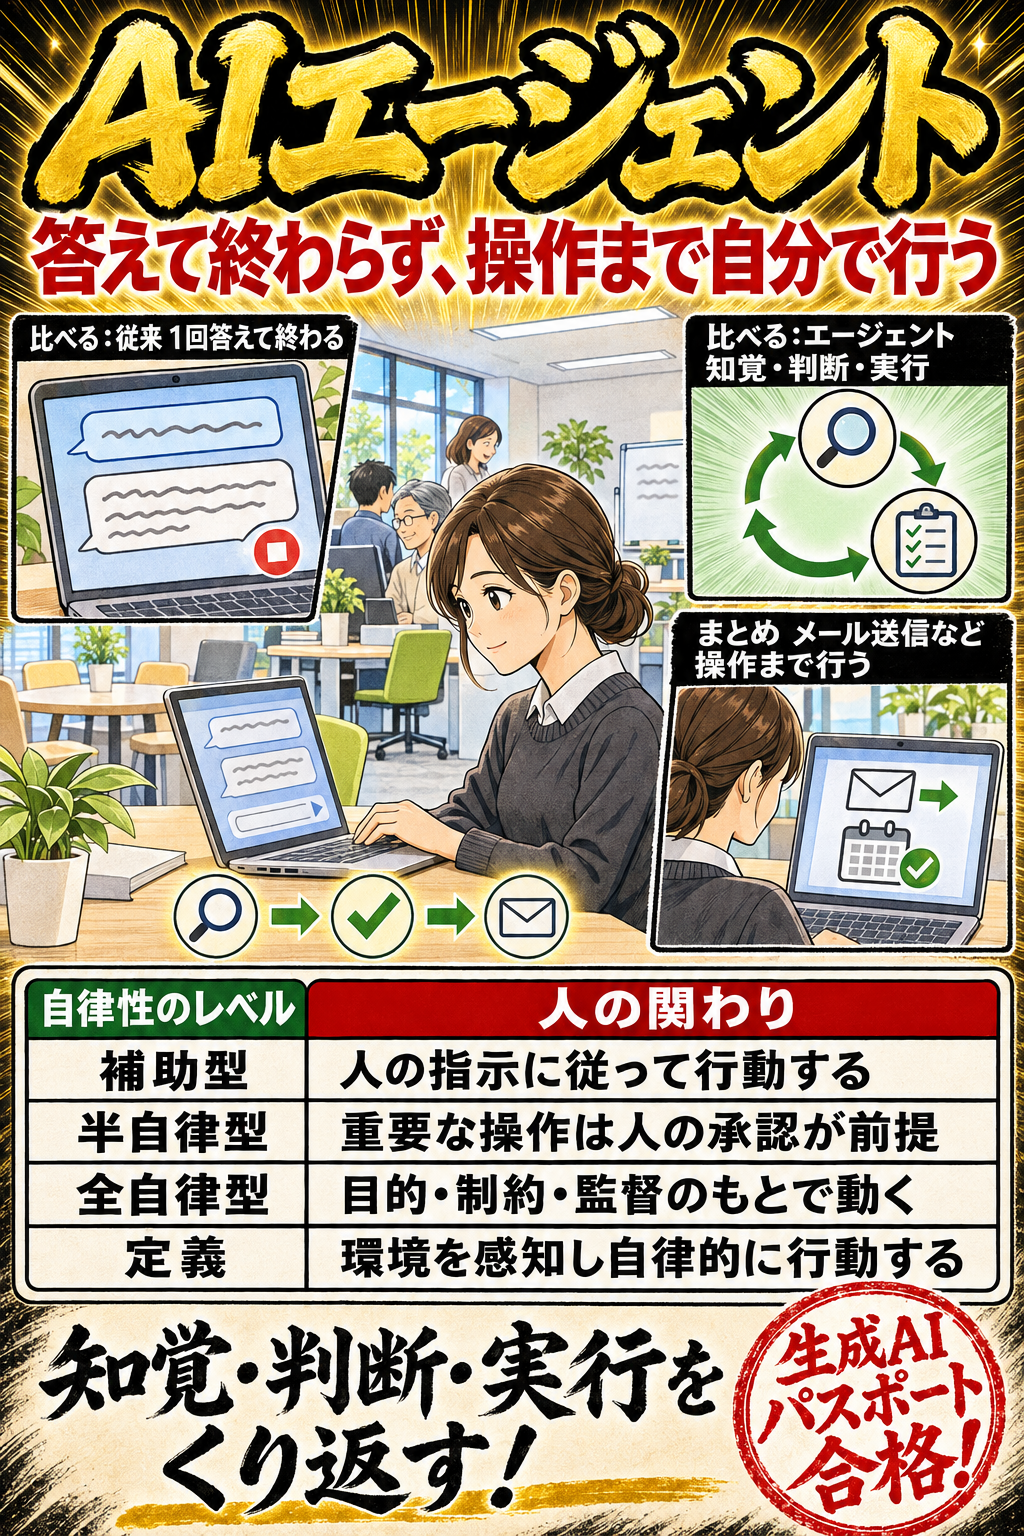
AIエージェントは、目標を与えられると、周りの状況を読み取りながら自分で手順を選び、メール送信などの操作まで行うAIです。AI事業者ガイドライン(第1.2版)とJ-AISIの評価観点ガイド(第1.20版)の定義、答えを返して終わる従来の生成AIとの違い、補助型・半自律型・全自律型という自律性のレベルを押さえると解けます。
要点と○×問題へ →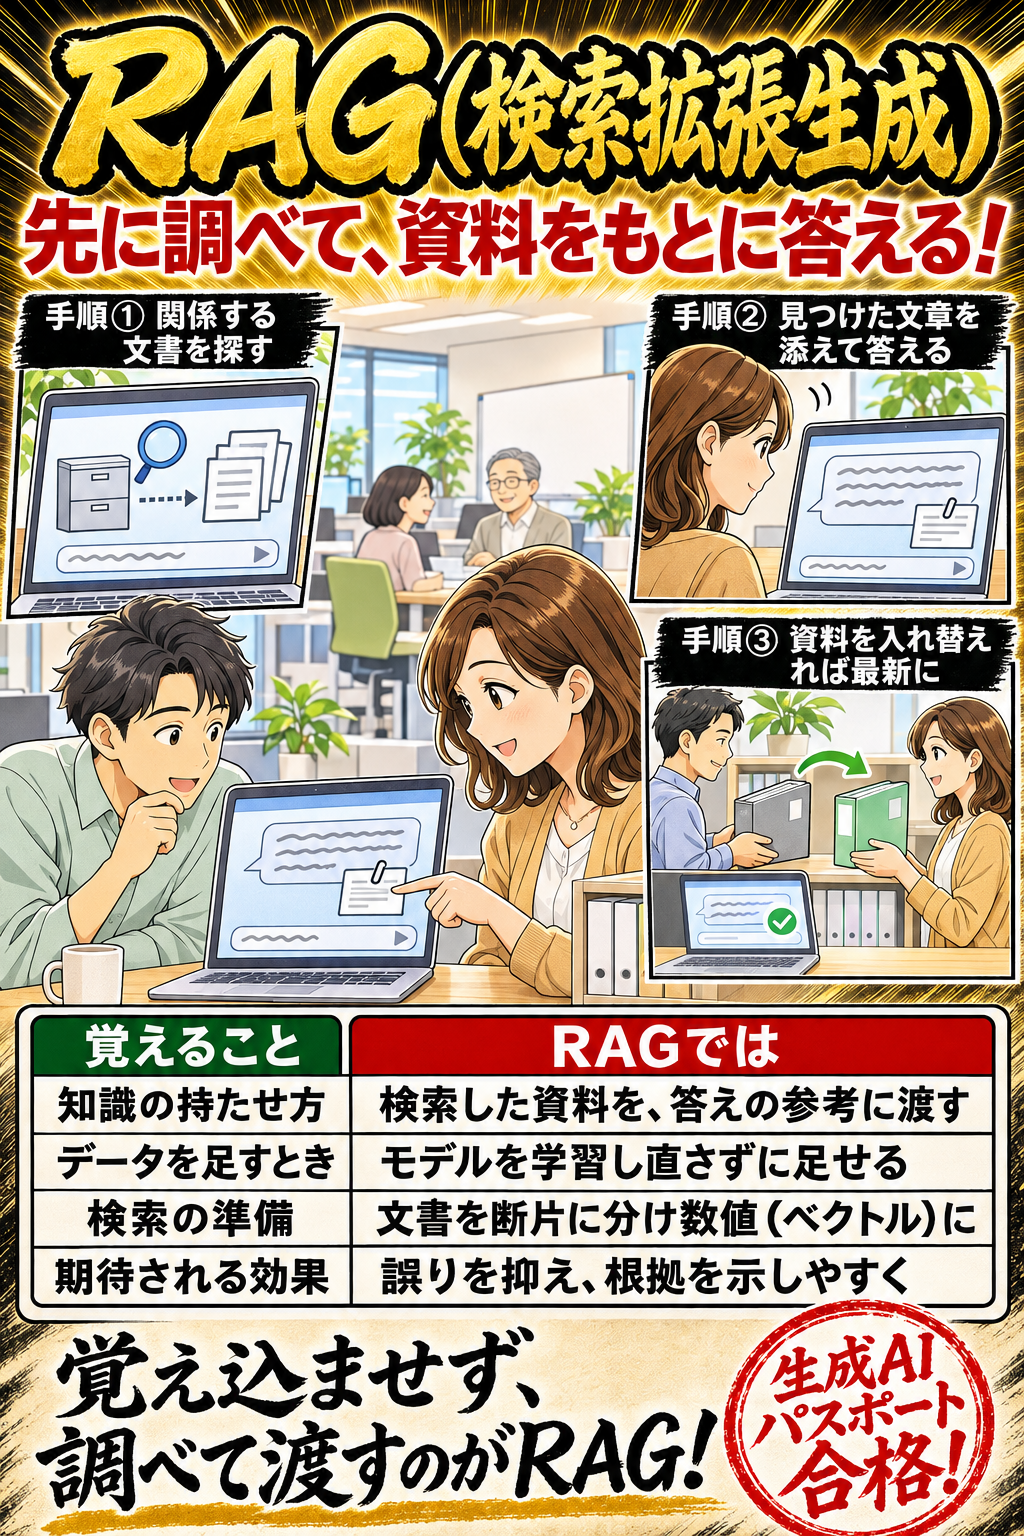
RAG(検索拡張生成)は、質問に答える前に外部のデータベースから関係する情報を探し、それを材料にLLMに答えを作らせる手法です。モデルを作り直す(ファインチューニング)のではなく「調べてから答える」点、ハルシネーションの抑制や根拠を示しやすくなる理由、文書を細かく分けて数値(ベクトル)にして検索する仕組みを押さえると解けます。
要点と○×問題へ →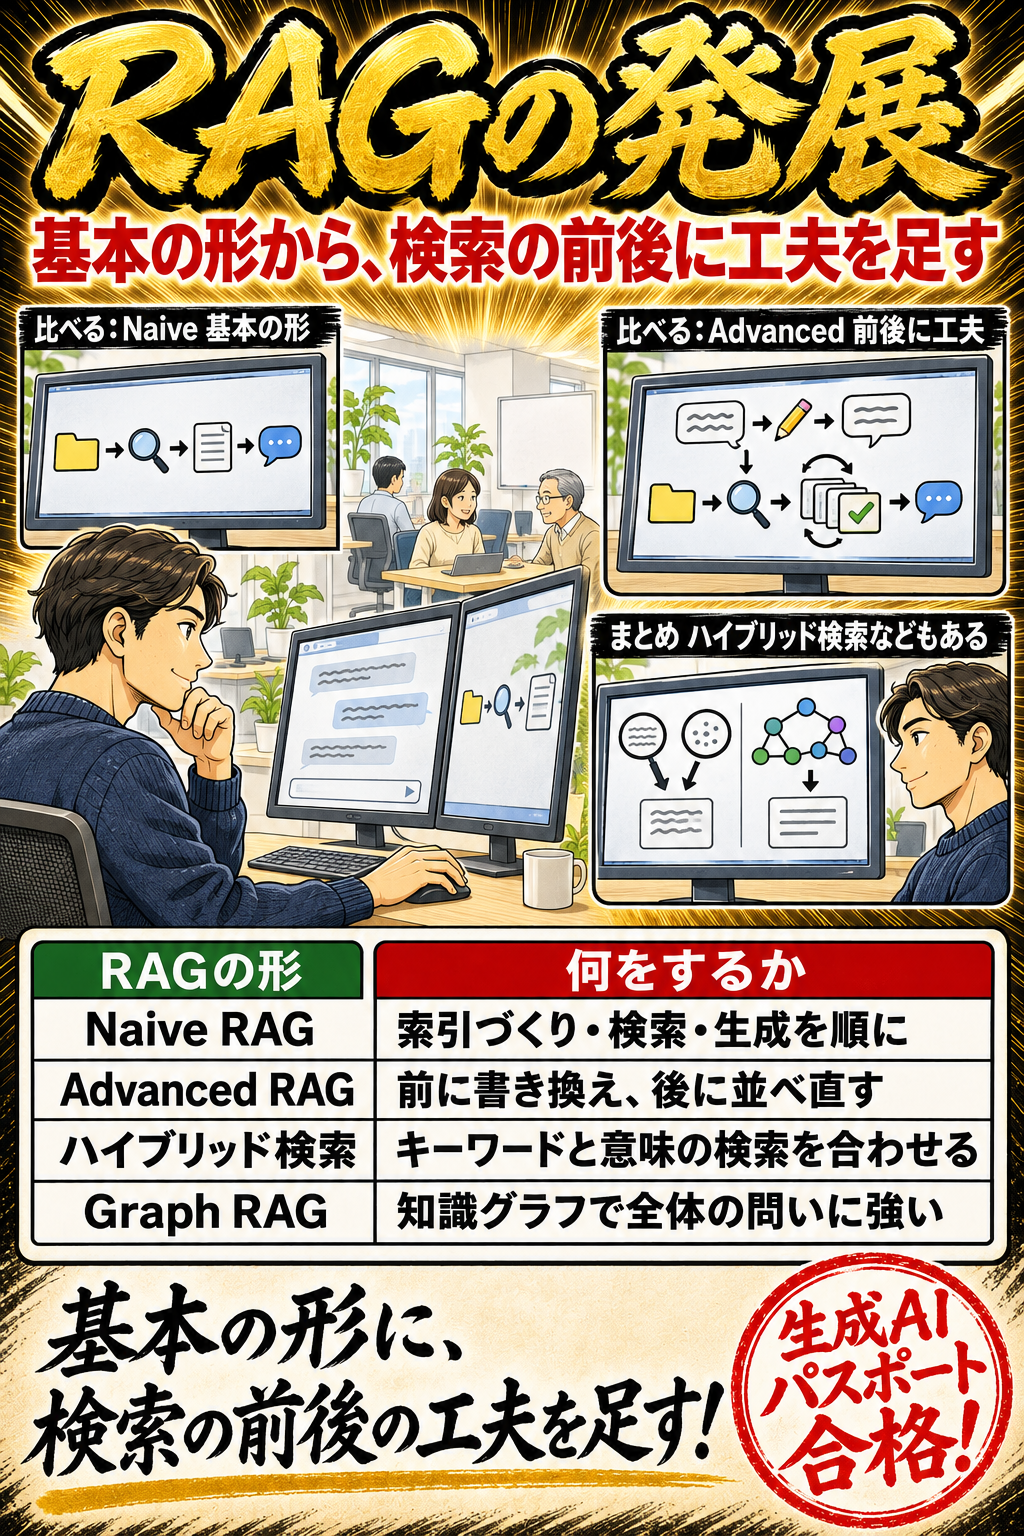
RAGは、基本の形(Naive RAG)から、検索の前後に工夫を足すAdvanced RAG(クエリの書き換え・リランキング)、キーワード検索とベクター検索を合わせるハイブリッド検索、知識グラフを使うGraph RAG、エージェントが考えながら必要なときに検索するReActやAgentic RAGへと広がっています。社内文書の検索のような使い方では、知識ベースに入れる文書の確認、部署ごとの見られる範囲の分離、個人情報の出力制御、検索結果が質問に合っているかの評価が要ることと、OpenAIのファイル検索のような組み込みの道具があることを押さえると解けます。
要点と○×問題へ →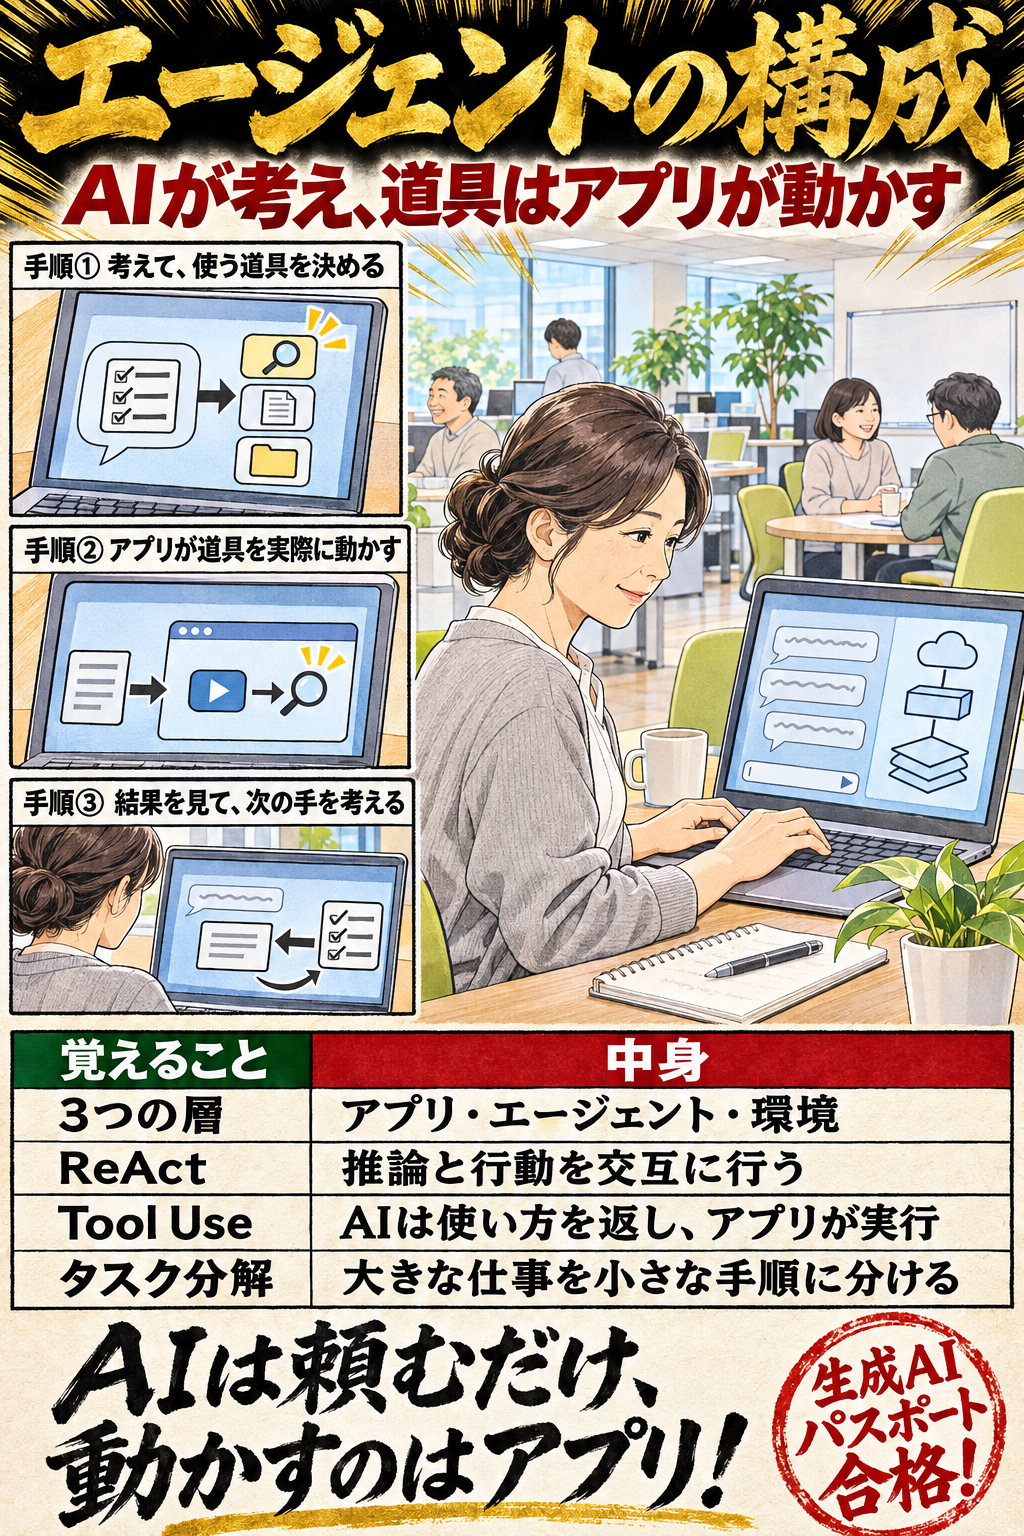
AIエージェントは、頭脳にあたるLLMを中心に、道具(ツール)や記憶を組み合わせて動きます。J-AISIが示す3つの層の構成、ReActのように「考える」と「行動する」を交互に行うこと、Function Calling(Tool Use)ではAIが「この道具をこう使いたい」と伝え、実際に動かすのはアプリ側であることを押さえると解けます。
要点と○×問題へ →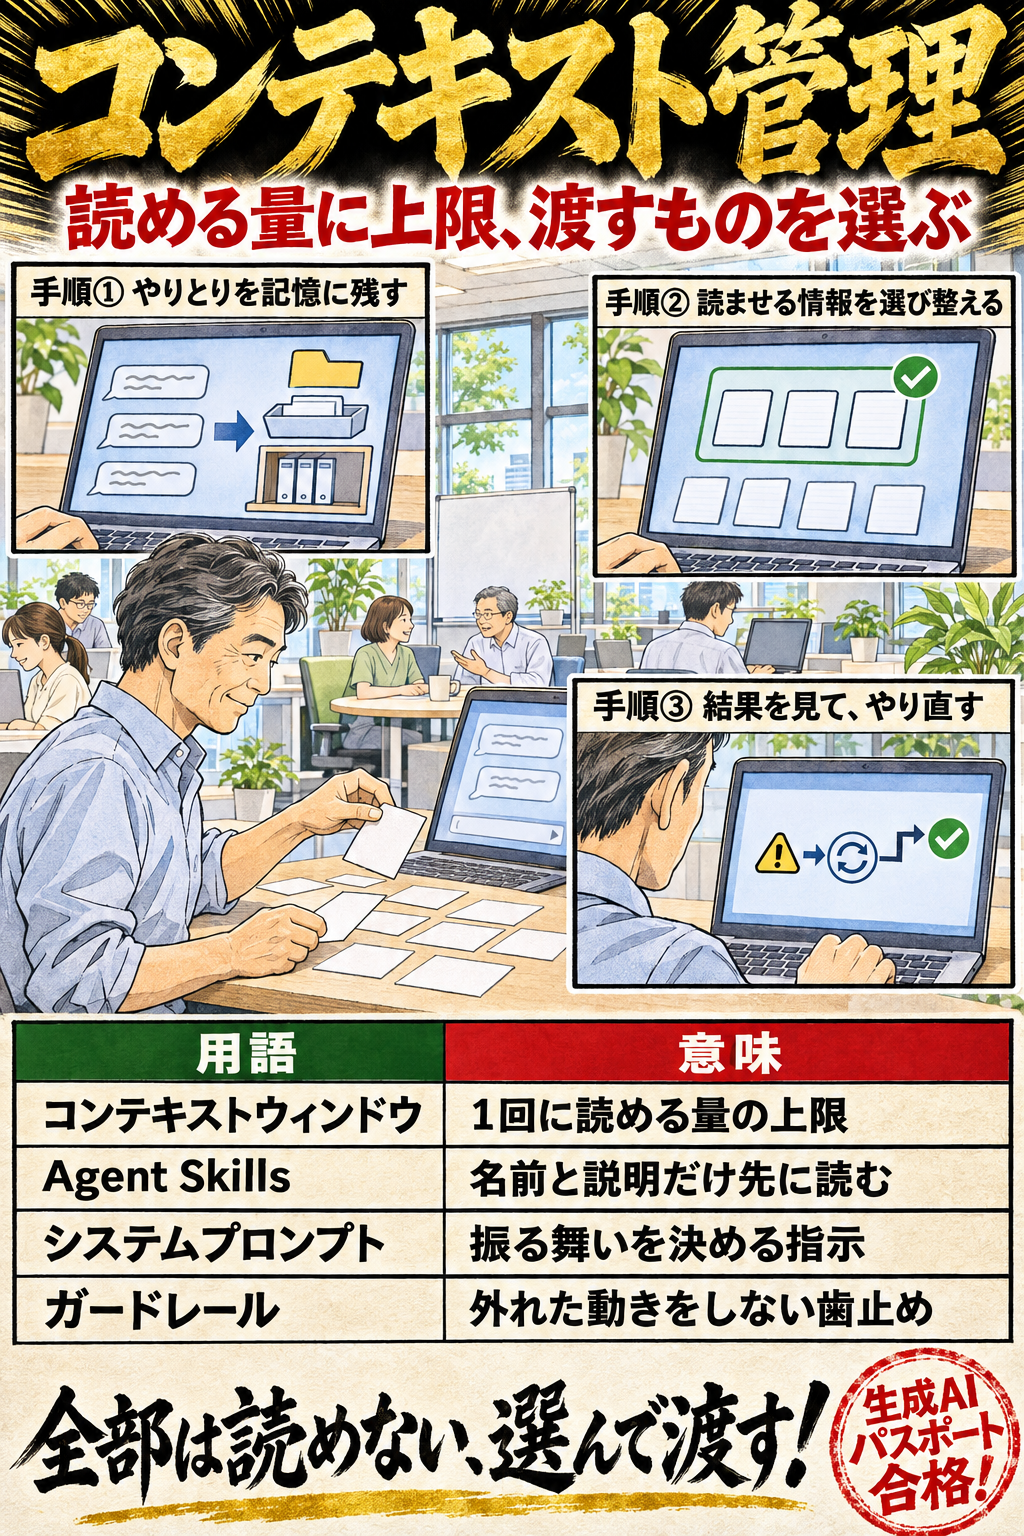
AIエージェントは、過去のやりとりを短期・長期の記憶として残し、それを参考にしながら動くことがあります。AIが一度に読める量(コンテキストウィンドウ)には上限があるため、何を渡すかを毎回選び整えるコンテキストエンジニアリングや、Agent Skillsのように必要な情報を必要なときだけ読み込ませる工夫がされます。システムプロンプトやガードレールで振る舞いを整え、結果を観察して次の行動を決め直す(フィードバックループ)流れを押さえると解けます。
要点と○×問題へ →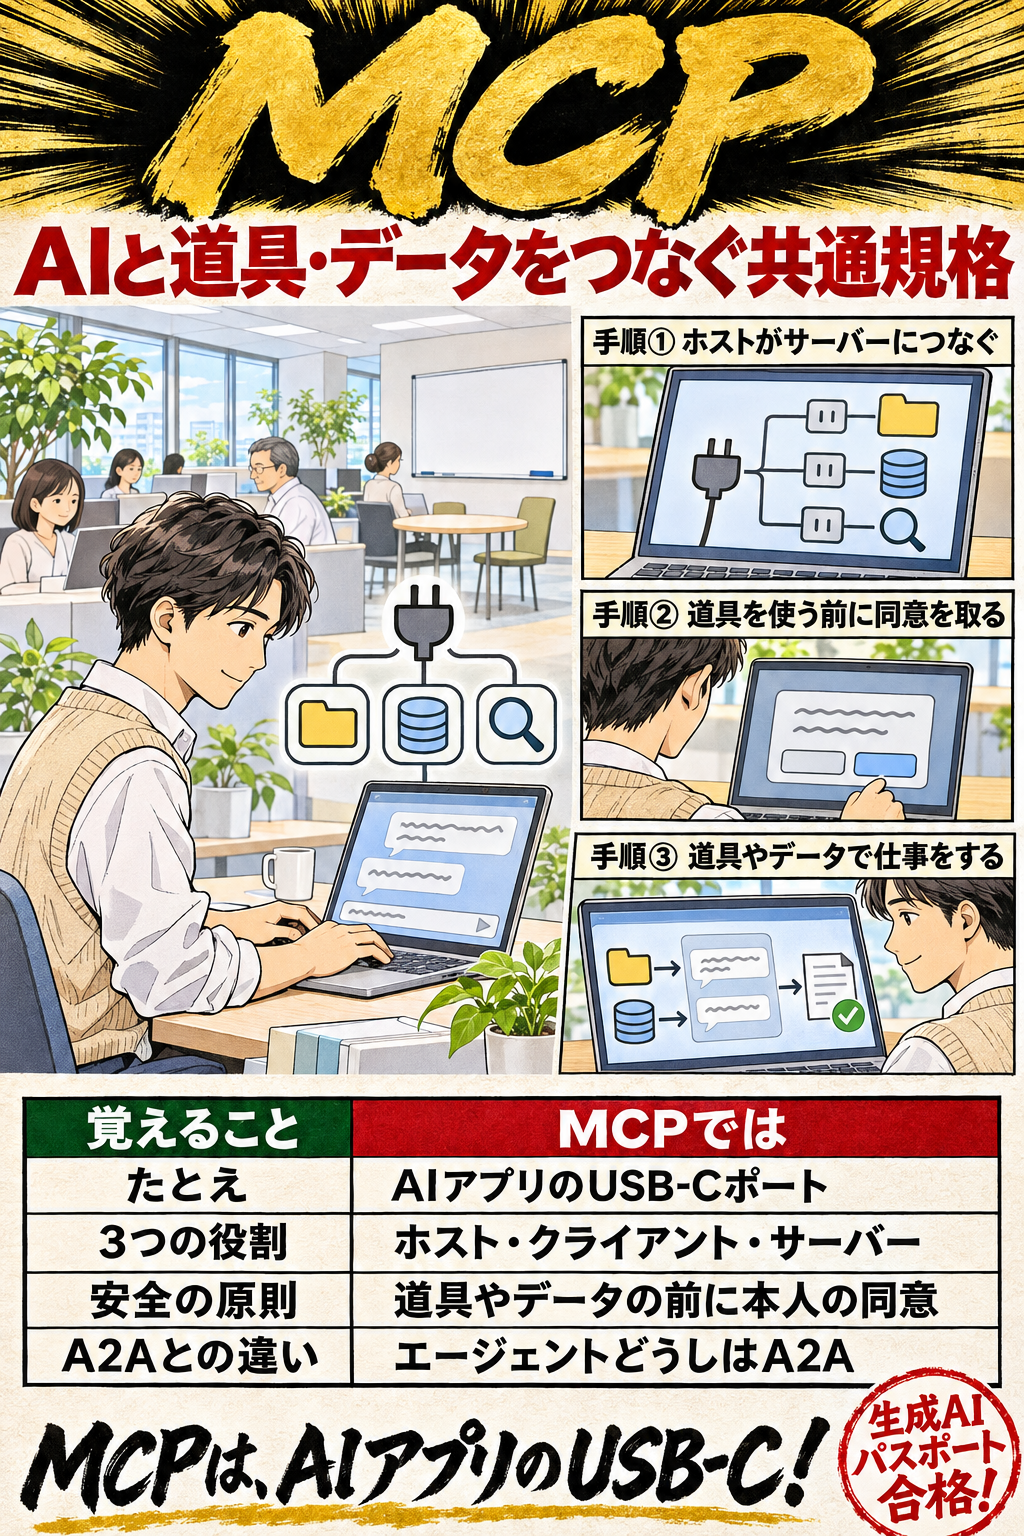
MCP(Model Context Protocol)は、AIアプリやエージェントを、ファイルやデータベース、検索などの道具といった外の仕組みにつなぐためのオープンな共通規格で、「AIアプリのUSB-Cポート」にたとえられます。2024年11月にAnthropicが公開し、2025年12月にLinux FoundationのAgentic AI Foundation(AAIF)へ寄贈されました。ホスト・クライアント・サーバーの役割、サーバーが出すResources・Prompts・Tools、道具を使う前やデータを渡す前に利用者の同意を得るという安全の原則、A2Aやファインチューニングとの違いを押さえると解けます。
要点と○×問題へ →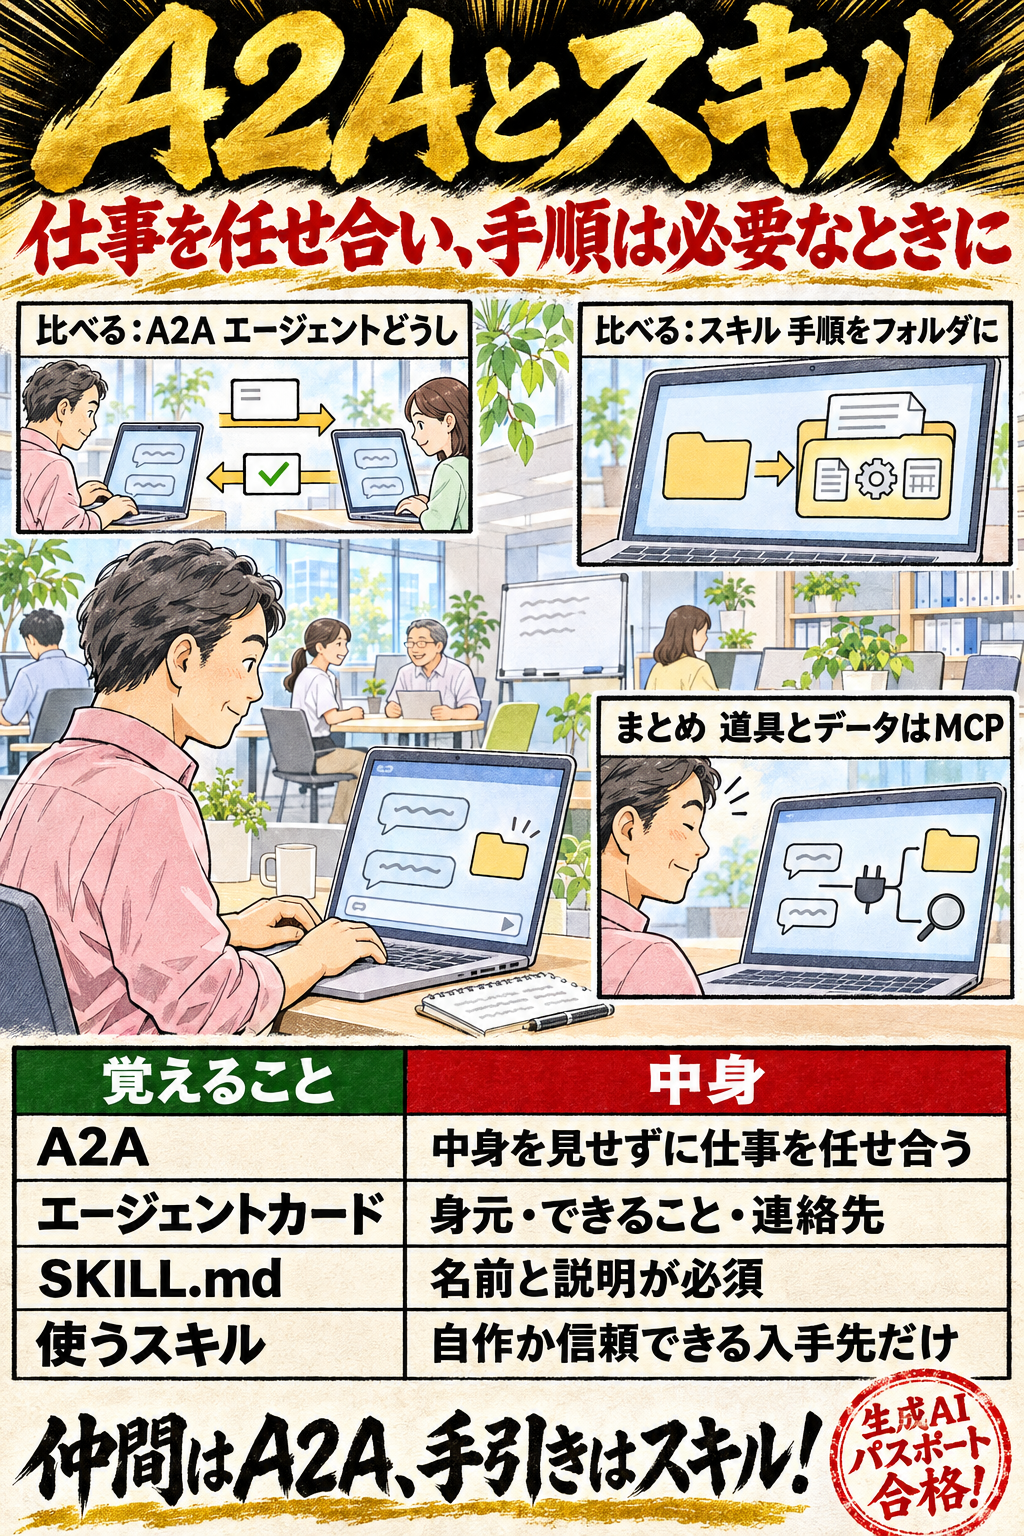
A2A(Agent2Agent)は、別々の会社や仕組みで作られたAIエージェントどうしが、互いの中身を明かさずに能力を知らせ合い、仕事を任せ合うためのオープンな規格(Googleが始め、いまはLinux Foundationのプロジェクト)で、エージェントと道具・データをつなぐMCPとは補い合う関係です。Agent Skillsは、手順書・プログラム・資料をSKILL.mdを中心としたフォルダにまとめ、必要なときに読み込ませる仕組みです。仕事を分担するサブエージェントと、エージェントどうしがつながることで増えるリスクも押さえると解けます。
要点と○×問題へ →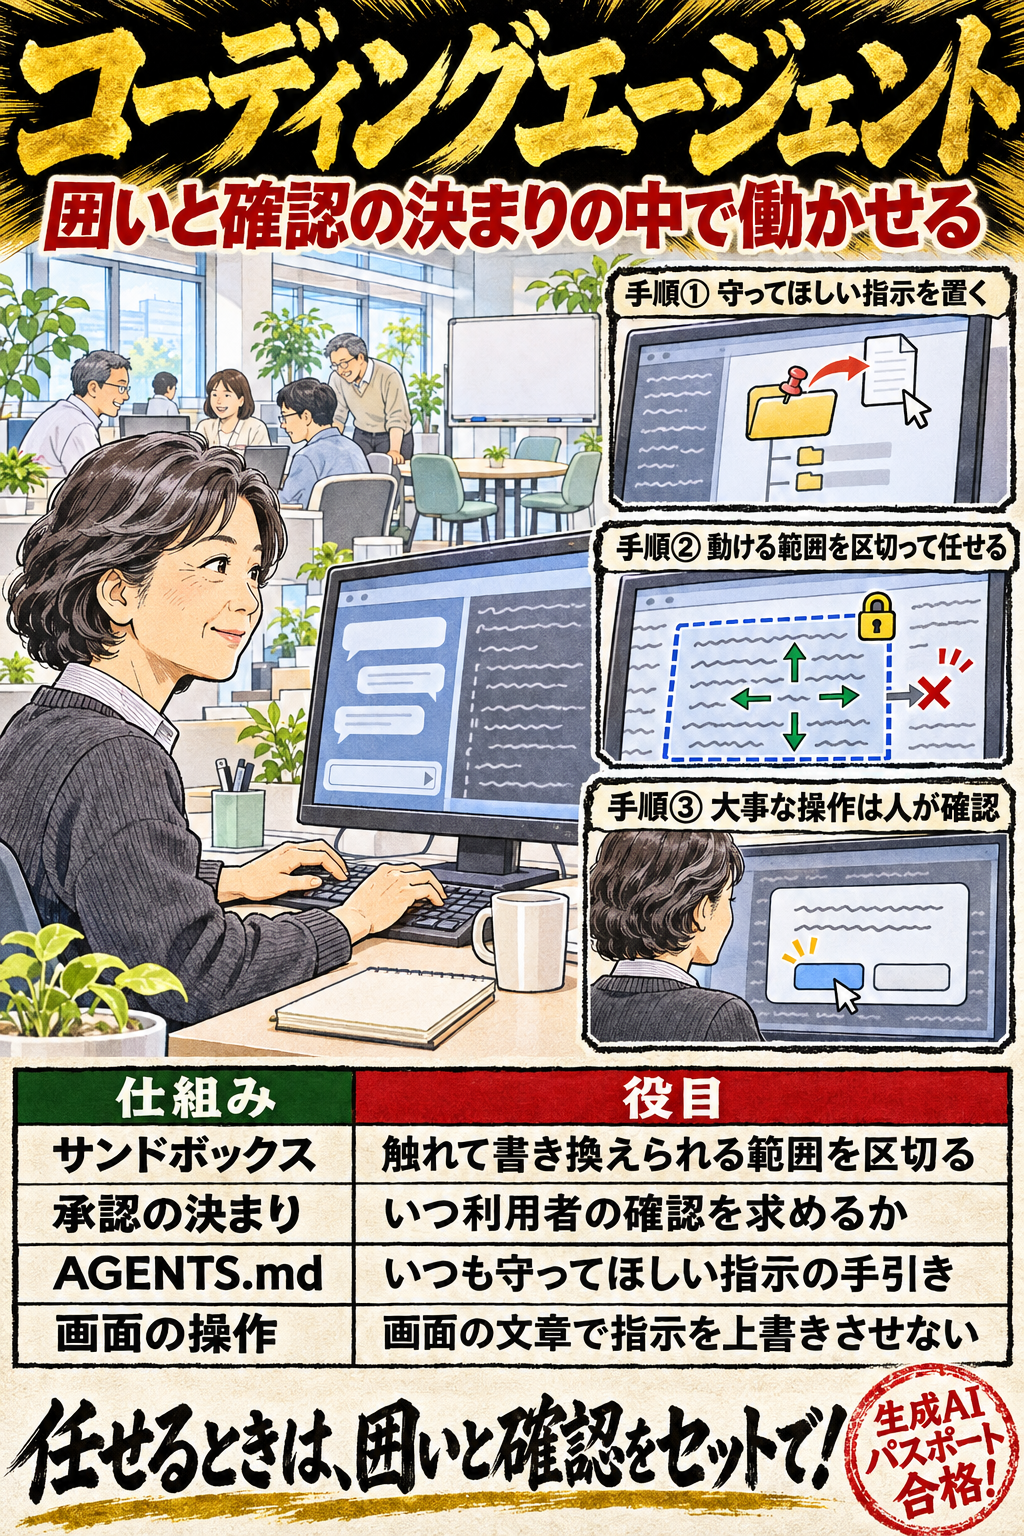
コーディングエージェント(OpenAIのCodexなど)は、プログラムの作成や変更、プルリクエストの確認を任せられるAIで、動ける範囲を区切る仕組み(サンドボックス)・確認の決まり・指示のファイル(AGENTS.md)といった周りの仕組み(ハーネス)の中で動きます。画面を操作するcomputer useの安全な使い方、ChatGPT Workのように仕事を任せるエージェントやディープリサーチ、AI事業者ガイドラインの導入事例と役割分担を押さえると解けます。
要点と○×問題へ →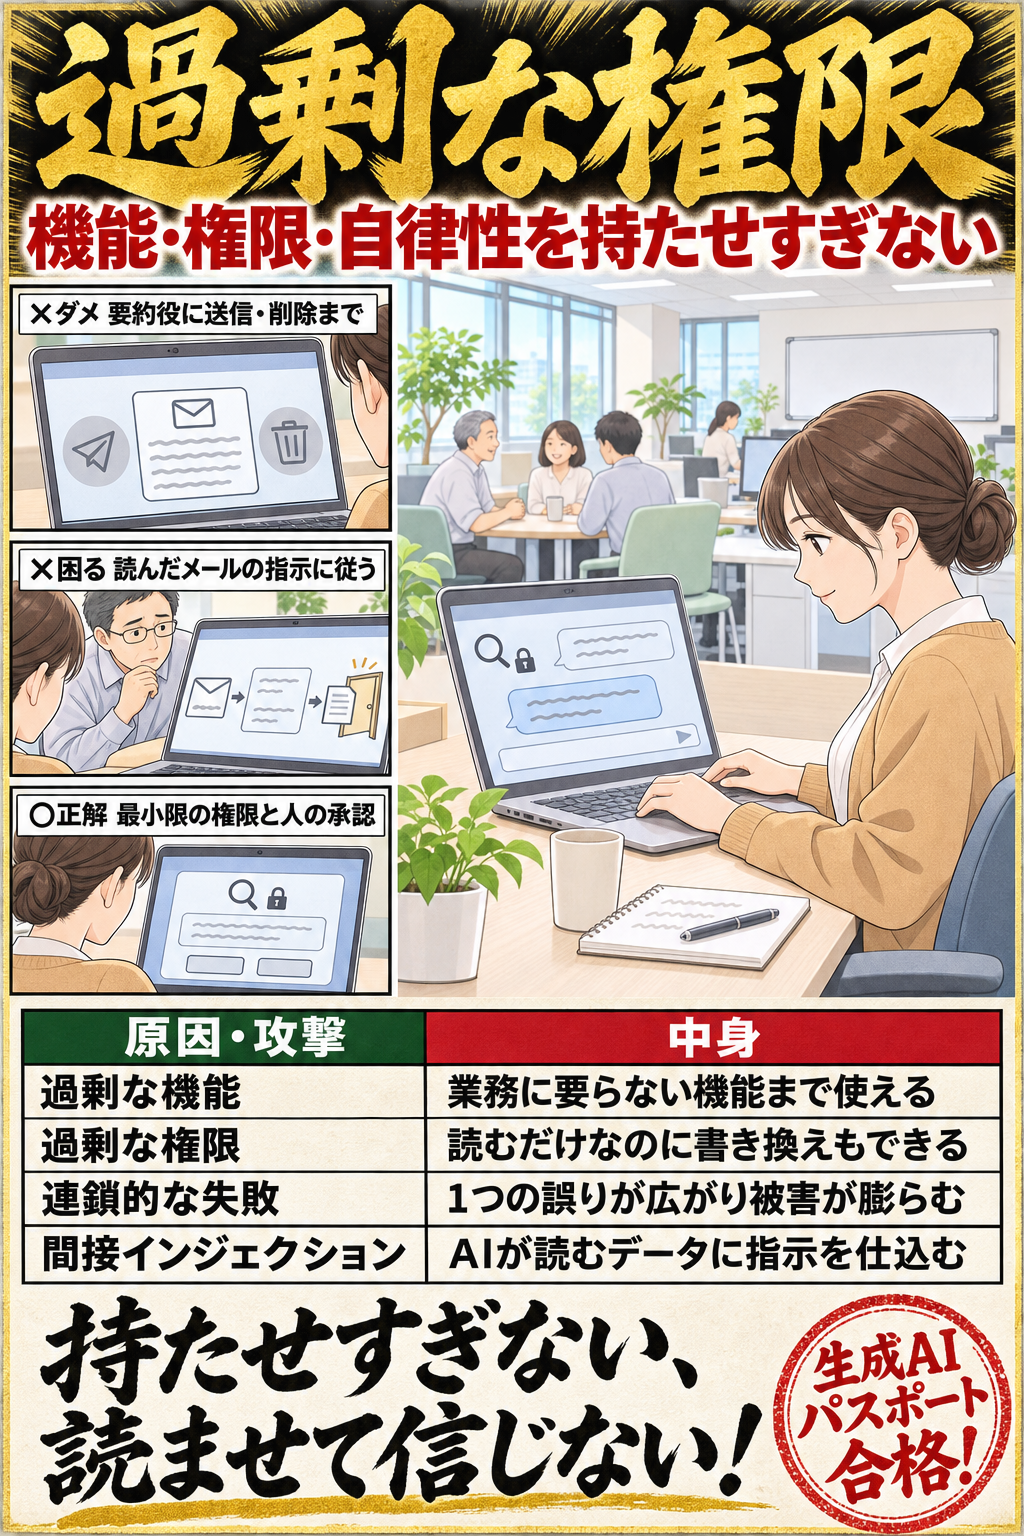
OWASPは、AIに持たせた機能・権限・自律性が多すぎるために、誤った指示や操られた指示で害のある操作が行われてしまう弱点を「過剰な権限(Excessive Agency)」と呼びます。1つの誤りがエージェントの間で広がる連鎖的な失敗、利用者が直接入力する直接プロンプトインジェクションと、Webページやメールなど AIが読み込むデータに仕込まれる間接プロンプトインジェクションの違い、IPAが紹介する具体的なトラブルの事例を押さえると解けます。
要点と○×問題へ →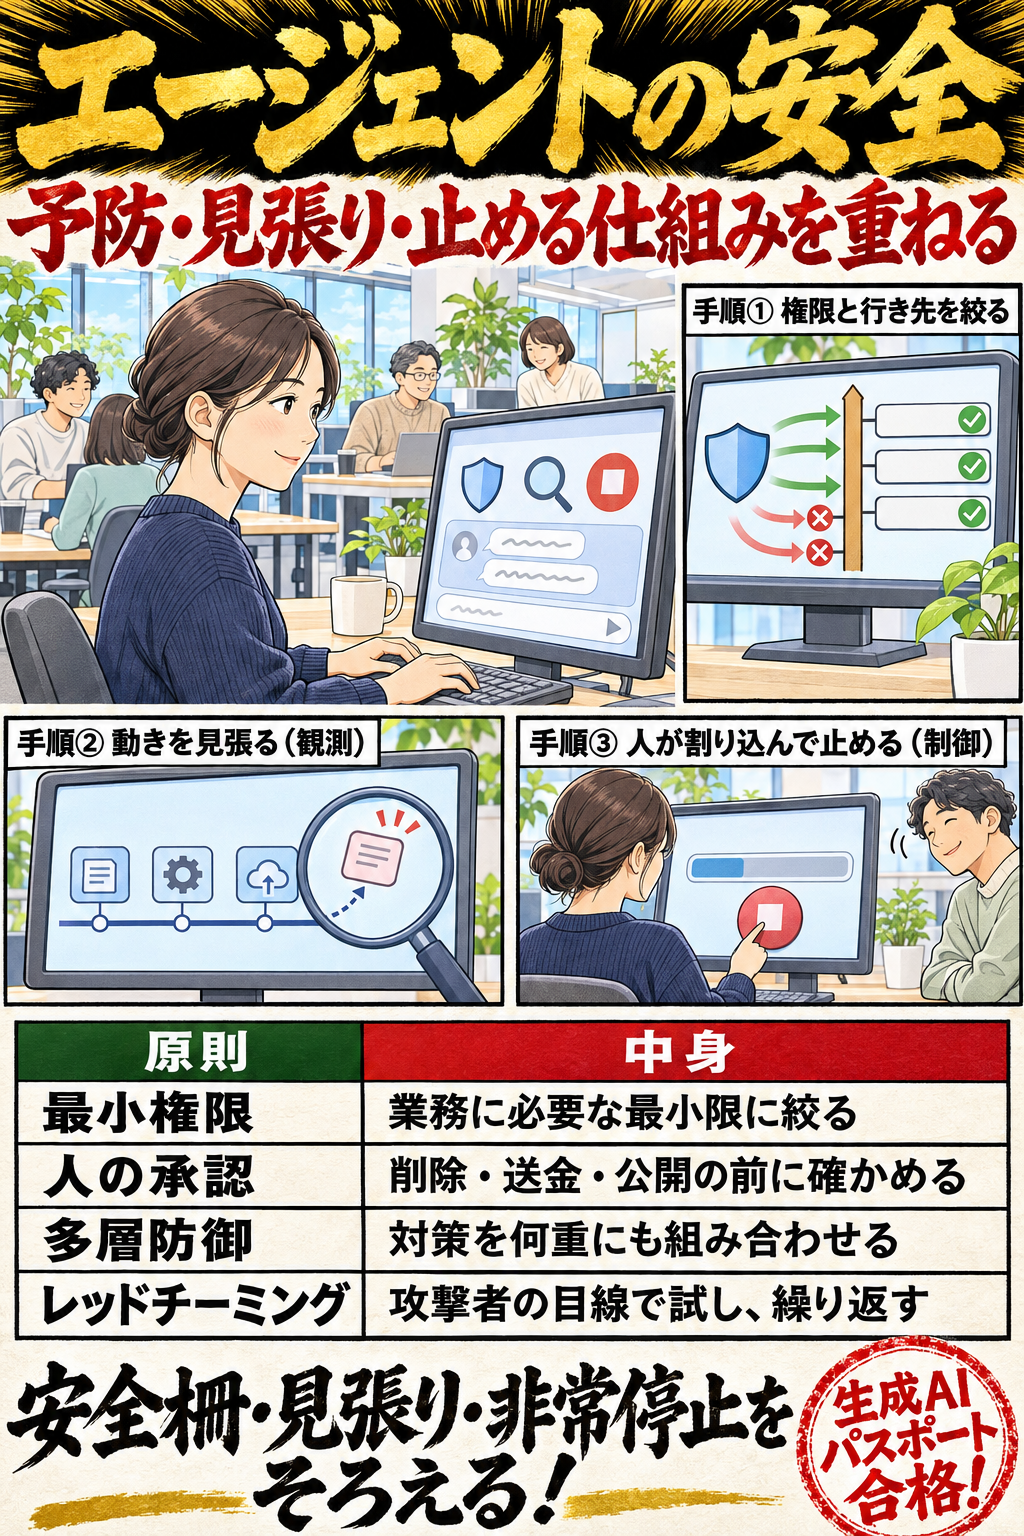
AIエージェントを安全に使うには、必要のない自律性や権限を与えない(最小権限・Least Agency)、許可リスト(ホワイトリスト)で連携先を絞る、サンドボックスで隔離する、影響の大きい操作に人の承認をはさむ(Human-in-the-Loop)、対策を何重にも重ねる、といった原則があります。J-AISIが予防的対策に加えて「観測(見張り)」と「制御(止める仕組み)」を求め、評価を開発・提供・利用の各段階で繰り返し行い、攻撃者の目線で試すレッドチーミングを使うとしていることを押さえると解けます。
要点と○×問題へ →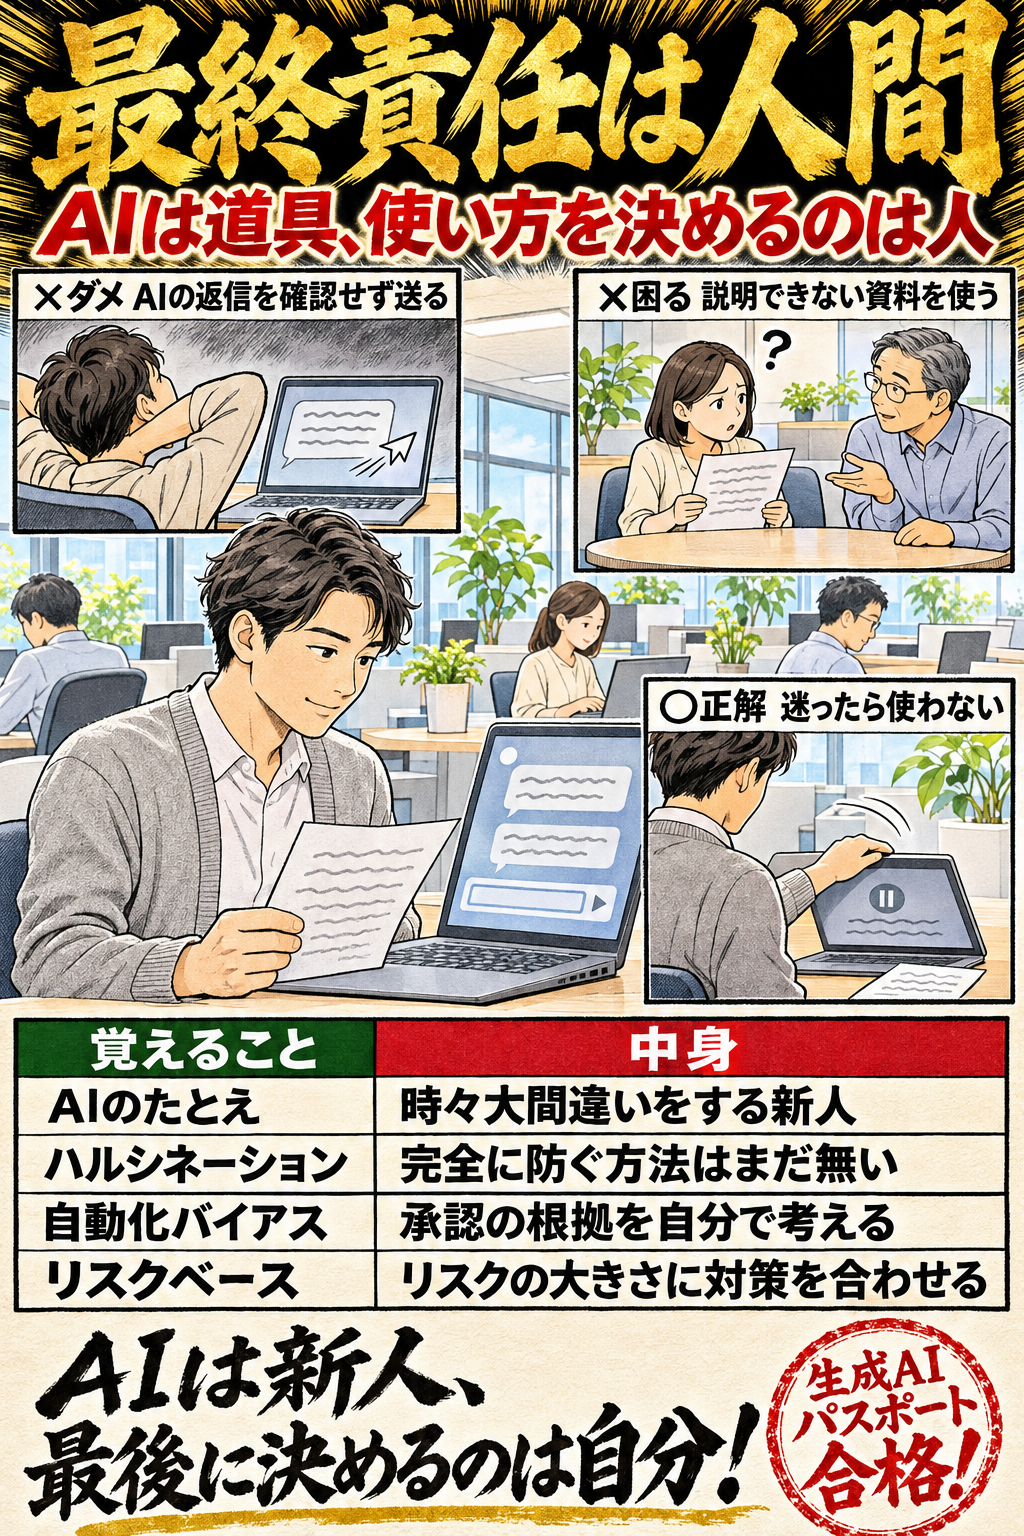
生成AIは仕事の道具で、出力をどう使うかの判断と責任は使う人にあります。出力は確率的に作られ、検索などで情報を補わない限り学習していない情報には答えられず、ハルシネーションを完全には防げないため、確認が欠かせません。用途と影響度に応じて、慎重に使う・使わないを決めることを押さえると解けます。
要点と○×問題へ →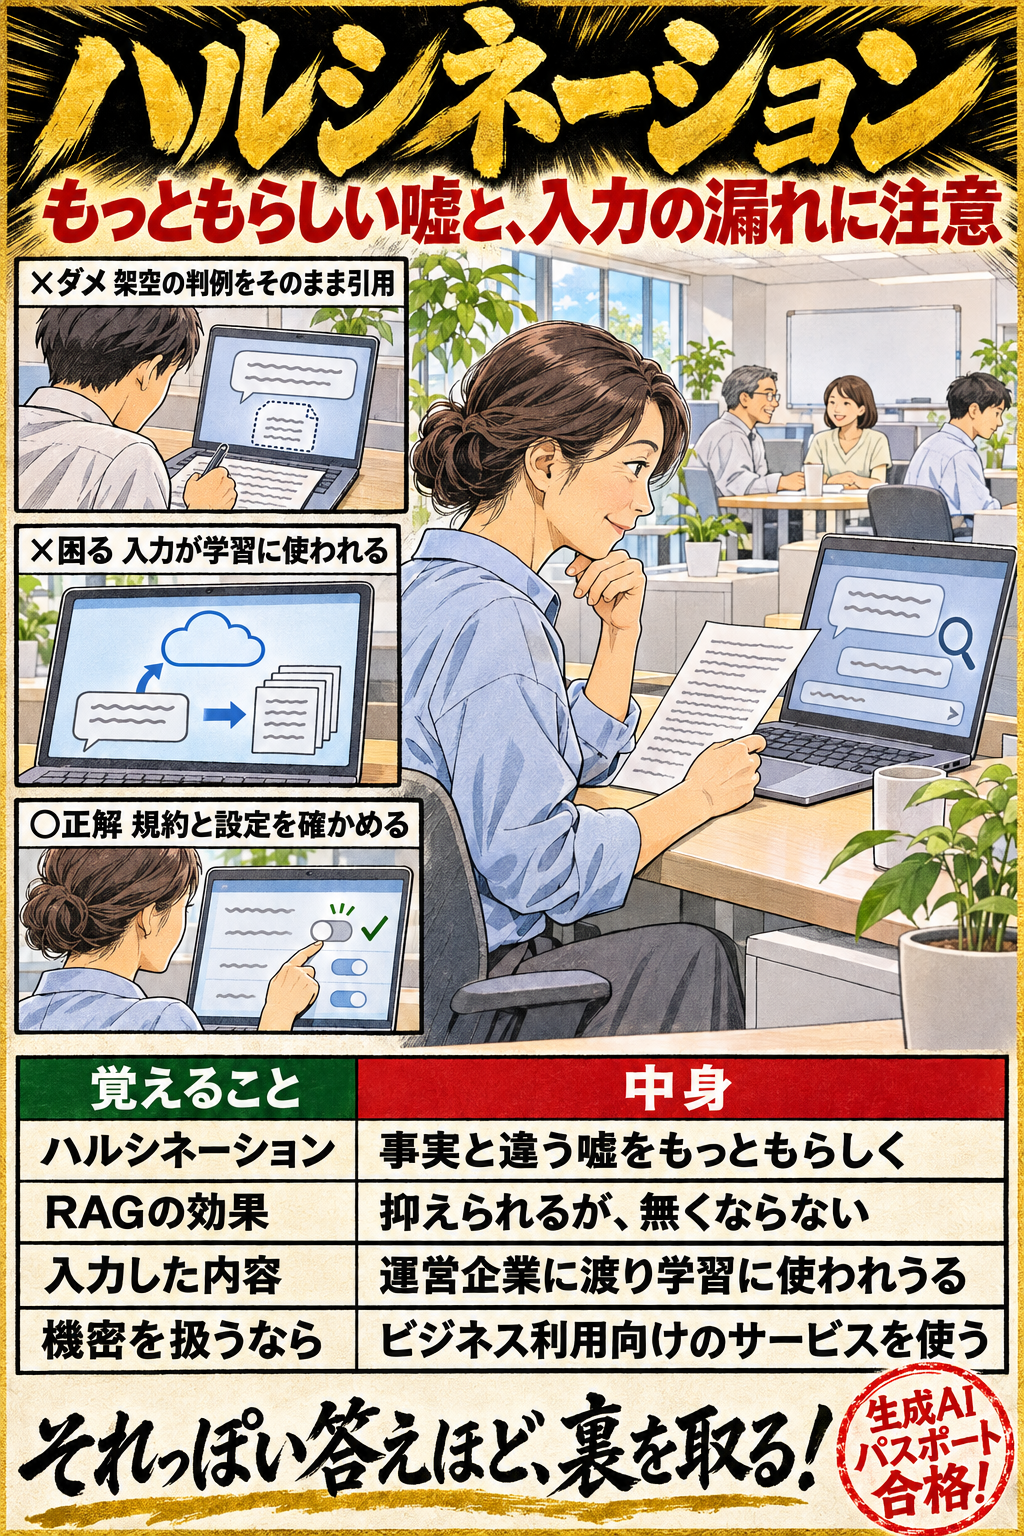
生成AIのリスクには、権利侵害・情報漏えい・誤った出力の鵜呑み・攻撃への悪用などがあり、社会全体への影響も含めて考えます。ハルシネーション(事実と異なる内容をもっともらしく出力すること)はRAGで抑制できても無くならないこと、入力した情報が運営企業に渡り学習に使われうることと、設定や規約の確認で防ぐことを押さえると解けます。
要点と○×問題へ →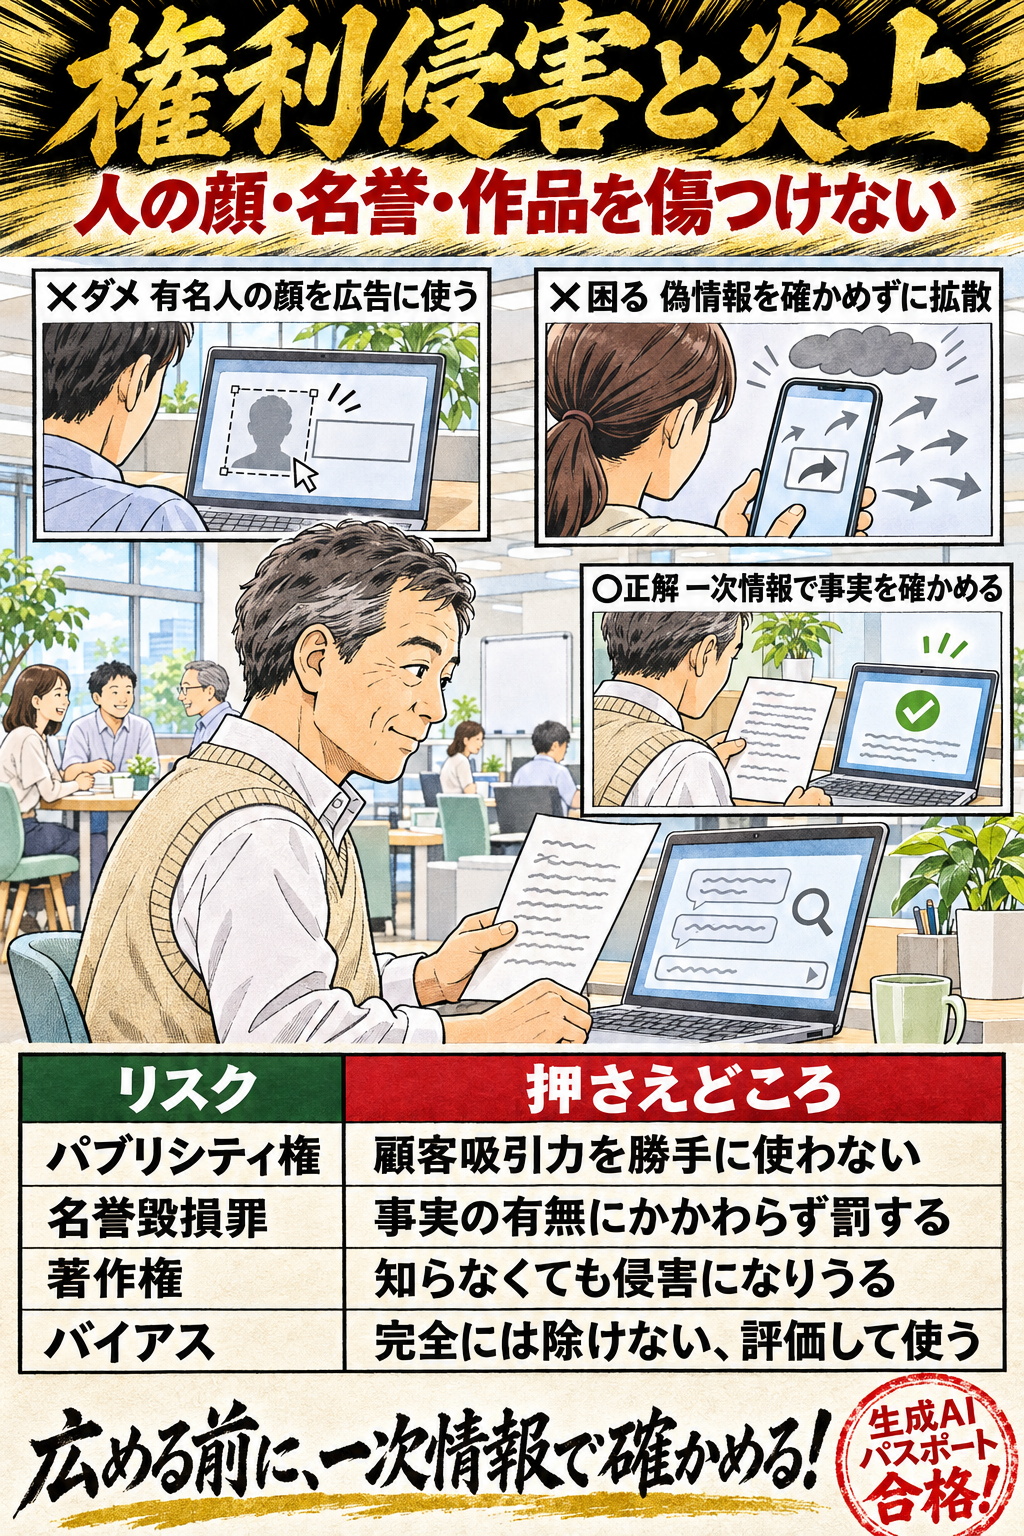
生成AIの入力と出力は、個人情報・プライバシー、著作権などの知的財産権、肖像権・パブリシティ権、名誉を損なうことがあり、差別や偏見を含むこともあります。パブリシティ権の侵害となる3つの使い方、偽情報を拡散する責任(刑法の名誉毀損罪・信用毀損罪を含む)、バイアスは完全には除けないことを押さえると解けます。
要点と○×問題へ →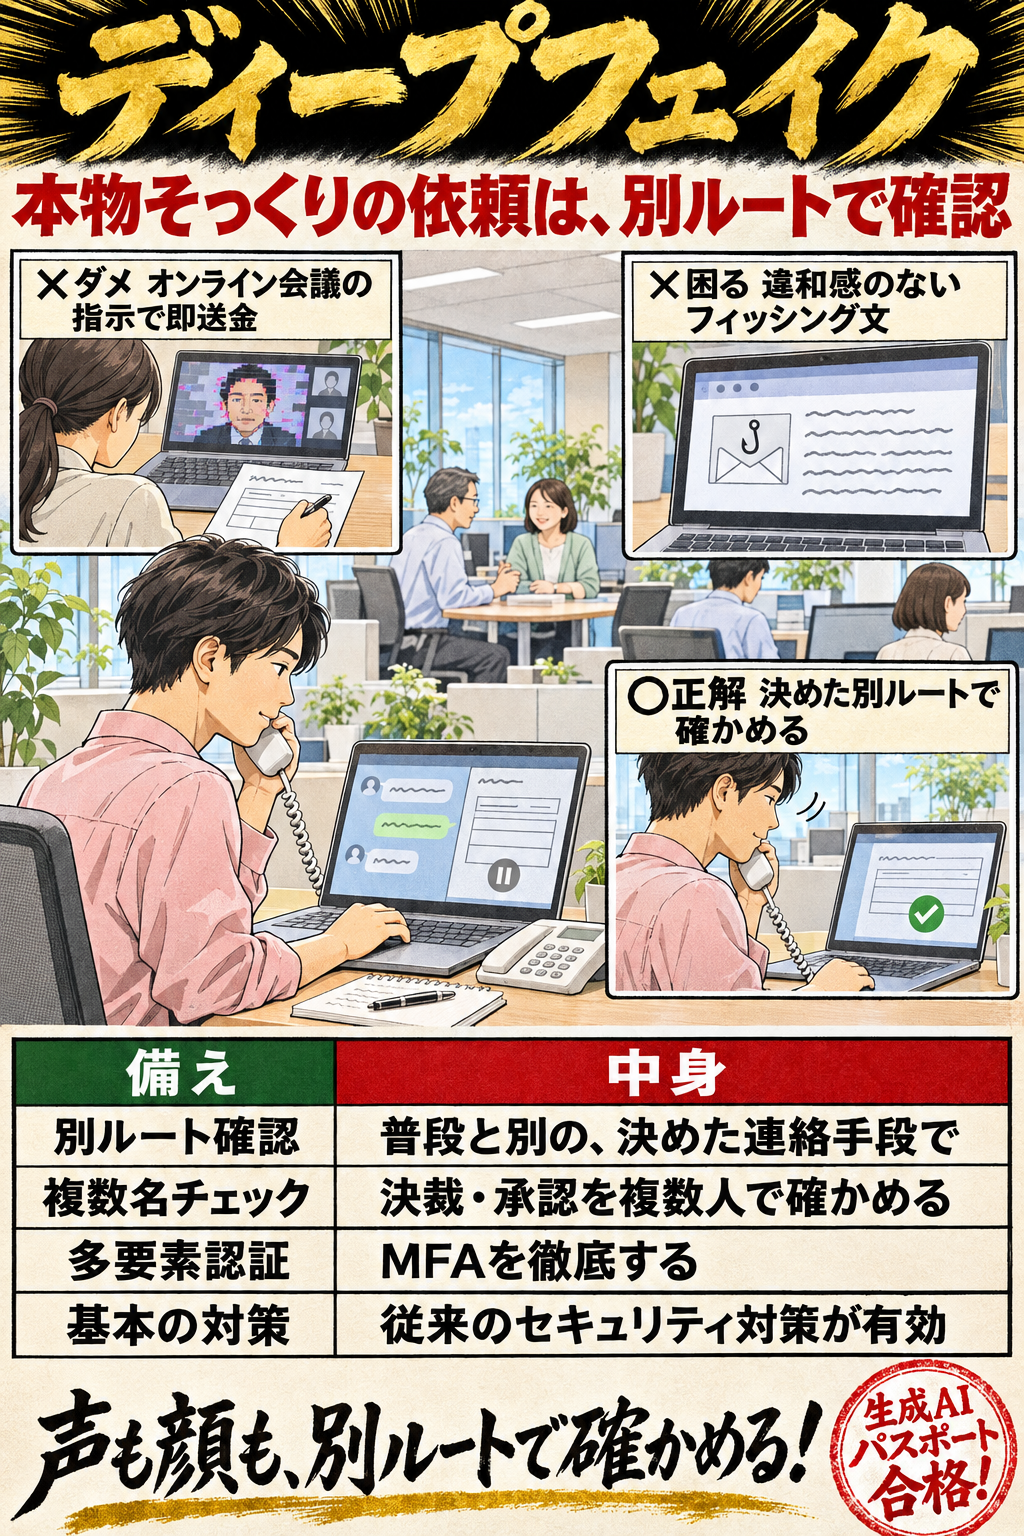
精巧なフェイクの画像・動画・音声によるなりすまし、AIで自然な文面にしたフィッシング、AIによる攻撃の手助けへの備え(別ルートでの確認、複数人の承認、多要素認証、基本のセキュリティ対策)と、AIエージェントの想定外の動作やプロンプトインジェクション(直接・間接)への対策(権限の最小化、人の承認)を押さえると解けます。
要点と○×問題へ →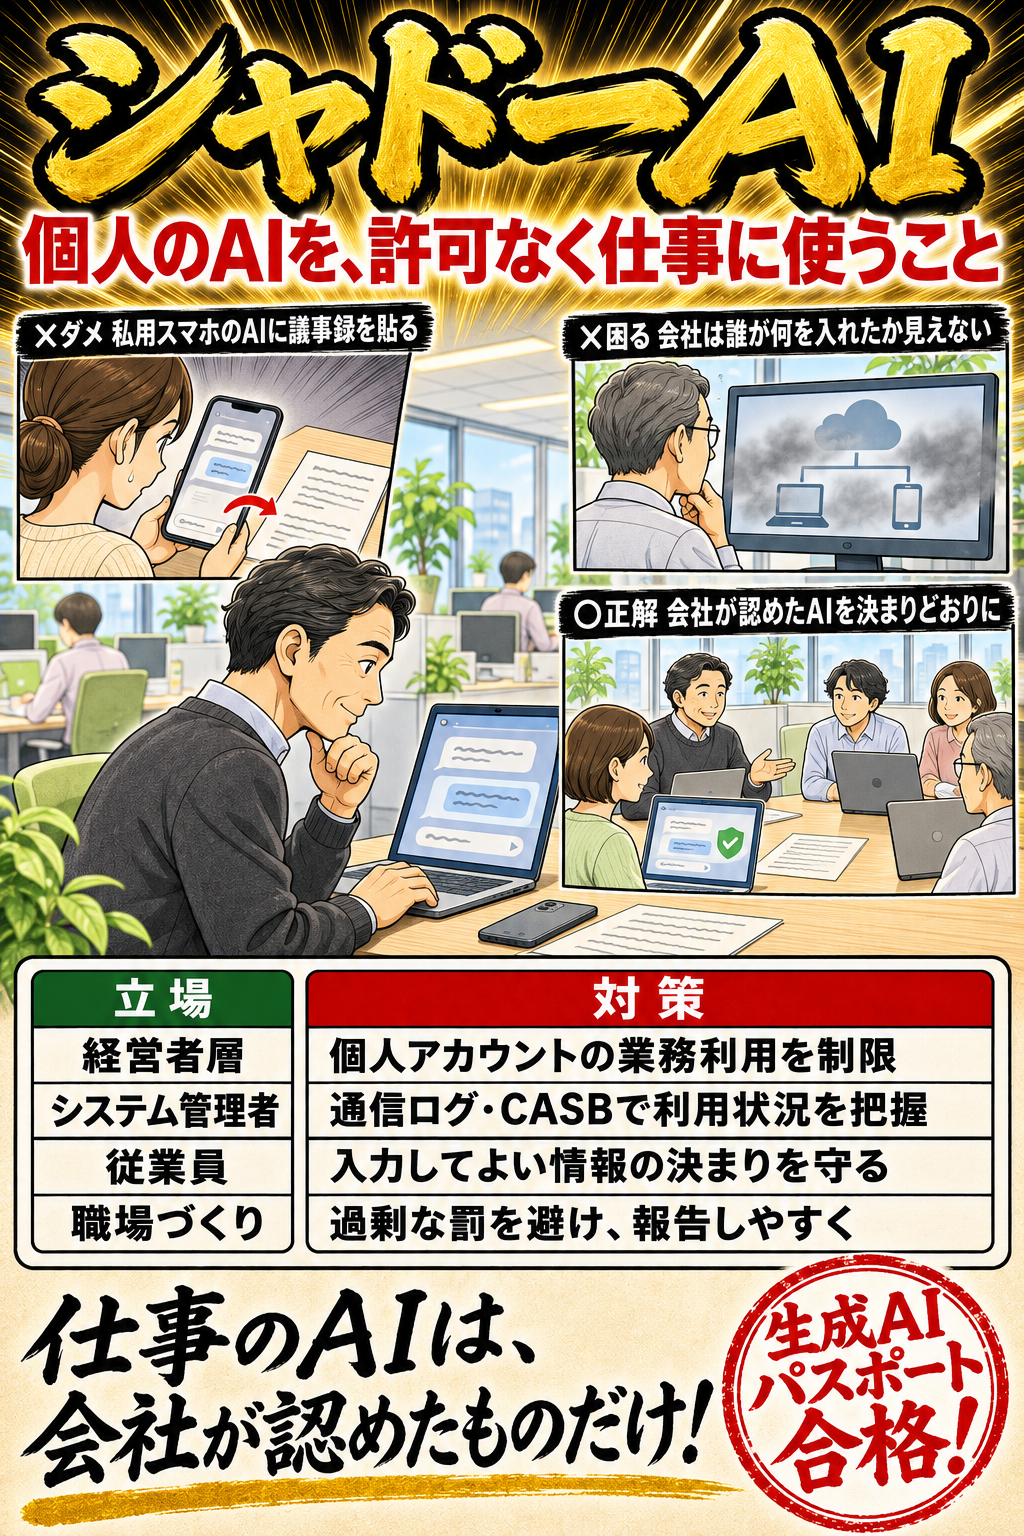
シャドーAIは、従業員が個人的に使っているAIサービスを職場の許可なく業務に使うことです。職場にAIが無い・利用の障壁が低い・ルールが未整備といった理由で起こり、持ち出し禁止の情報の漏えいや、組織が利用を把握できないことがリスクになります。会社(規程・個人アカウントの制限・利用状況の把握)と従業員(認められた範囲で使う・秘密情報を入力しない)の役割を押さえると解けます。
要点と○×問題へ →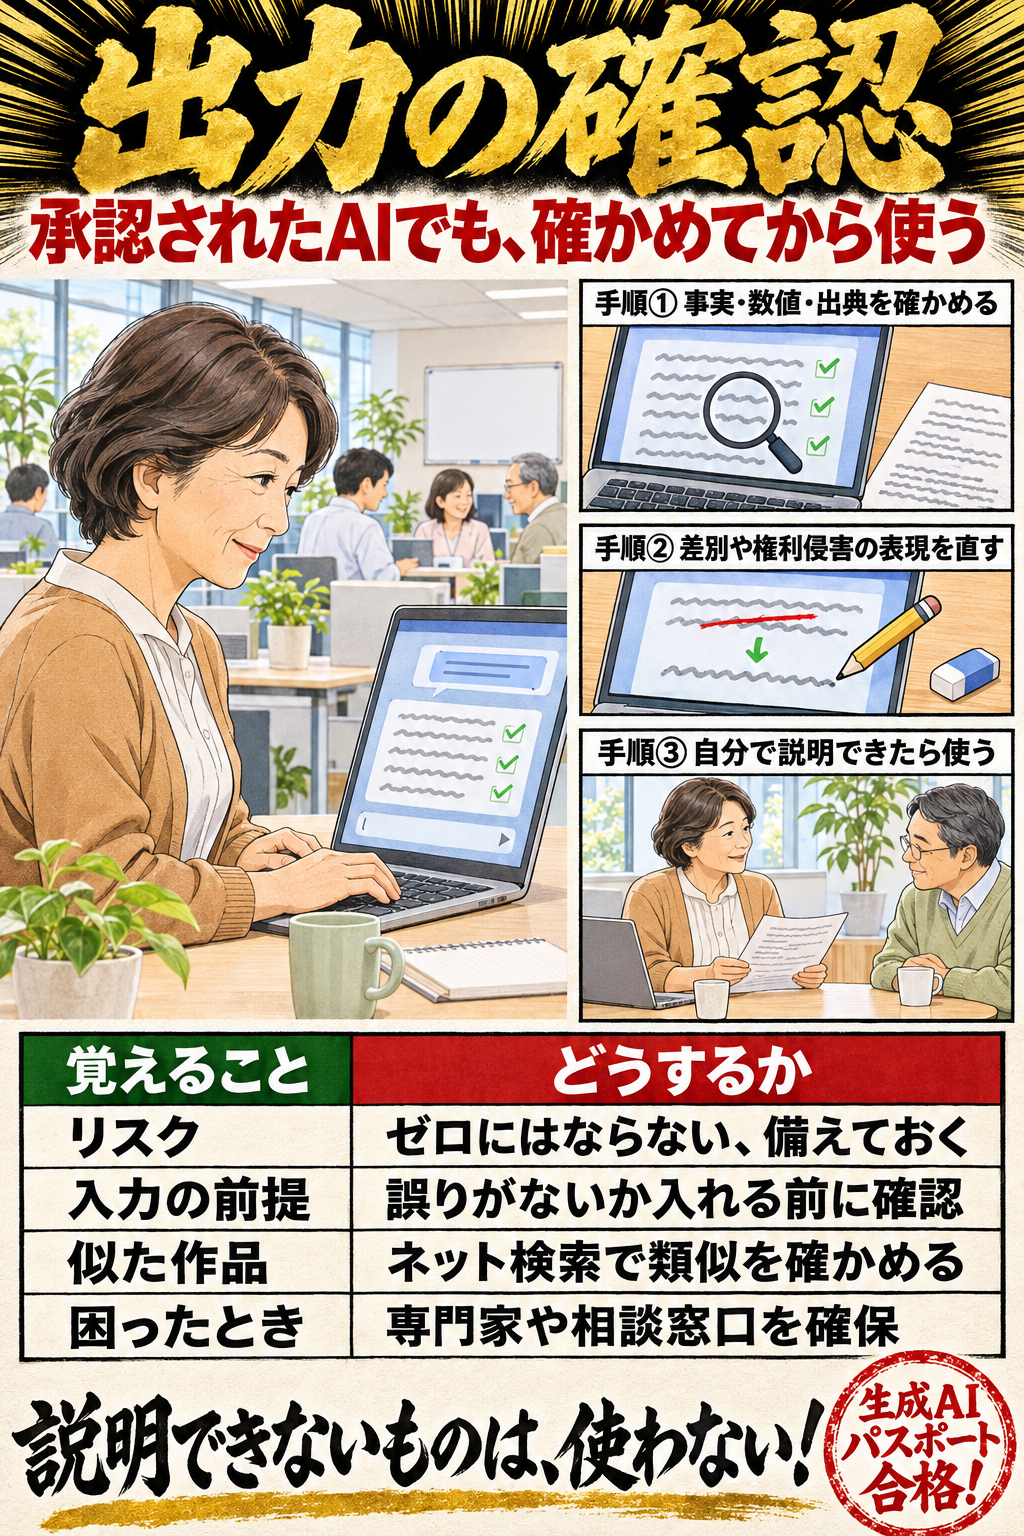
承認されたAIでも出力は必ずしも正しくなく、リスクはゼロにならないため、用途と影響度に応じた深さで確認します。事実・数値・出典・最新性(ファクトチェック)、入力した前提、差別的な表現・第三者の権利・機密性を確かめ、採用・修正・破棄(迷ったら使わない)・専門家への相談を判断することを押さえると解けます。
要点と○×問題へ →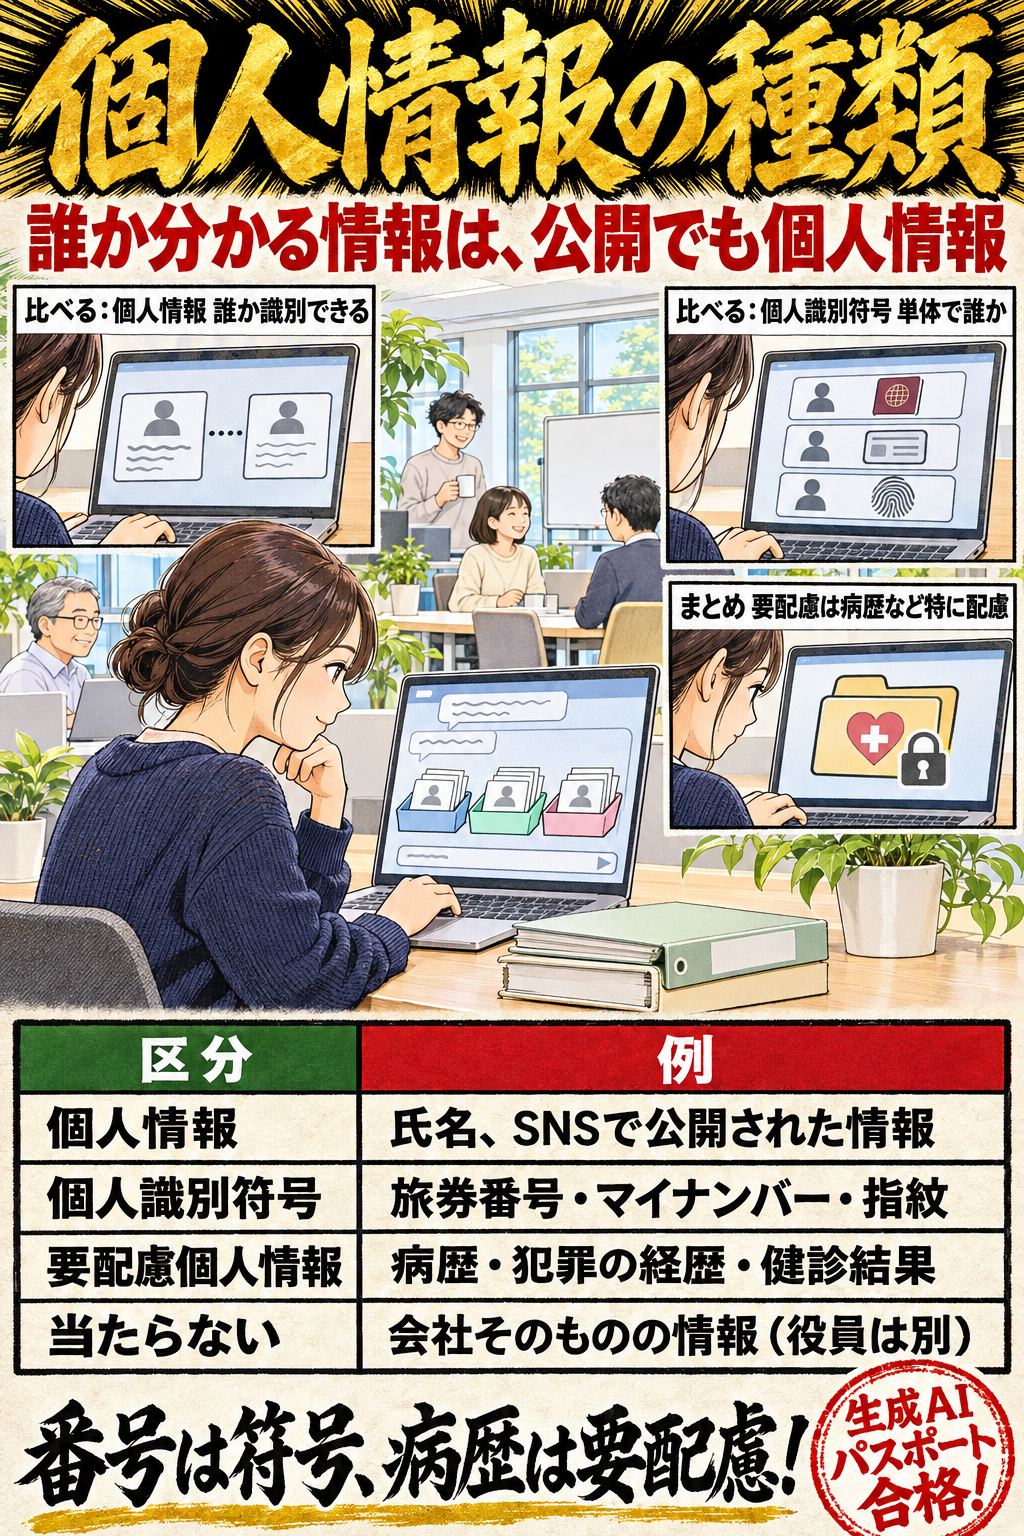
個人情報は、生存する個人に関する情報で、氏名などにより特定の個人を識別できるもの(他の情報と容易に照合して識別できるものを含む)か、個人識別符号を含むものです。個人識別符号(身体の特徴を変換した符号・旅券番号や個人番号などの番号)と、要配慮個人情報(人種・信条・病歴・犯罪の経歴など)の区別、金融分野で本籍地なども加えた機微(センシティブ)情報、公開情報も含まれること、営業秘密とは守る法律が違うことを押さえると解けます。
要点と○×問題へ →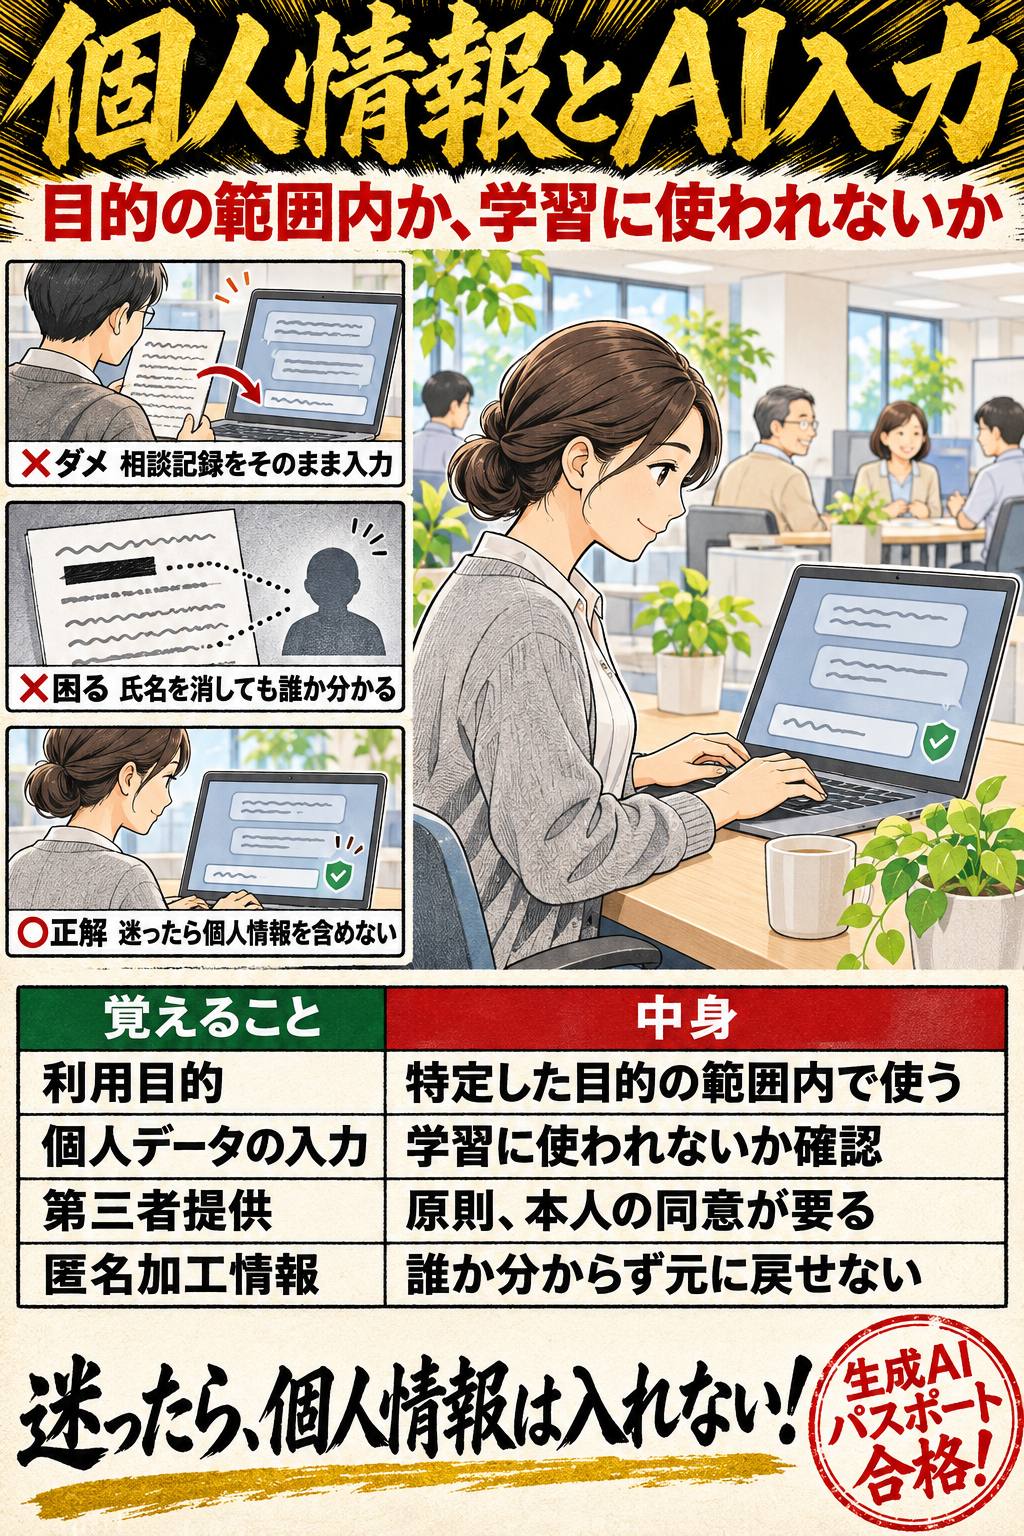
事業者が生成AIに個人情報を入力するときは、特定した利用目的の範囲内かを確かめ、個人データを入力する場合は、AIサービス側で応答以外(機械学習など)に使われないことを確かめます。第三者提供と委託の違い、氏名を伏せるだけでは個人情報でなくなるとは限らないこと、仮名加工情報と匿名加工情報の違い、令和8年改正は2026年11月時点で施行前であることを押さえると解けます。
要点と○×問題へ →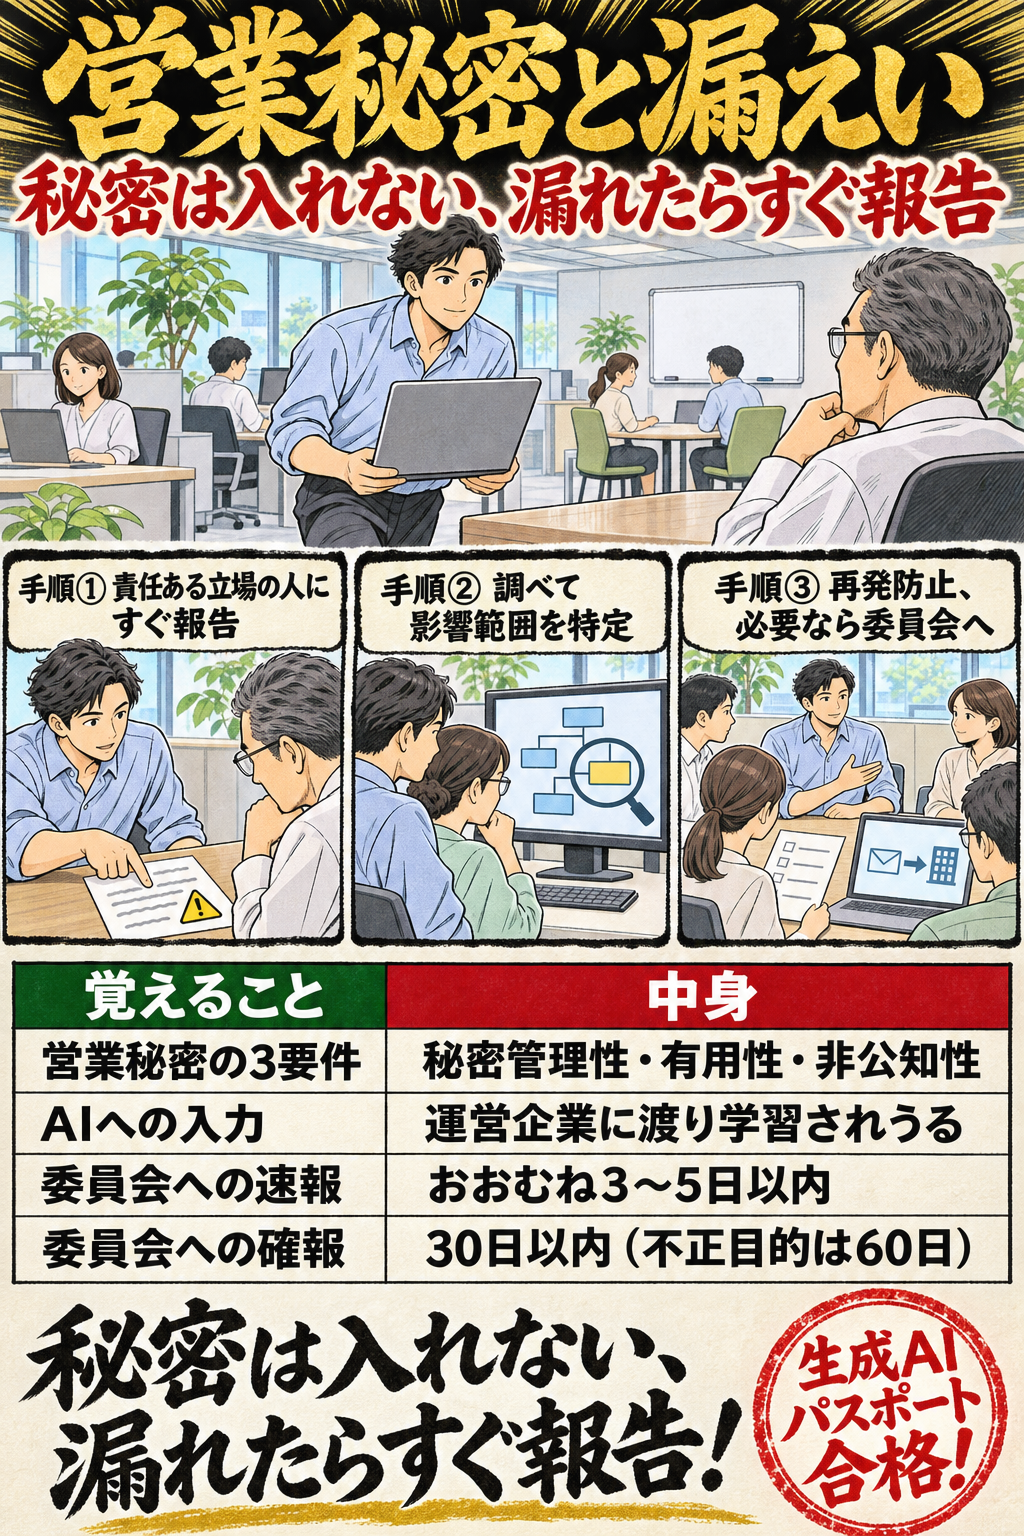
営業秘密は、秘密として管理され(秘密管理性)、事業活動に有用で(有用性)、公然と知られていない(非公知性)情報です。クラウドのAIに入力すると運営企業に渡り学習に使われうること、RAGや要約・共有で意図しない範囲へ広がること、漏えいが起きたら直ちに報告して被害の拡大を防ぎ、調査・影響範囲の特定・再発防止、報告の対象となる事態なら個人情報保護委員会への報告を行うことを押さえると解けます。
要点と○×問題へ →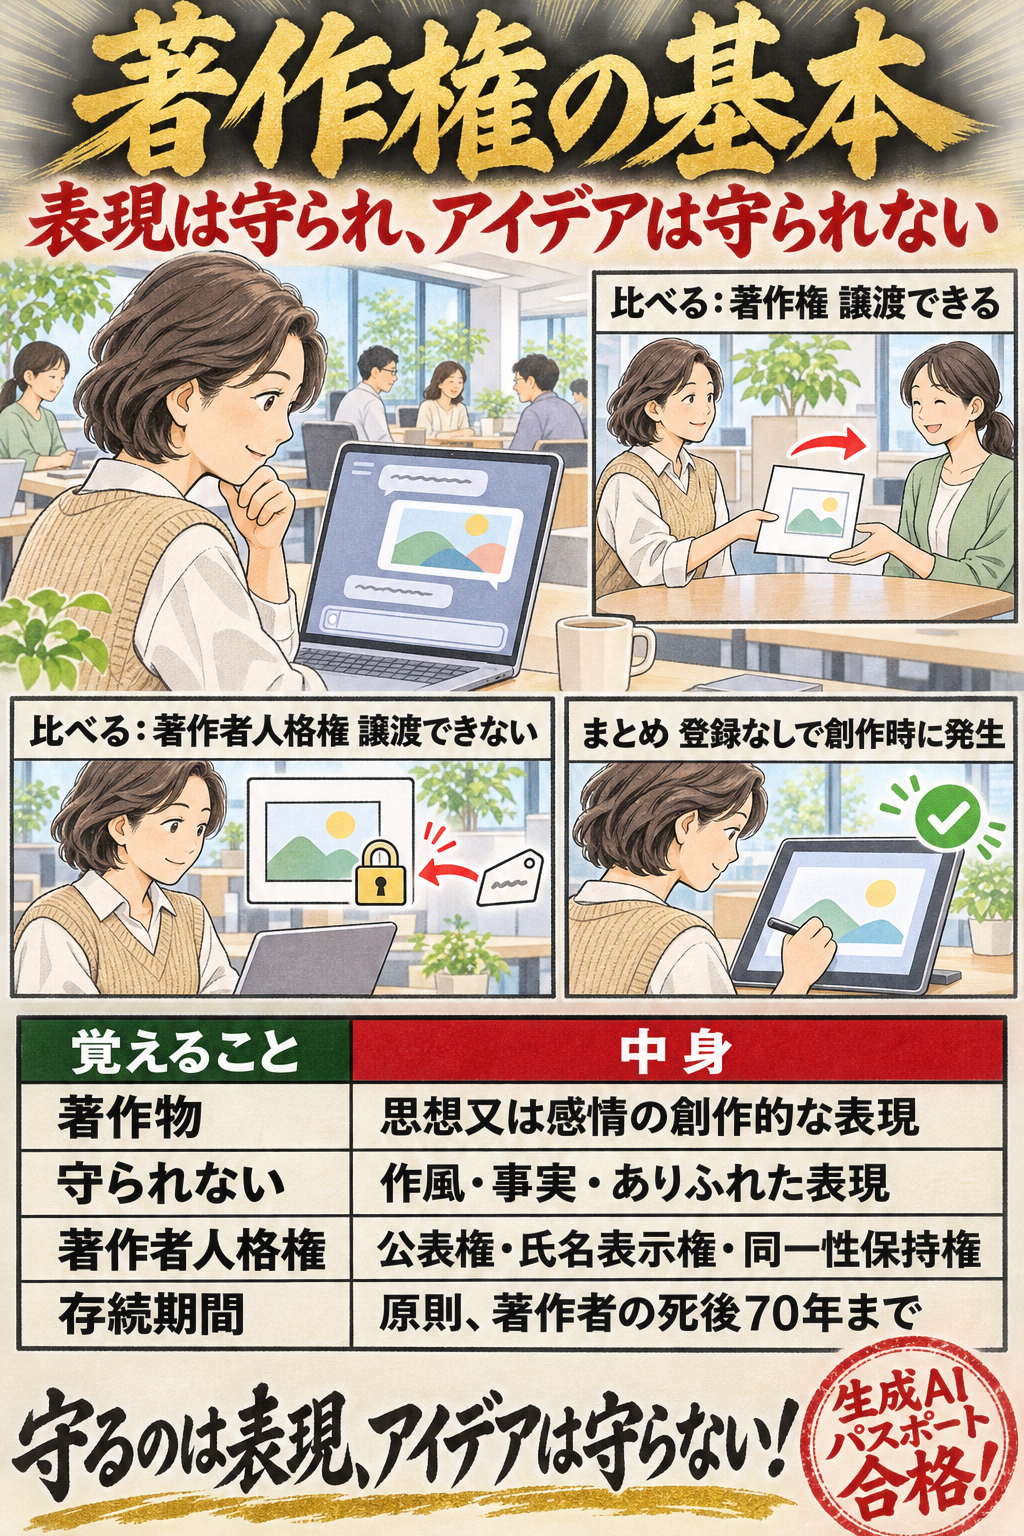
著作物は、思想又は感情を創作的に表現したもので、作風などのアイデアや単なる事実・データ、ありふれた表現は保護されません。著作権(複製権・翻案権など利用の形ごとの権利)と著作者人格権(公表権・氏名表示権・同一性保持権。譲渡できない)の違い、著作権は登録なしで創作の時に生じ、特許権などは登録で生じることを押さえると解けます。
要点と○×問題へ →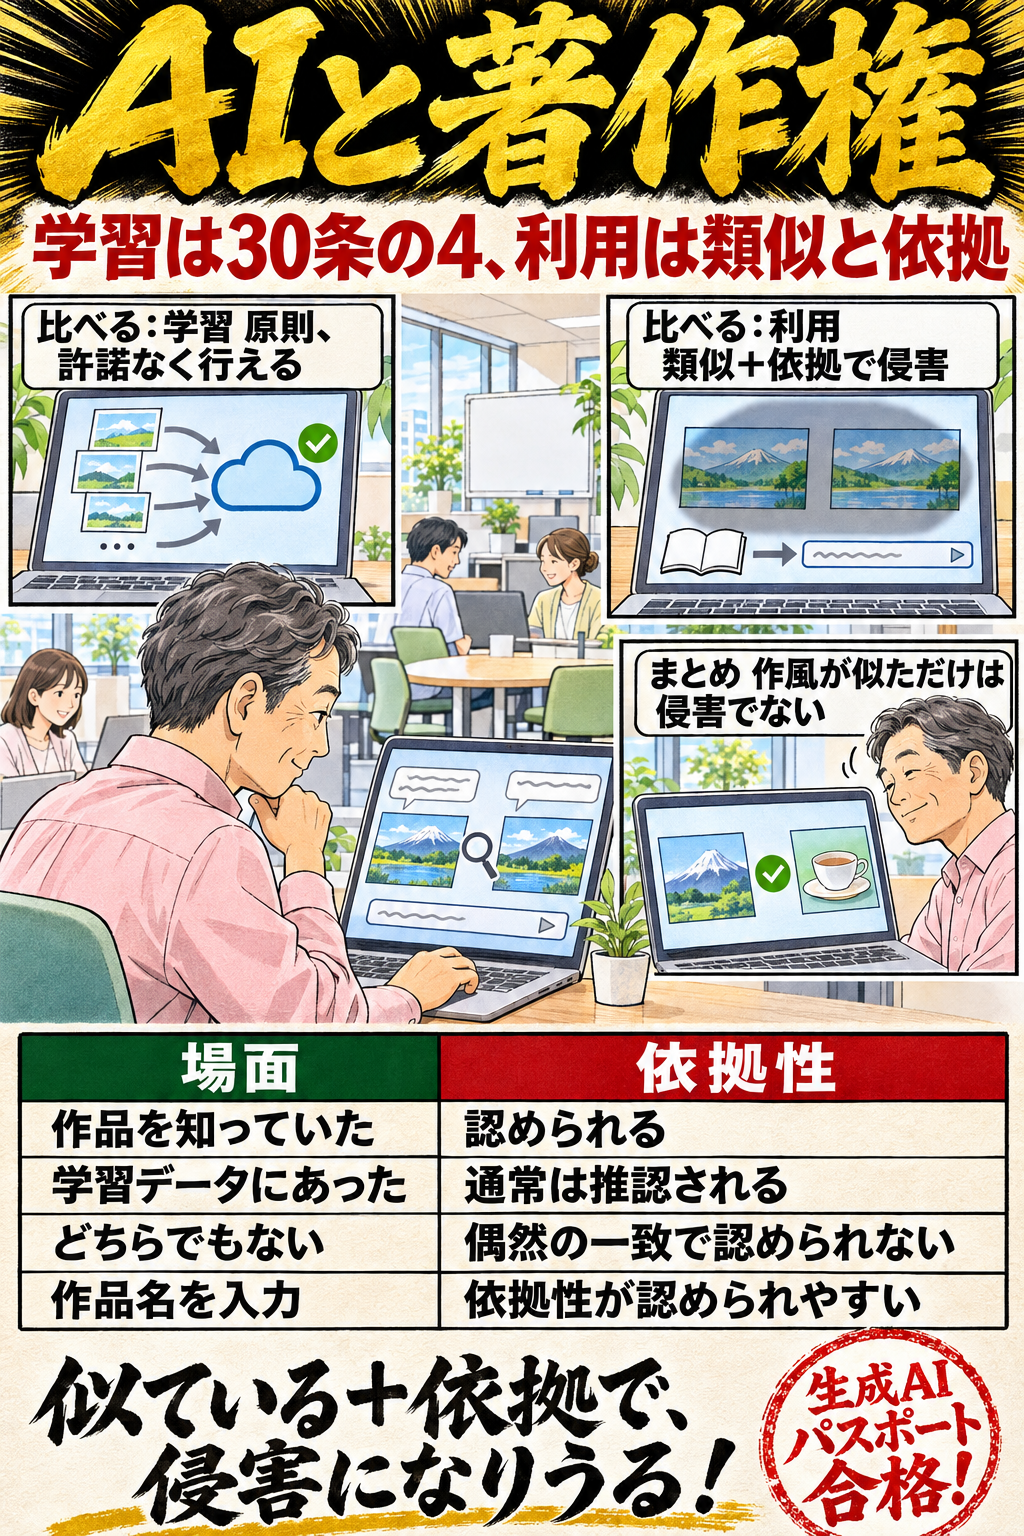
AIの開発・学習の段階では、著作物に表現された思想又は感情の享受を目的としない利用(情報解析など)として著作権法第30条の4が働く一方、著作権者の利益を不当に害することとなる場合は除かれます。生成・利用の段階では、AIを使わない場合と同じく既存の著作物との類似性と依拠性で侵害かどうかを判断することを押さえると解けます。
要点と○×問題へ →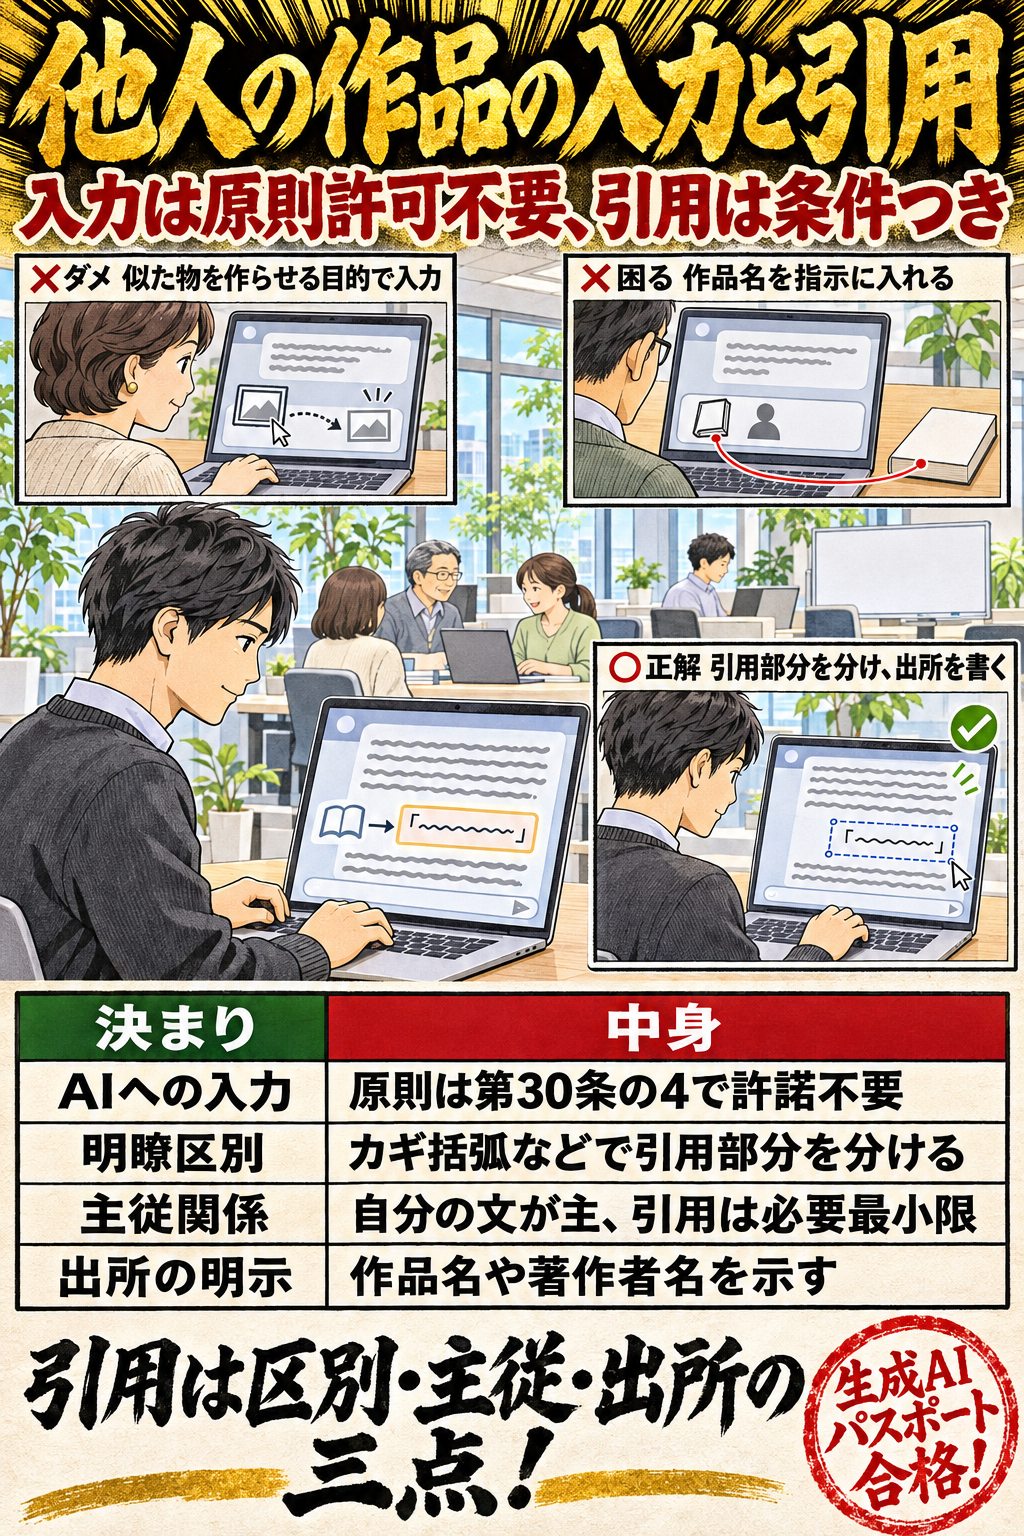
生成AIへの著作物の入力に伴う複製は原則として著作権法第30条の4の対象ですが、入力した著作物と似た物を作らせる目的なら適用されない場合があります。生成と利用で権利制限規定の当てはまり方が違うこと、引用の要件(第32条。引用部分をはっきり分ける・自分の文章が主で引用は従)と出所の明示(第48条)、翻案権(第27条)、似ているかは「創作的表現」が共通するかで決まることを押さえると解けます。
要点と○×問題へ →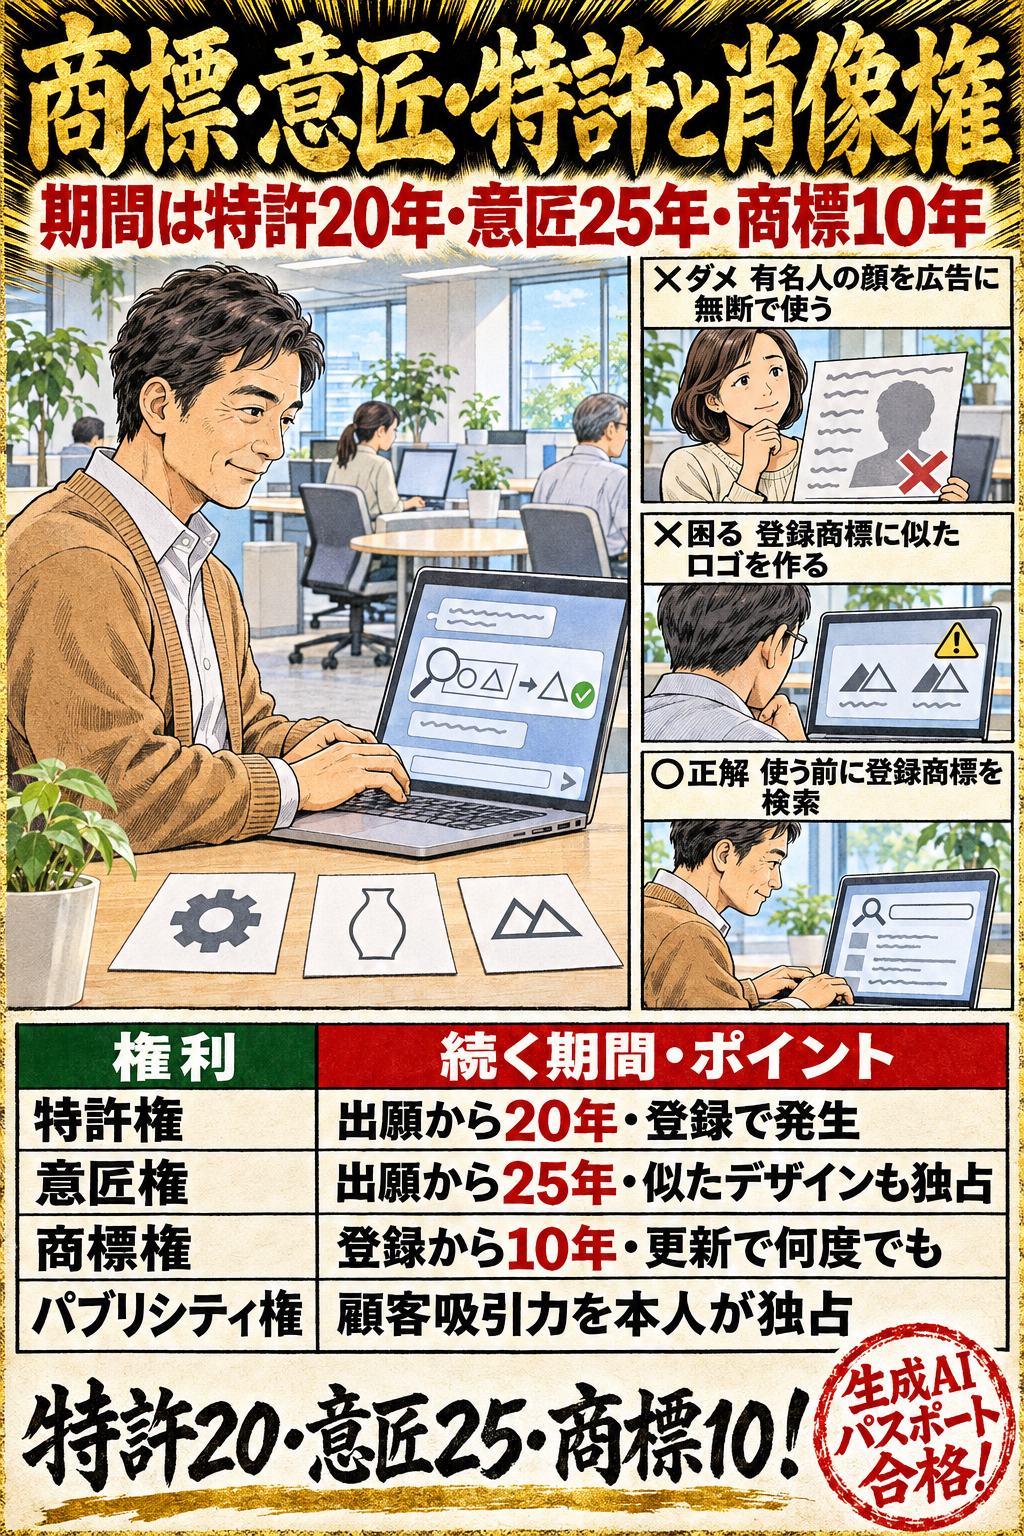
特許権(発明)・意匠権(デザイン)・商標権(マーク)は、特許庁への出願・登録で発生し、存続期間の起算点と長さ(特許は出願から20年、意匠は出願から25年、商標は登録から10年で更新可)が違います。肖像権・パブリシティ権には条文が無く、最高裁平成24年2月2日判決が、人格権に由来する権利として、専ら顧客吸引力の利用を目的とする無断使用が違法となる場合を示したことを押さえると解けます。
要点と○×問題へ →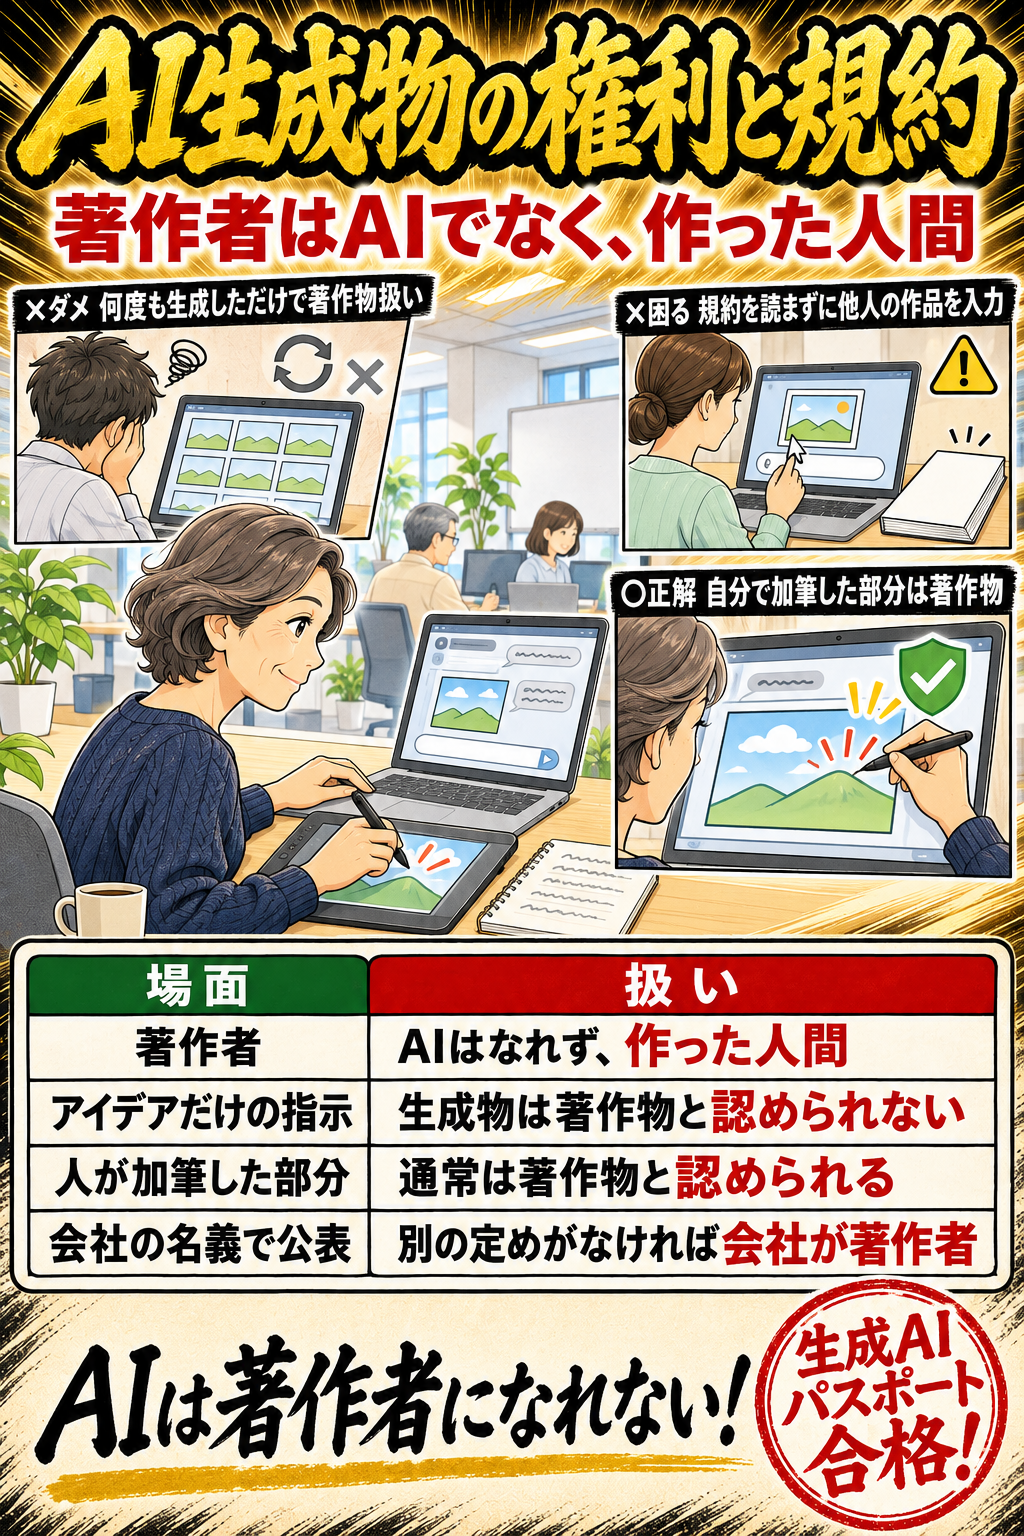
AIサービスは利用規約で他人の著作物の入力などを禁止・制限している場合があり、学習済みモデルの情報や入力内容の扱い(保存・学習)を使う前に確かめます。社外公開の前には似ていないかの確認と、生成過程の記録をします。AI生成物の著作物性は、指示がアイデアにとどまるか、人の創作的寄与があるかで判断し、AIは著作者にならないこと、職務著作の要件を押さえると解けます。
要点と○×問題へ →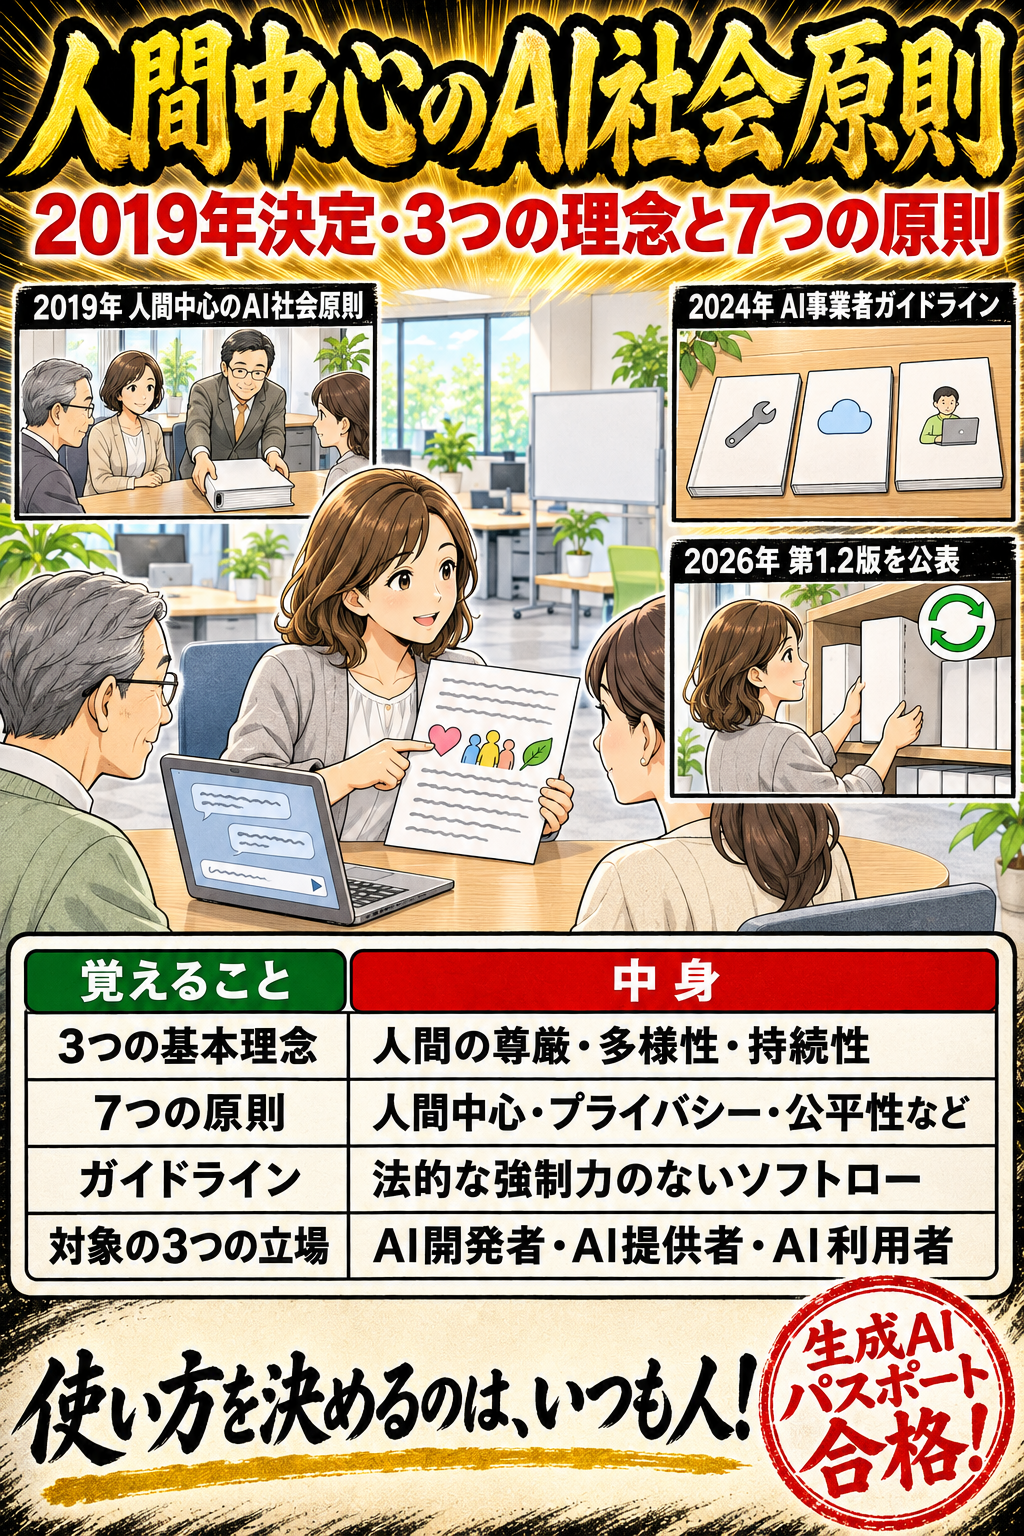
「人間中心のAI社会原則」(2019年3月、統合イノベーション戦略推進会議決定)の3つの基本理念と7つのAI社会原則、AI社会原則とAI開発利用原則の違いを押さえます。AI事業者ガイドラインはこの原則を土台にした、法的な強制力のないソフトローで、2026年11月時点の最新は第1.2版であること、AIの課題を倫理・法令・人権・安全の面から理解する姿勢が求められることを押さえると解けます。
要点と○×問題へ →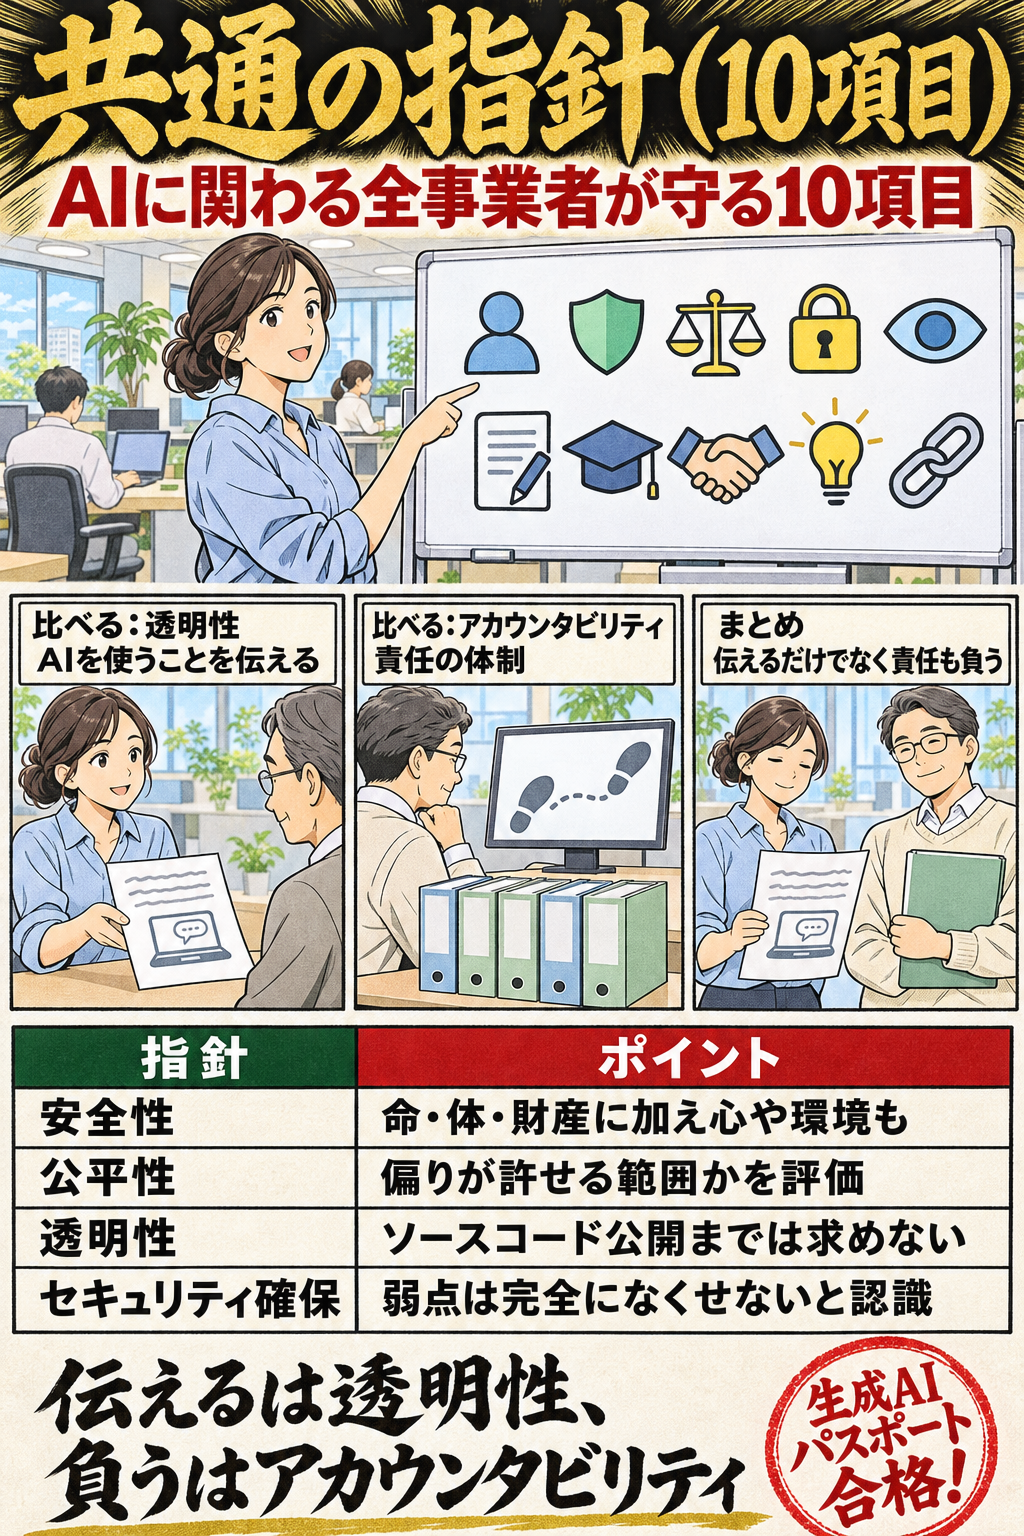
AI事業者ガイドライン(第1.2版)の「共通の指針」は10項目で、1)人間中心〜7)アカウンタビリティは各主体が取り組む事項、8)教育・リテラシー〜10)イノベーションは社会と連携して取り組むことが期待される事項です。安全性は精神・環境にも及ぶこと、避けられない偏りの評価、弱点(脆弱性)は完全には消せないこと、透明性はソースコードの公開まで必ず求めるものではないことなどを押さえると解けます。
要点と○×問題へ →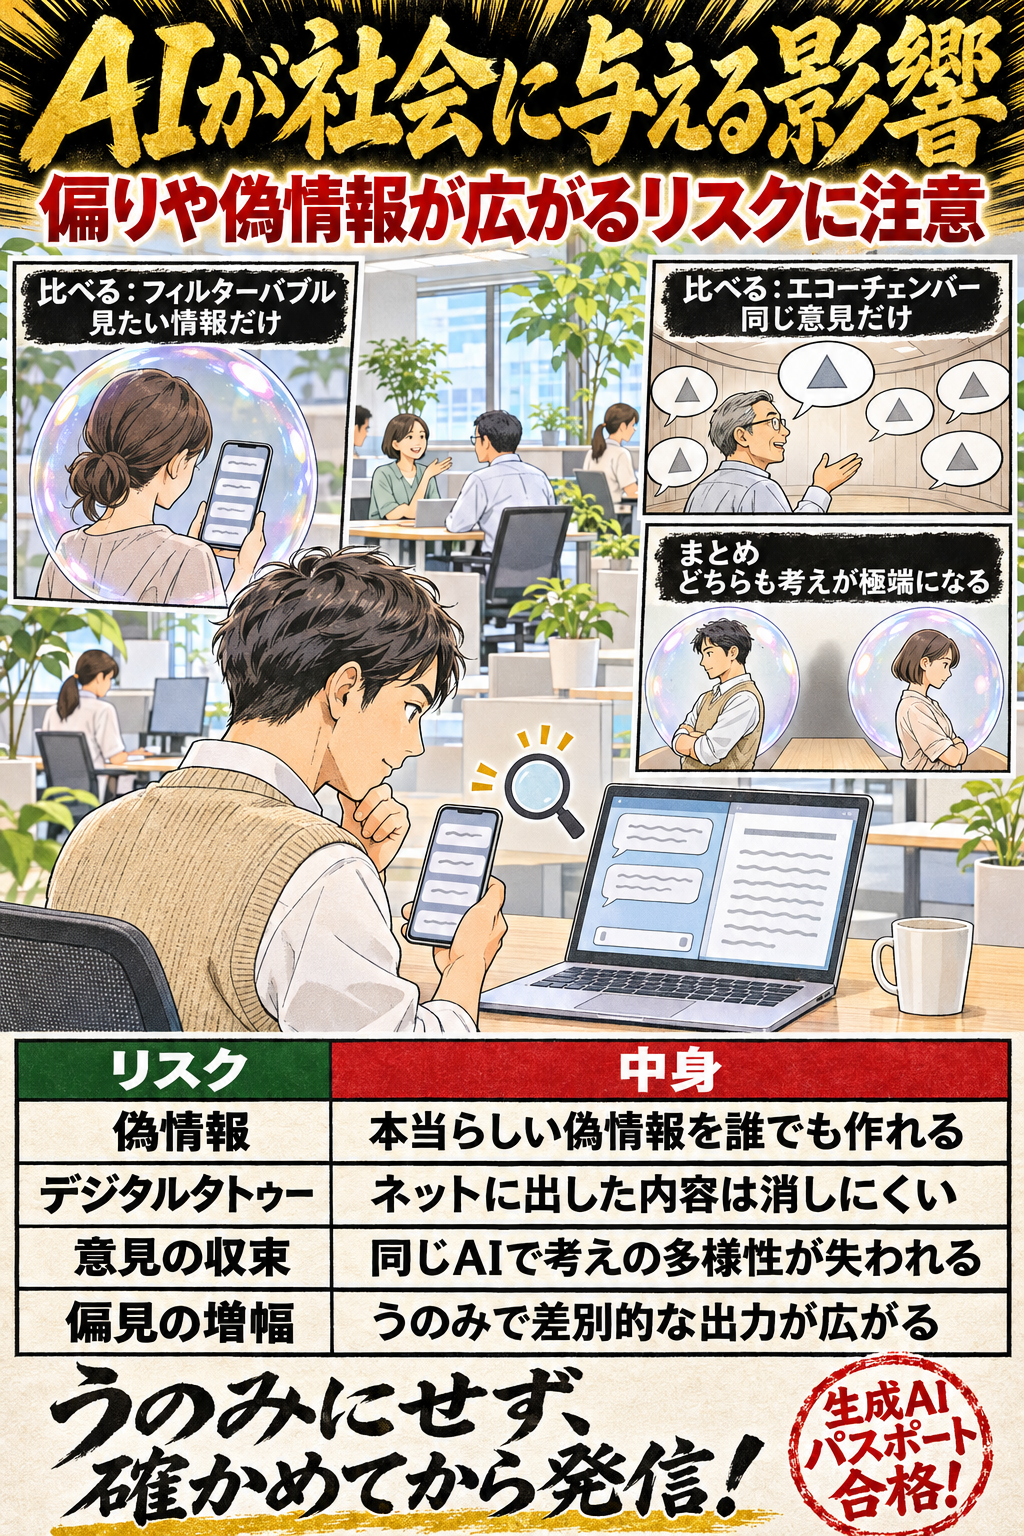
高度なAIシステム(最先端の基盤モデル・生成AIを含む)には、リスクの大きさに対策を合わせるリスクベースアプローチと、広島プロセス国際指針の措置(レッドチーム、電子透かし等)で臨みます。偽情報、フィルターバブルとエコーチェンバー、回答の収束、偏見の再生成、デジタルタトゥー、雇用・格差・環境負荷・過度な依存といった社会への影響を、一次資料の言い方で押さえると解けます。
要点と○×問題へ →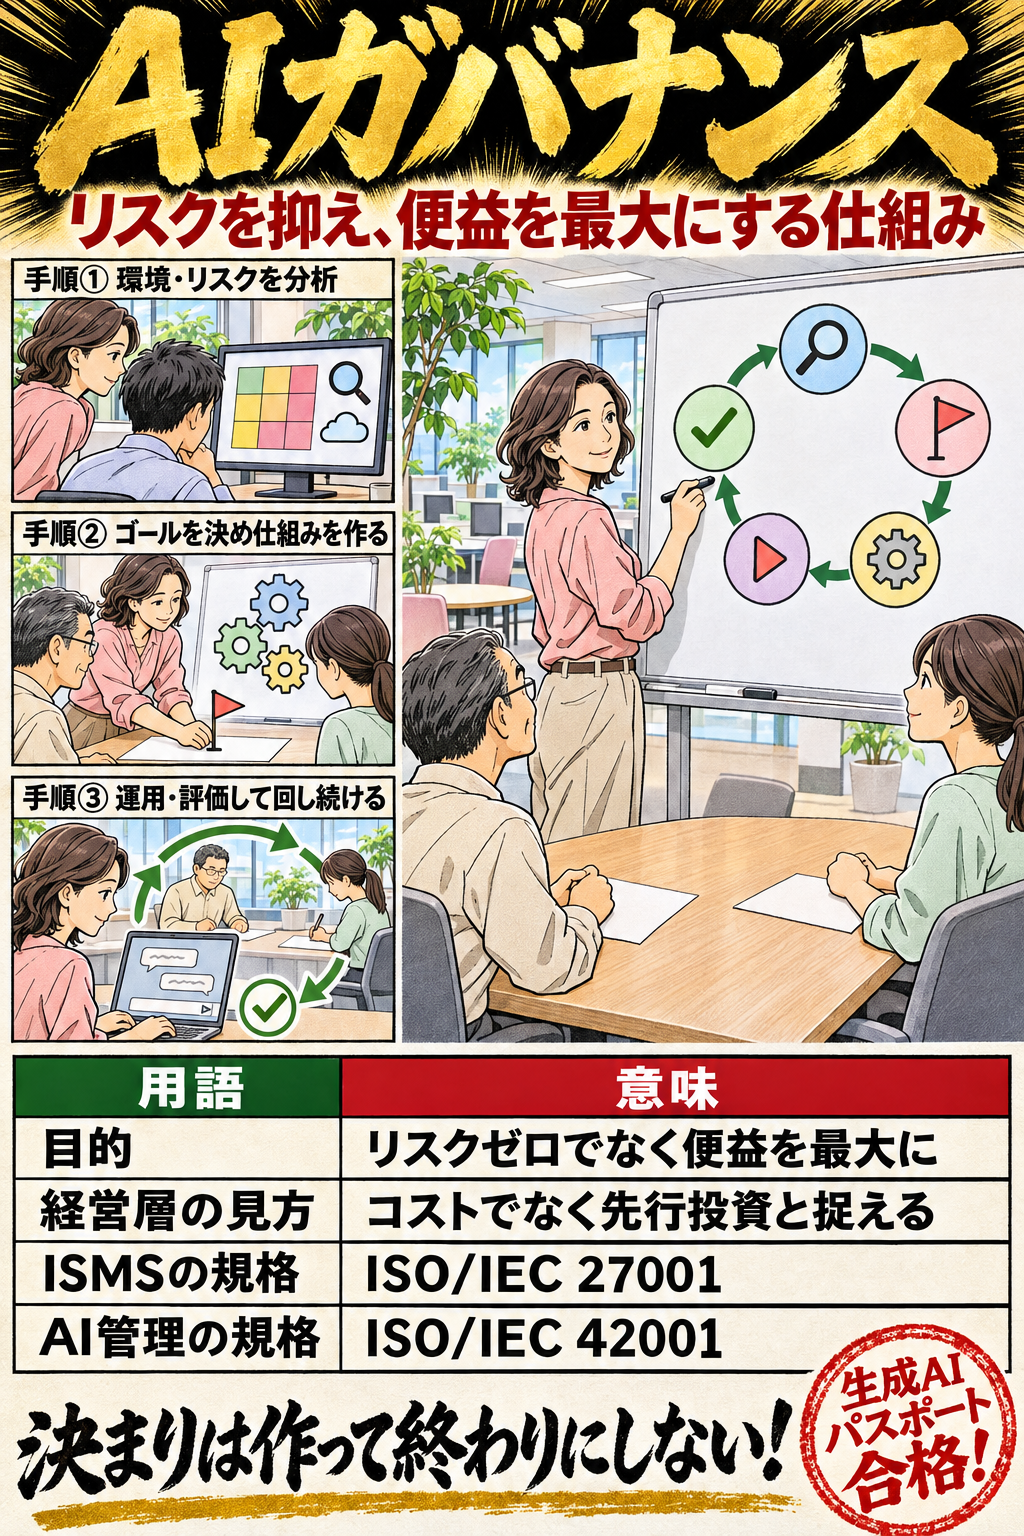
AIガバナンスは、リスクを受け入れられる範囲に抑えつつ便益を最大にするための仕組みづくりと運用で、決まりを固定せず「環境・リスク分析→ゴール設定→システムデザイン→運用→評価」を回すアジャイル・ガバナンスで進め、経営層が主導します。社内ルールの項目(使う前・入力・生成物の扱い)と、ツール選びで見る約款・SLA・外部認証(ISMS〈ISO/IEC 27001〉やSOC2)・データの保存先の国、利用者が持つバックアップなどを押さえると解けます。
要点と○×問題へ →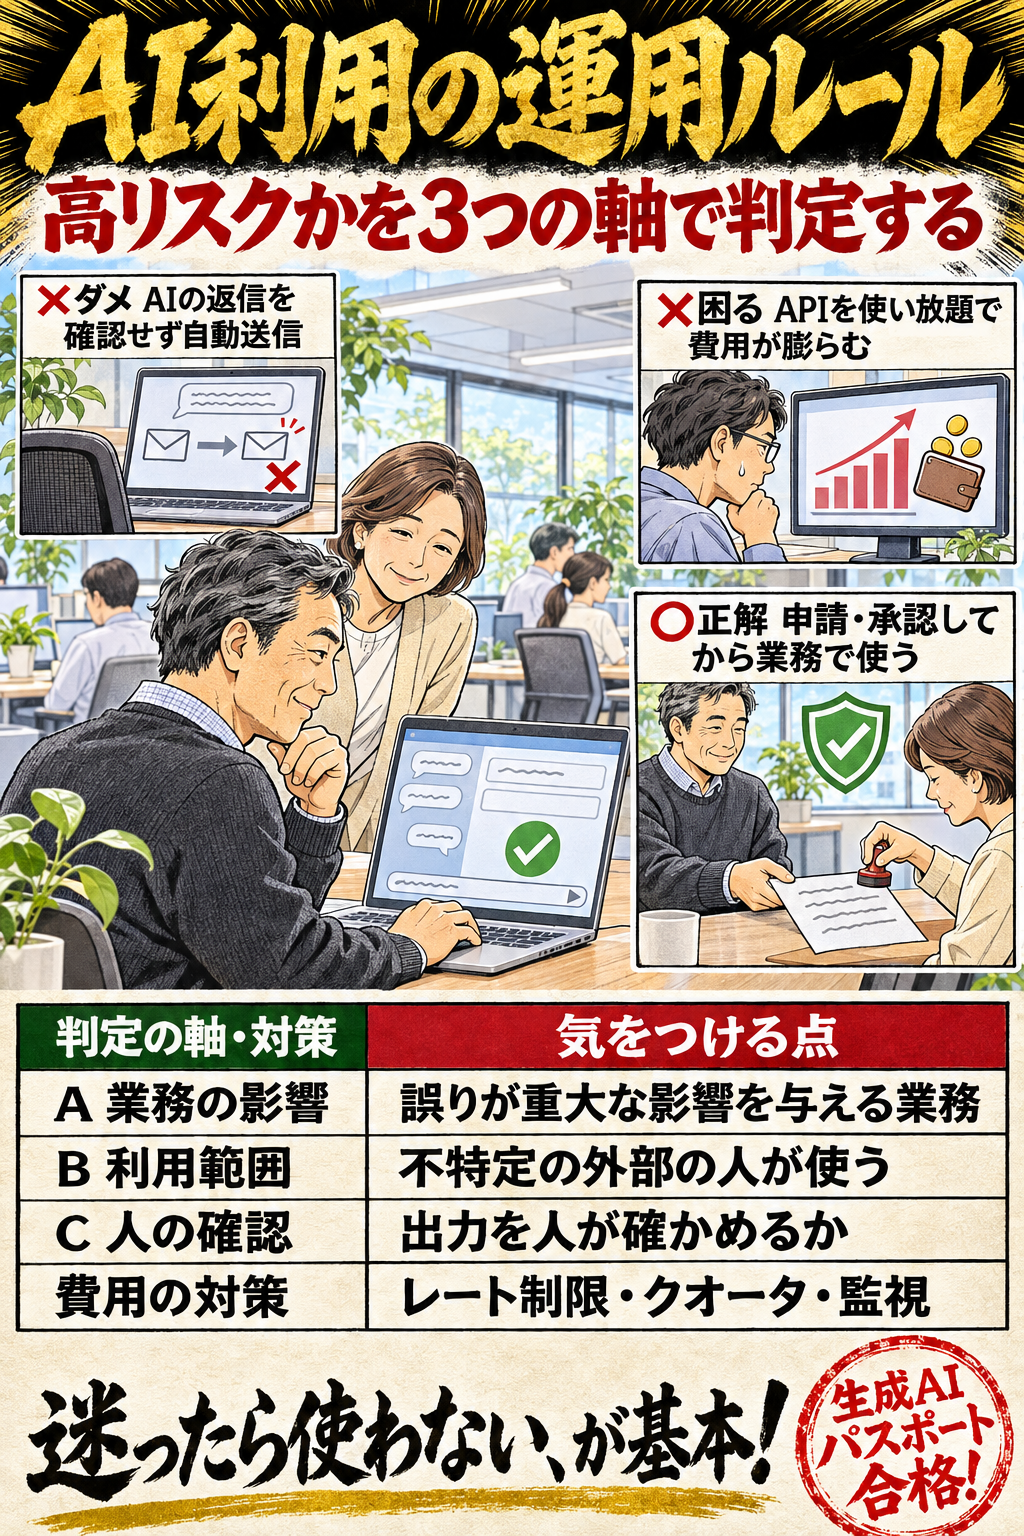
入力してよい情報は、ツールの契約の形(約款への同意だけのクラウド型か、個別契約か)と、業務の性格・利用範囲・出力を人が確かめるかで決めます。新しいツールは許可を得て使い、AI生成物は説明責任を持って確かめてから使います。APIの使いすぎ(Denial of Wallet)にはレート制限や上限、APIキーは別管理、研修は役割に応じて行い、外部の変化に合わせて見直すことを押さえると解けます。
要点と○×問題へ →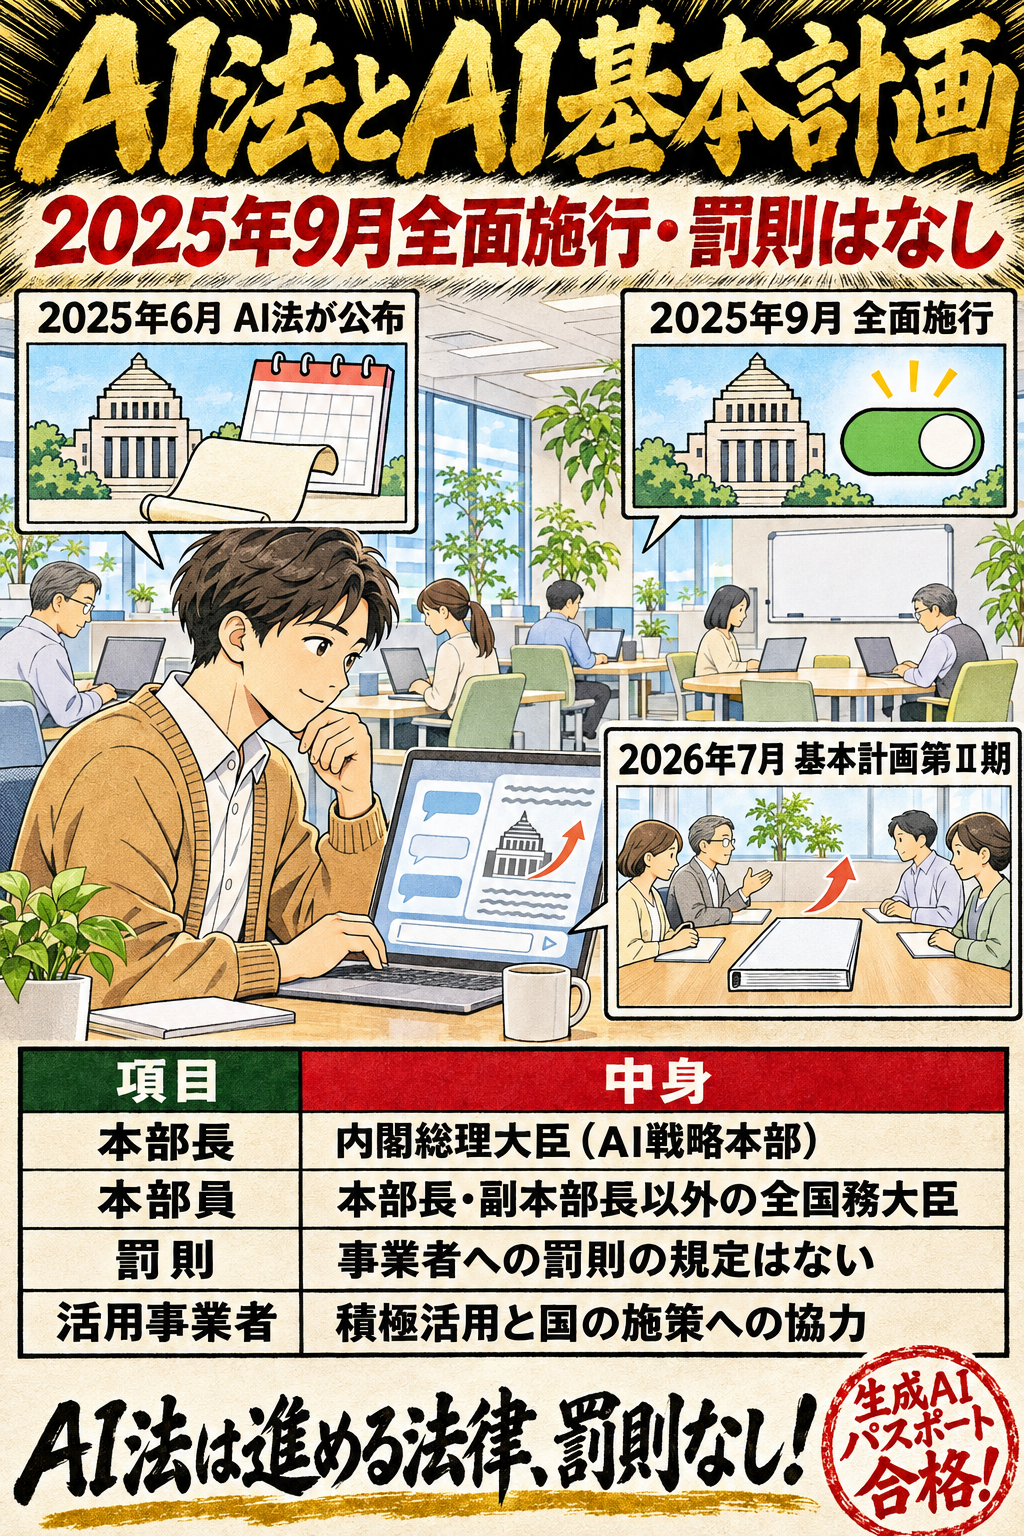
AI法は2025年6月4日公布・一部施行、9月1日全面施行の、AIの研究開発と活用を進めるための法律で、内閣に人工知能戦略本部(本部長は内閣総理大臣)を置き、第18条で人工知能基本計画(閣議決定)、第13条で適正性確保指針を定めます。活用事業者は国等の施策に「協力しなければならない」が罰則は無く、国民は「努める」。2026年11月時点の基本計画は第Ⅱ期(2026年7月14日)で当面は毎年変更、4原則と4つの基本的な方針を押さえると解けます。
要点と○×問題へ →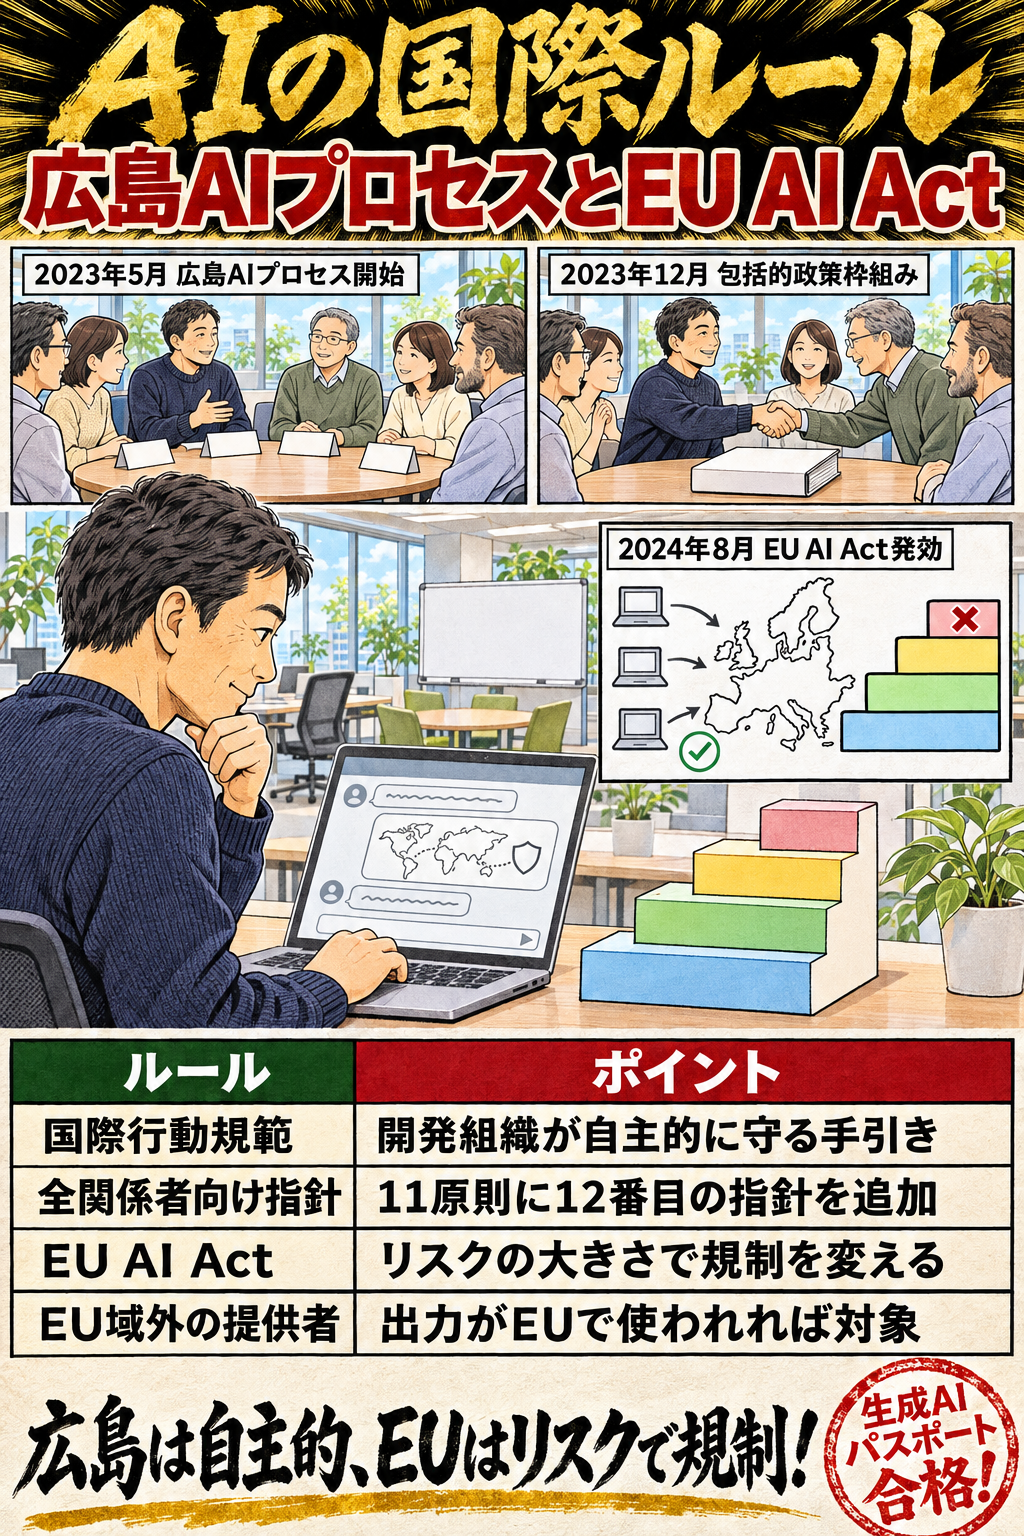
広島AIプロセスは2023年5月のG7広島サミットから始まり、同年12月に国際指針と国際行動規範からなる包括的政策枠組みがまとまりました(行動規範は自主的な手引き)。EU AI Actはリスクに応じて規制を変える規則で、2026年7月の改正で高リスクAI(Annex III)の適用が2027年12月2日に延びました。AI法・基本計画が示す安全保障、開かれた「AI主権」、日本語データ、AI人材とリ・スキリングを押さえると解けます。
要点と○×問題へ →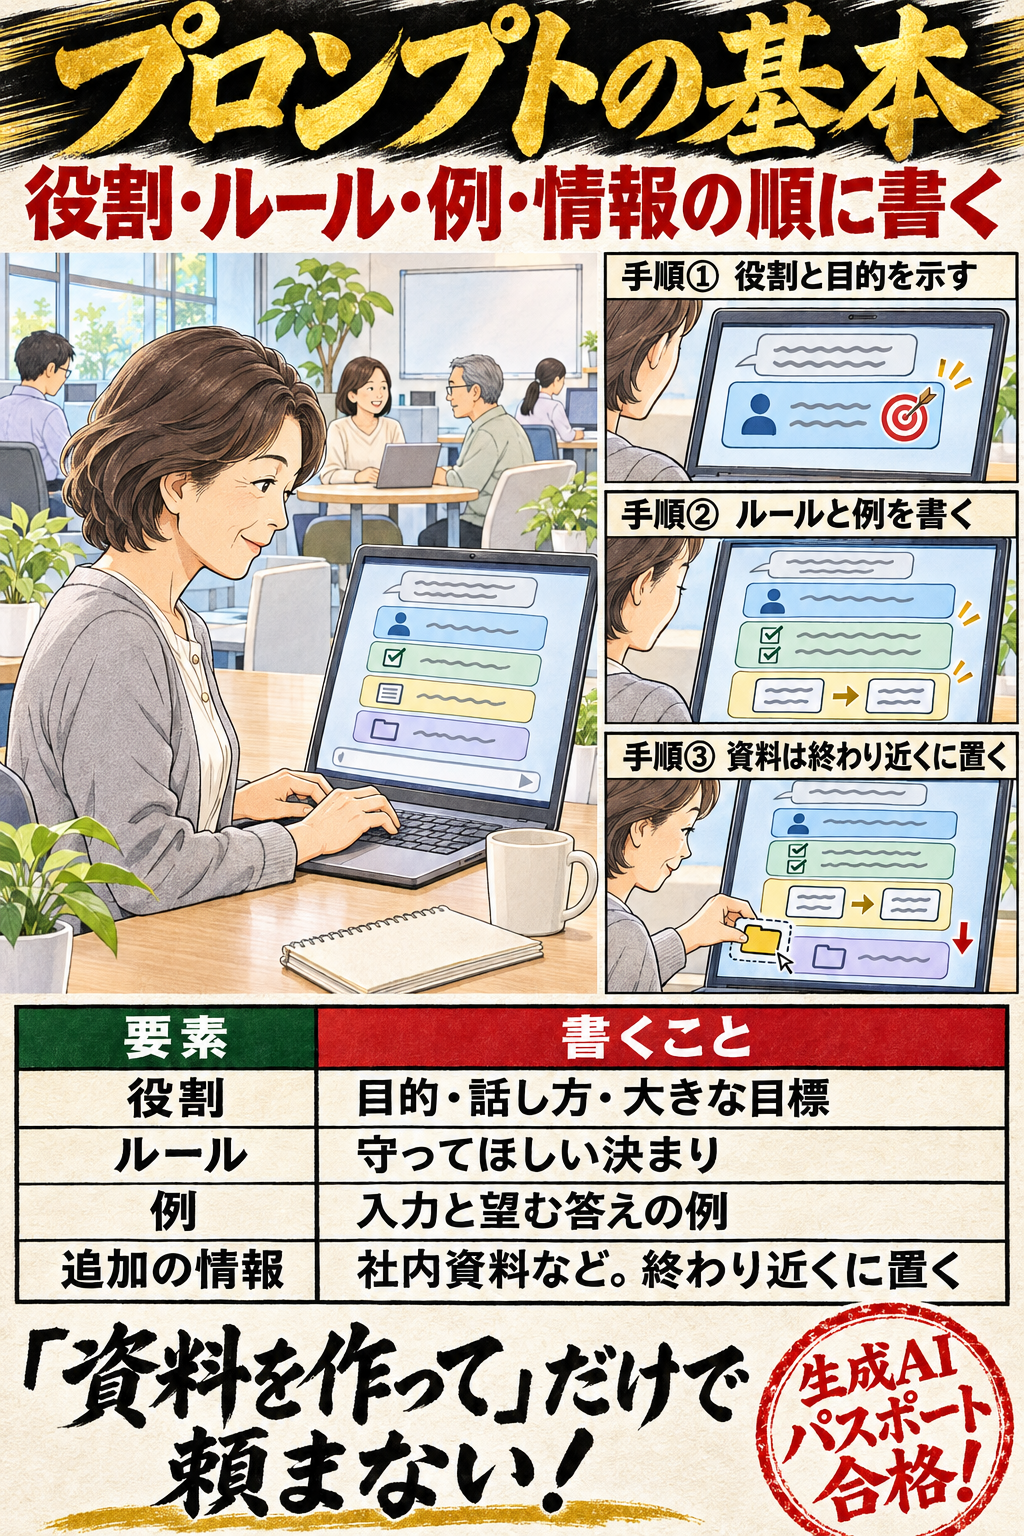
プロンプトエンジニアリングは、モデルが要件を満たす出力を安定して出すよう指示を書く工程です。出力は毎回同じとは限らないので試して直すこと、指示を目的・役割(Identity)・ルール(Instructions)・例(Examples)・参考情報(Context)に分けること、出力形式の指定、モデルの種類に合わせた具体度を押さえると解けます。
要点と○×問題へ →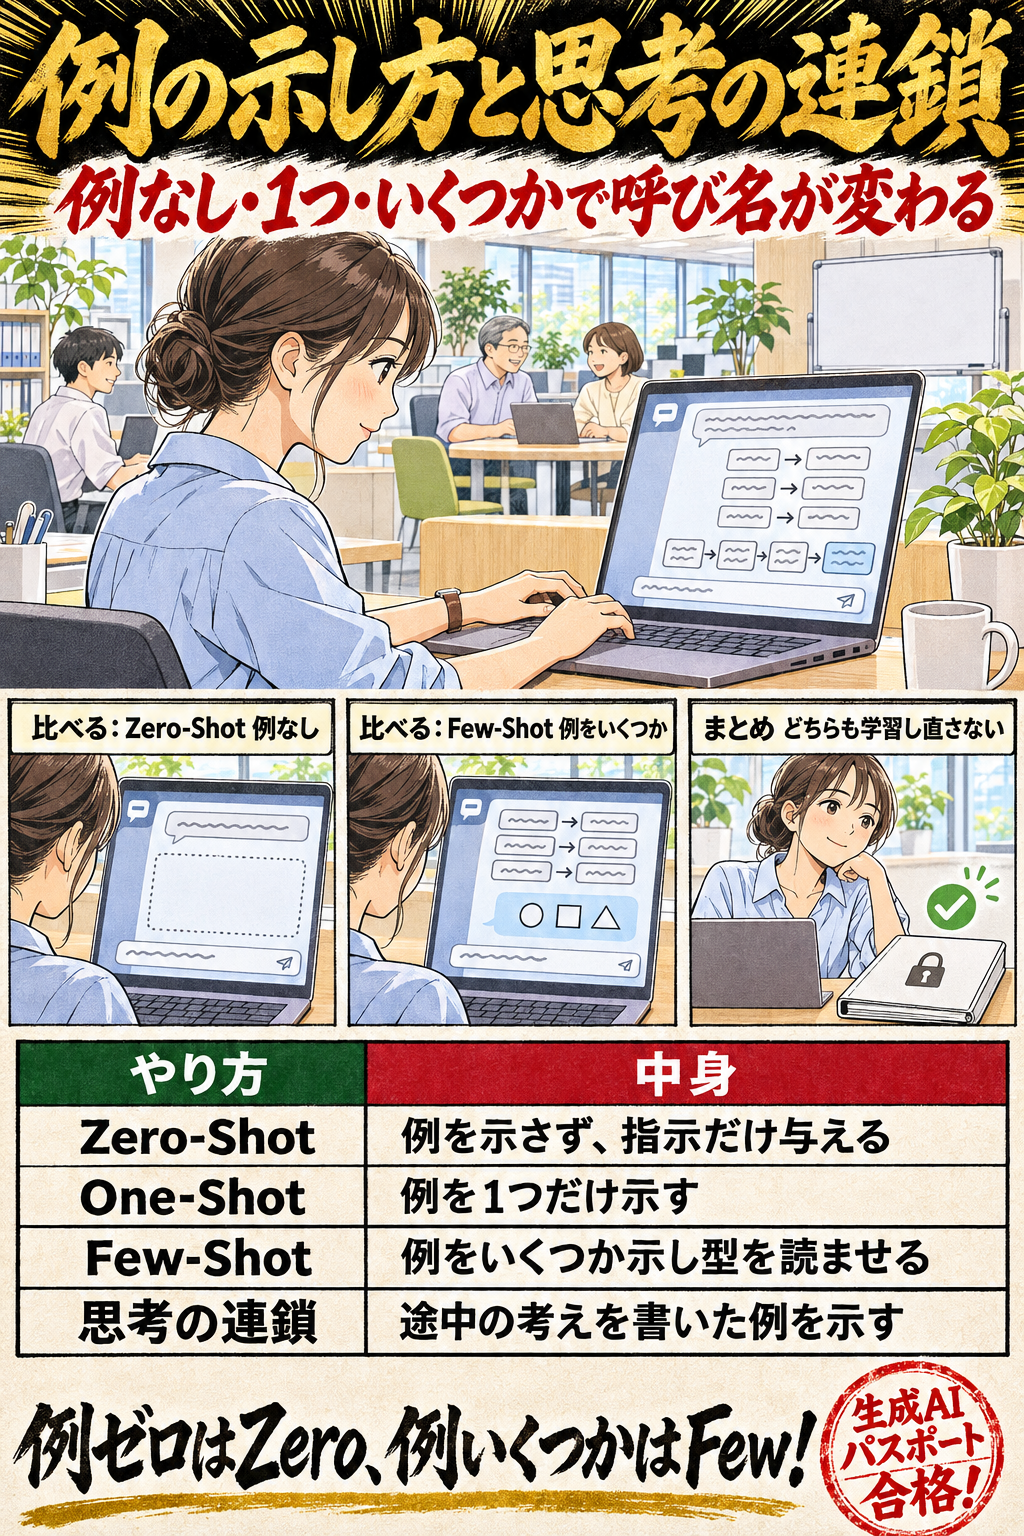
Zero-Shot は例を示さず指示だけ、One-Shot は例を1つ、Few-Shot は入力と答えの例をいくつか示すやり方で、どれもモデルの重みを更新しないコンテキスト内学習(In-Context Learning)です。Chain-of-Thought は答えまでの途中の考えを書かせる考え方で、十分に大きなモデルで、段階を踏む推論の性能が上がることを押さえると解けます。
要点と○×問題へ →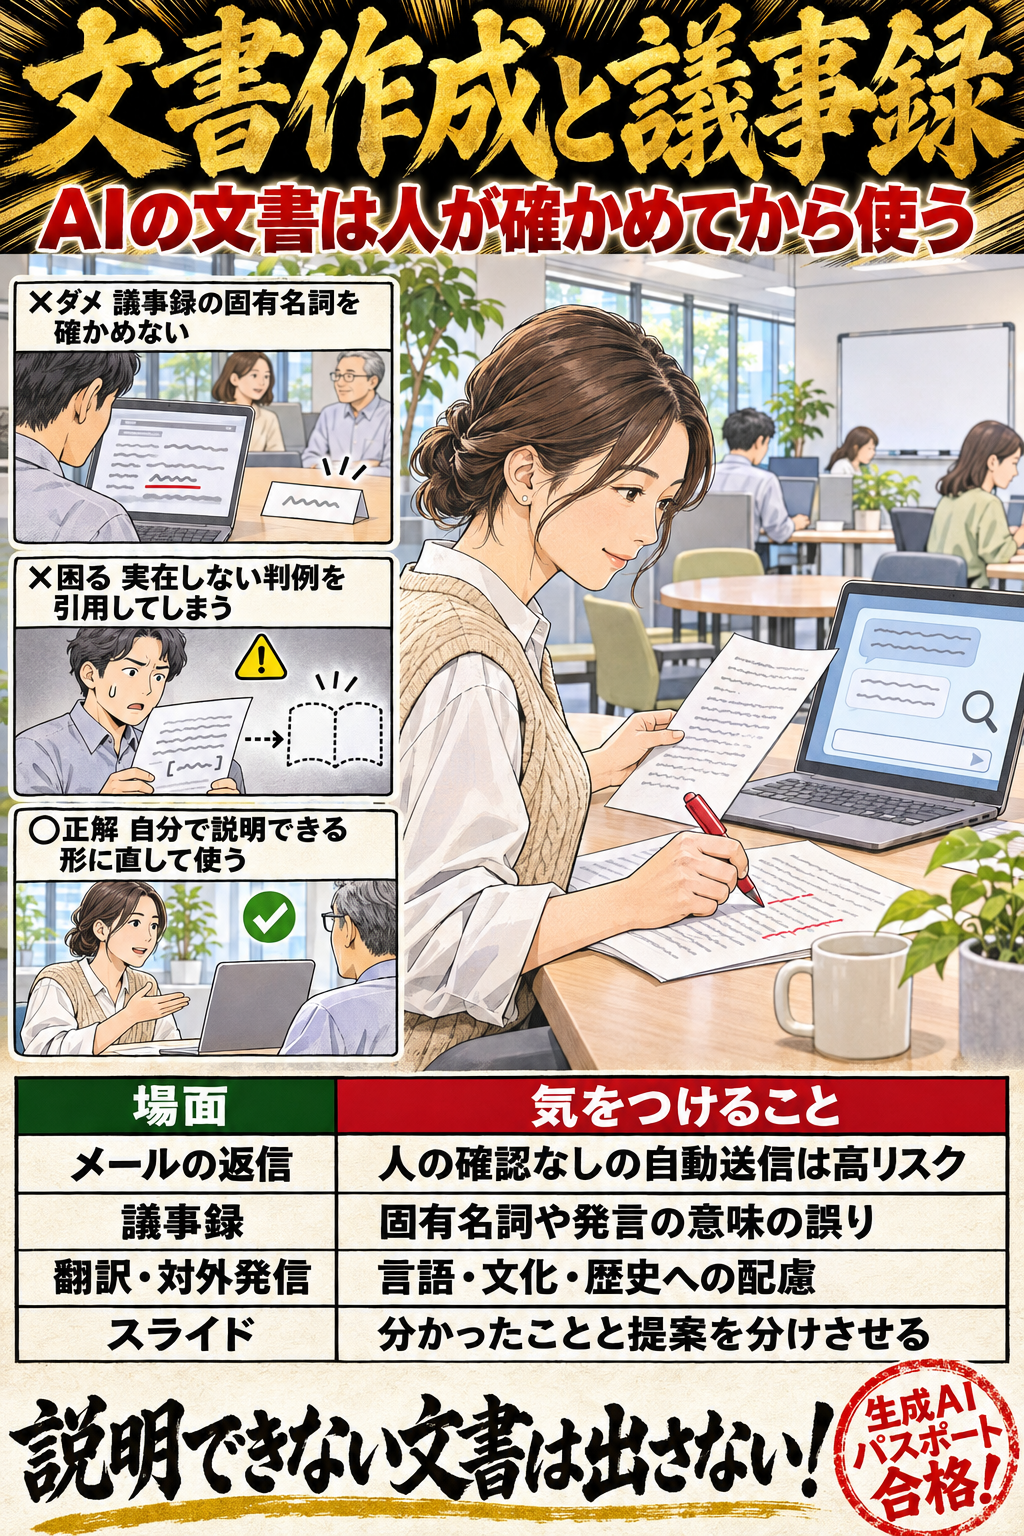
メール・文書の作成、校正・整形、要約・トーンの変更、議事録、翻訳、スライドに生成AIを使う場面で、人の確認を経ない自動送信は高リスク、入力する元の情報の正確さは利用者が確かめる、文字起こしの固有名詞の誤りや翻訳の文化的な背景に注意する、自分で説明できる形にして使う、引用の実在を確かめる、といった確認の勘所を押さえると解けます。
要点と○×問題へ →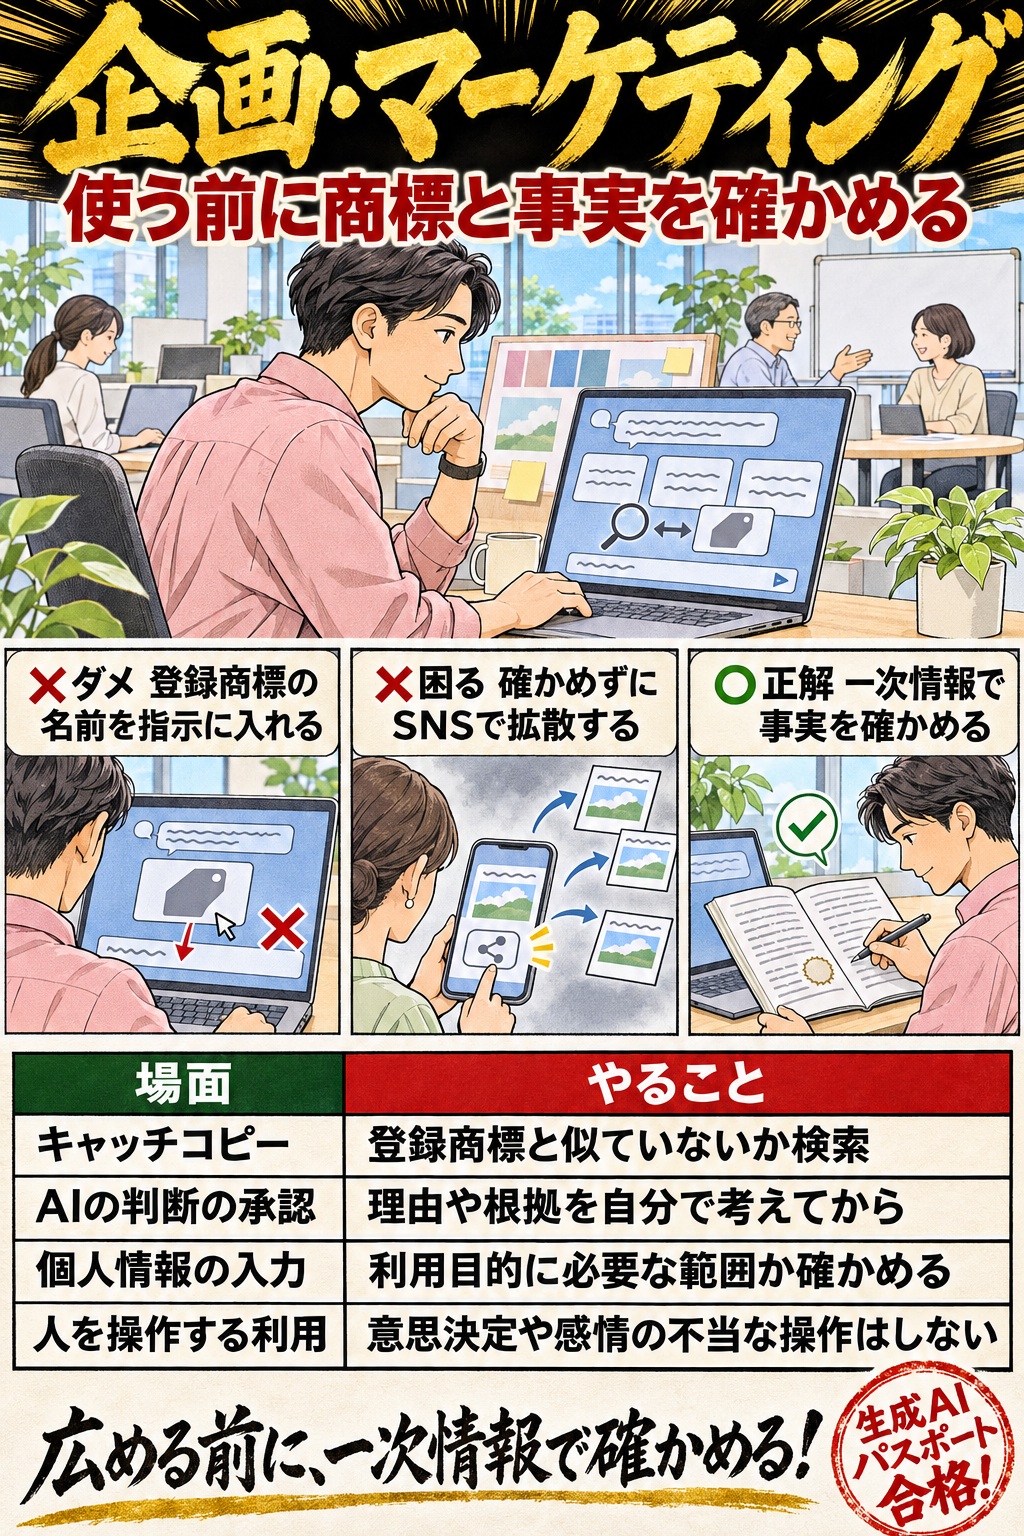
キャッチコピー・企画の壁打ち・アンケート・SNS・LP(ランディングページ)・市場や競合の調査に生成AIを使う場面で、登録商標との類似の確認、プロンプトと出力のバイアス、個人情報の利用目的、一次情報での事実確認、公開(利用)の前の類似の確認、架空の情報(ハルシネーション)への注意を押さえると解けます。
要点と○×問題へ →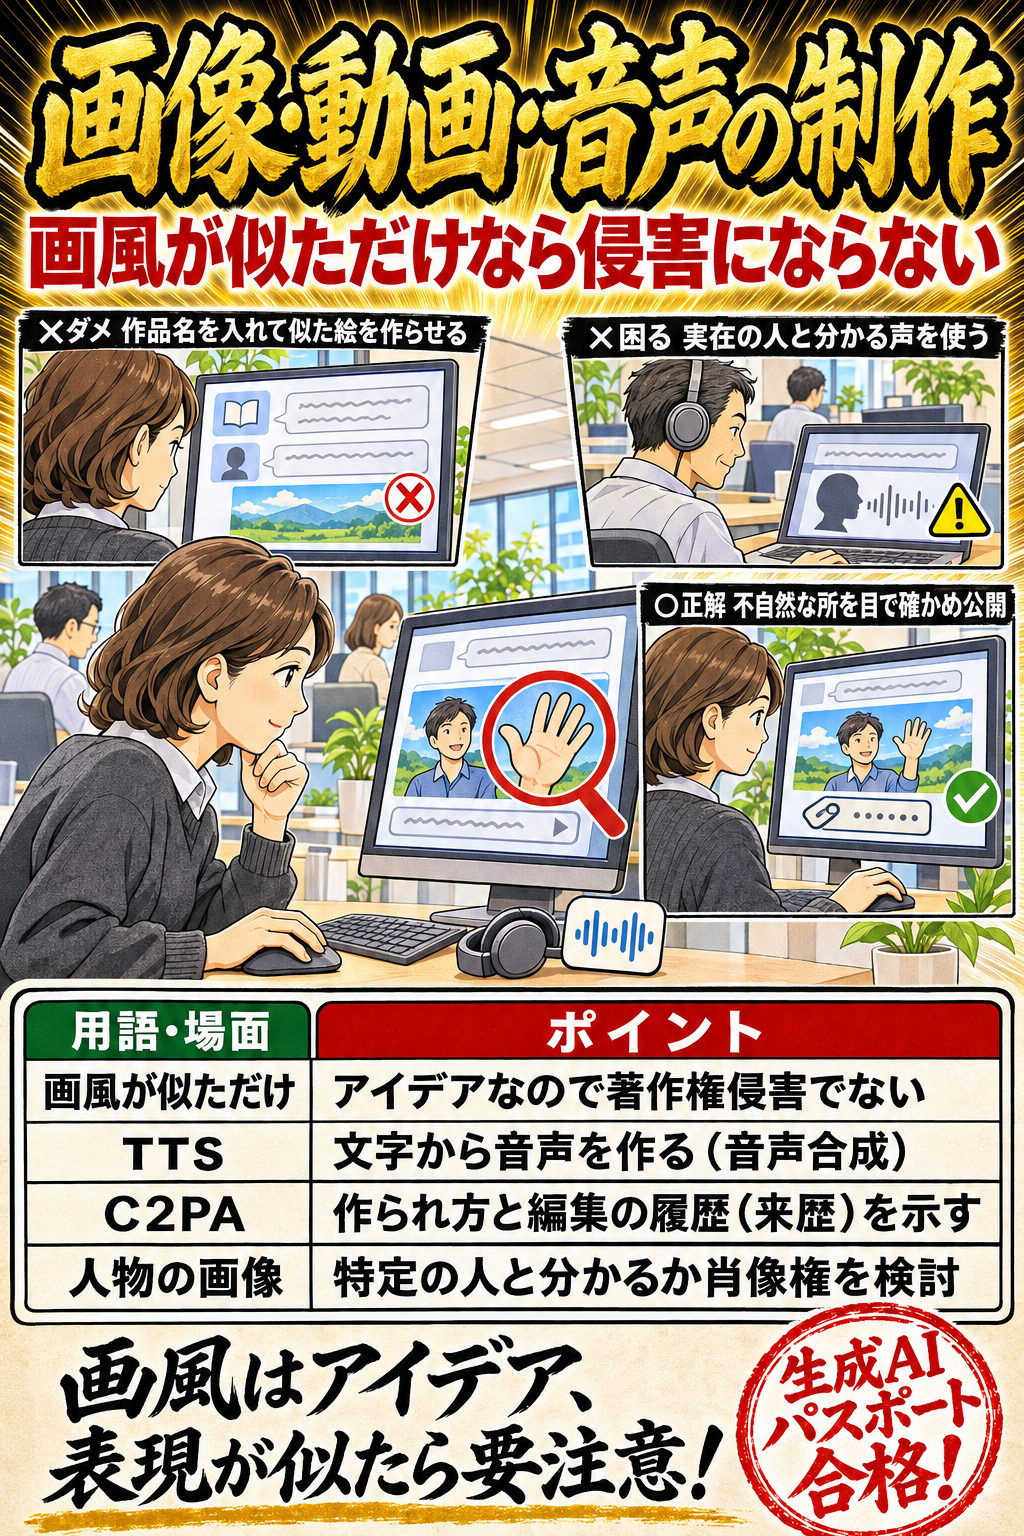
画像・動画・音声の生成と素材の展開では、作風が似ているだけなら著作権侵害にならない一方、既存作品を入力・名指しすると依拠性が認められやすいこと、生成と利用で判断が違うこと、著作物性は人の創作的な関わりで決まること、人の肖像・声の確認、利用規約(ライセンス条件)の確認、来歴を示す C2PA の Content Credentials、多言語への展開での文化的な配慮を押さえると解けます。
要点と○×問題へ →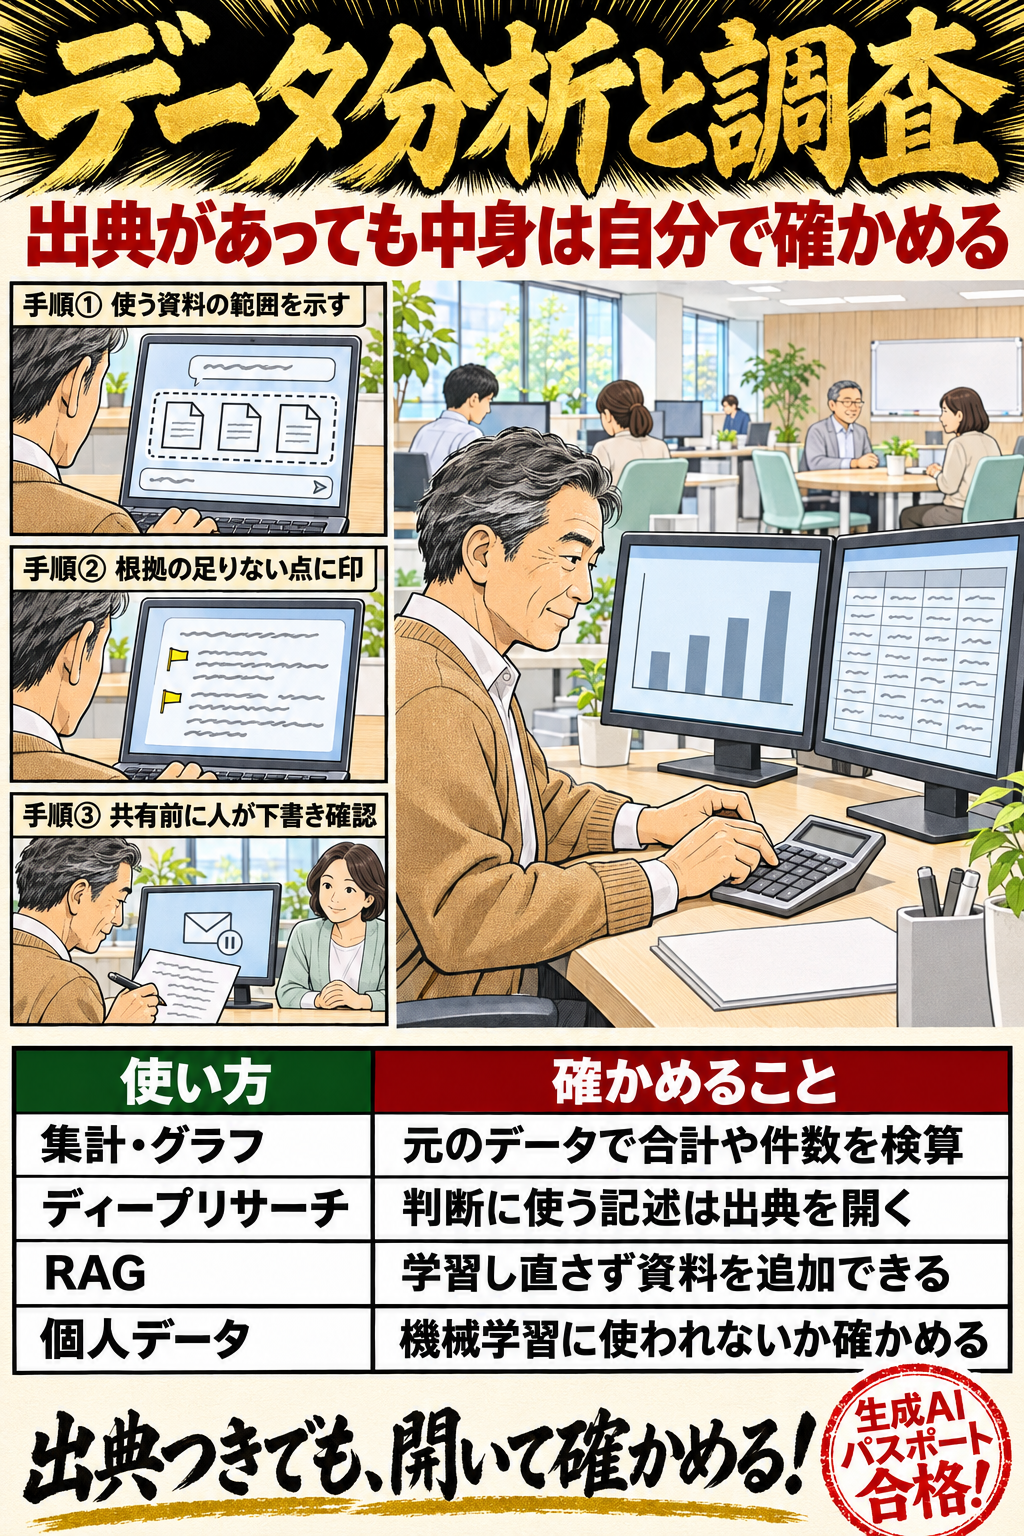
データの整形・分類、集計・可視化、大量の文書からの抽出、複数の情報源の横断調査(ディープリサーチ)、定例レポートの自動化に生成AIを使う場面で、個人データを入れる前の確認、入力データの正確さと集計の検算、RAG の仕組みと検索範囲の制限、参照元の確認、ディープリサーチのレポートにも事実の誤りがありうることと出典の範囲、人の確認を挟む自動化(ワークフロー型エージェント)を押さえると解けます。
要点と○×問題へ →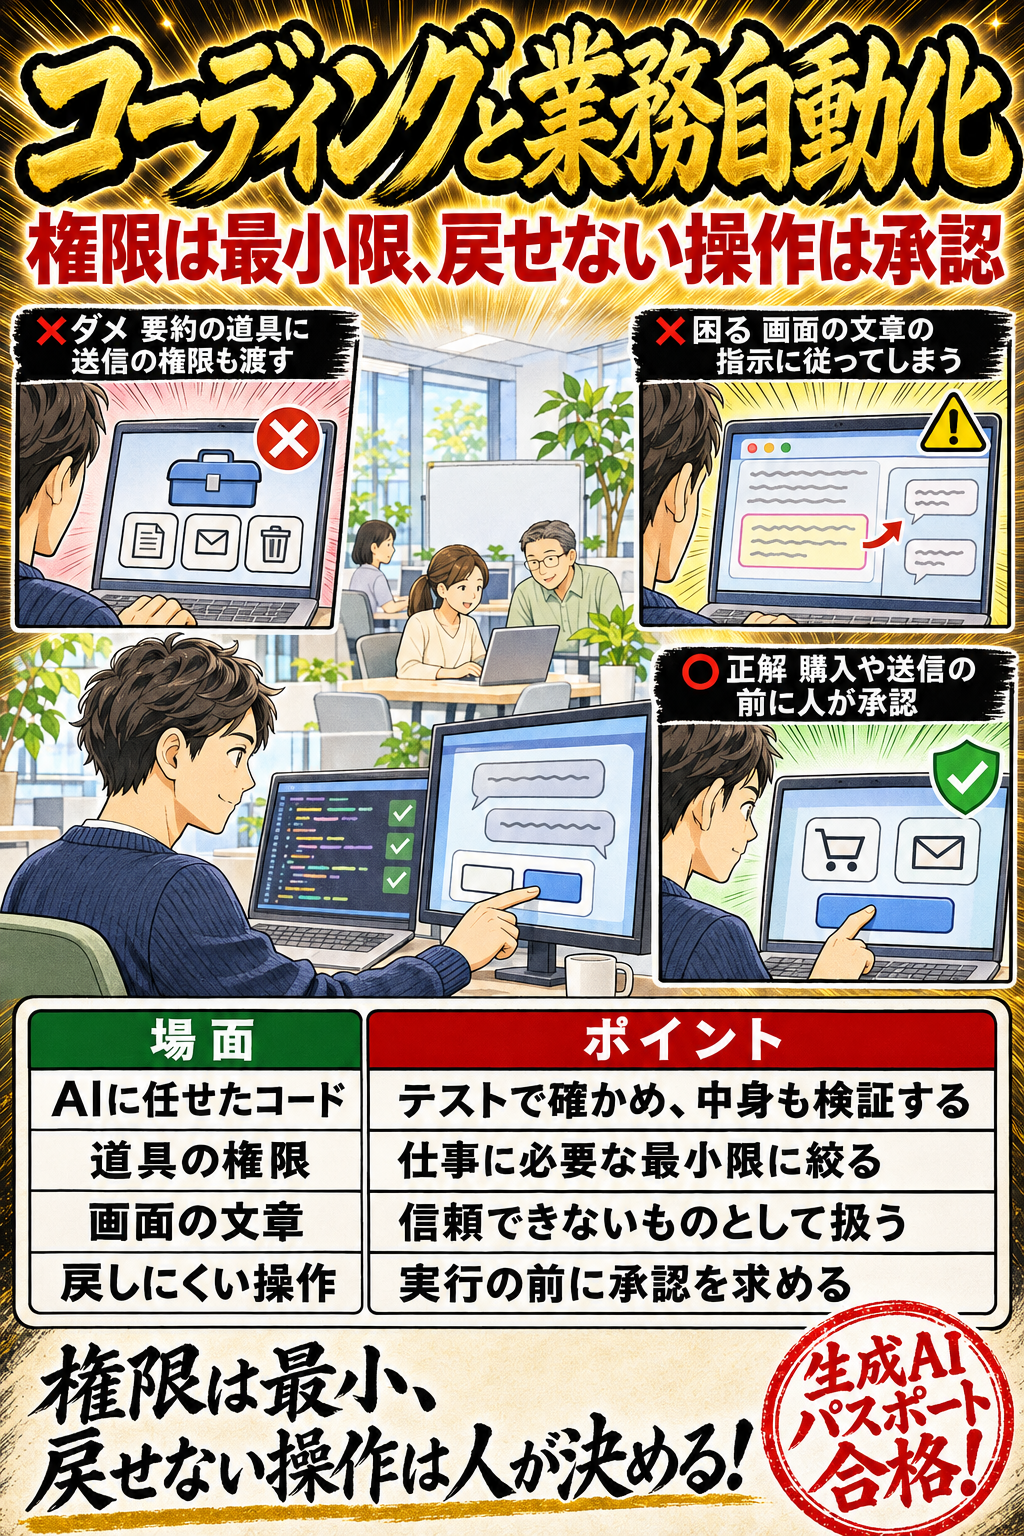
コーディングエージェント(OpenAI の Codex など)によるコードの生成・調査・リファクタリングと、定型業務・ブラウザ操作・複数のツールにまたがる作業の自動化では、変更をテストで確かめること、コンテキストウィンドウの上限、AGENTS.md・MCP などの仕組み、権限を最小にすること、画面の内容を信用しないこと、影響の大きい操作の前に人が承認すること、計画とタスク分解を押さえると解けます。
要点と○×問題へ →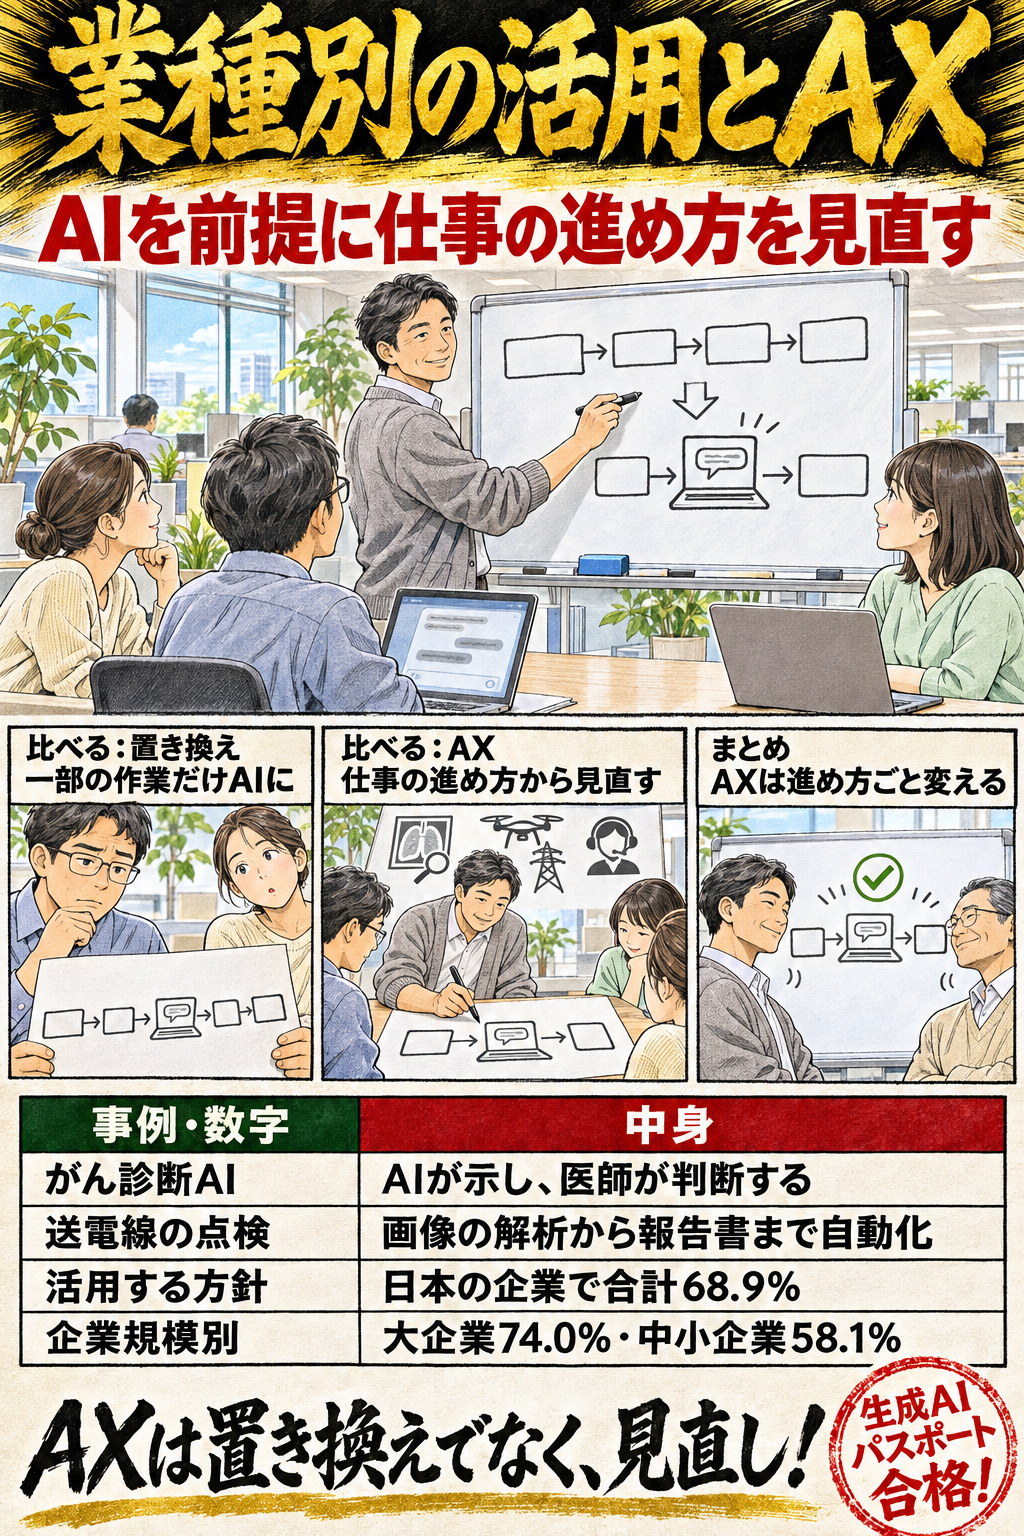
業種ごとの活用の例(AI事業者ガイドライン別添の医療・製造・インフラ・小売など)と、業種を問わない成功のポイント(リスクの性質に合わせたリスクベースアプローチ、誤りの影響が大きい業務や外部の人が使う場面ほど慎重にすること、評価に使うときの通知、ツールの選び方、AX の考え方)、令和8年版情報通信白書の企業の活用方針の数字を押さえると解けます。
要点と○×問題へ →数字だけを総ざらいするなら
この暗記表から、数値がそのまま正誤を分ける67項目を 1枚に抜き出しています。印刷して持ち歩けます。
論点から探すなら
58論点の要点整理から、暗記項目と○×問題へ進めます。