AIエージェント
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ
AIエージェントは、過去のやりとりを短期・長期の記憶として残し、それを参考にしながら動くことがあります。AIが一度に読める量(コンテキストウィンドウ)には上限があるため、何を渡すかを毎回選び整えるコンテキストエンジニアリングや、Agent Skillsのように必要な情報を必要なときだけ読み込ませる工夫がされます。システムプロンプトやガードレールで振る舞いを整え、結果を観察して次の行動を決め直す(フィードバックループ)流れを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
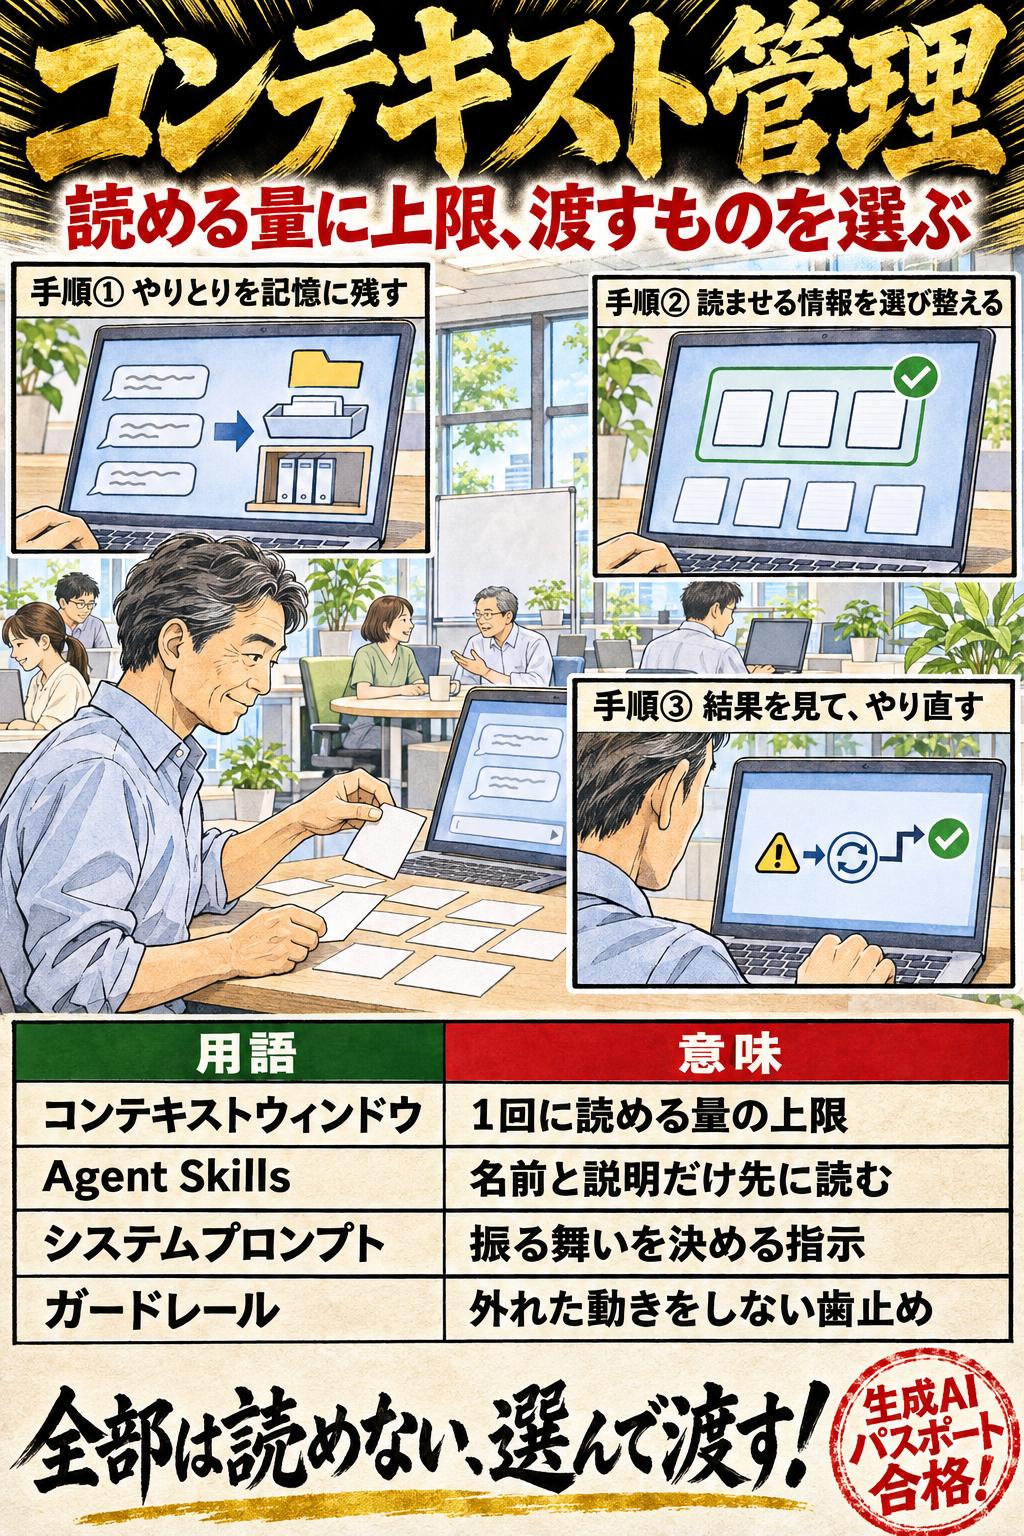
AIエージェントは、過去のやりとりを短期・長期の記憶として残し、それを参考にしながら動くことがあります。AIが一度に読める量(コンテキストウィンドウ)には上限があるため、何を渡すかを毎回選び整えるコンテキストエンジニアリングや、Agent Skillsのように必要な情報を必要なときだけ読み込ませる工夫がされます。システムプロンプトやガードレールで振る舞いを整え、結果を観察して次の行動を決め直す(フィードバックループ)流れを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 15問
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|短期・長期の記憶
AIエージェントシステムは、利用者との過去のやりとりを短期・長期の記憶として保存し、それを参考にしながら応答を作ることがある。
比較して覚える
Agent Skillsの3段階の読み込み
Agent Skillsが情報を段階的に読み込む仕組み(メタデータ・手順・資料とプログラム)を並べます。「最初から全部の手順を読み込む」「スクリプトの中身もAIが読む」といった取り違えをこの表で切り分けます。
| 事由 | 1段目:メタデータ | 2段目:手順(SKILL.mdの本文) | 3段目:資料とプログラム |
|---|---|---|---|
| 読み込む時 | いつも(起動したとき) | スキルを使うとき | 必要になったとき |
| 中身 | スキルの名前(name)と説明(description) | 作業の手順やコツなどの手引き | 追加の資料、実行するプログラム(スクリプト)、ひな形 |
| コンテキストの使い方 | スキル1つにつき約100トークン | 5,000トークン未満が目安 | 読むまでは使わない。スクリプトは中身ではなく結果だけが入る |
| たとえ | 本棚の背表紙 | 必要な本の1章 | 巻末の資料や、使うときだけ叩く電卓 |
読み込む時
- 1段目:メタデータ
- いつも(起動したとき)
- 2段目:手順(SKILL.mdの本文)
- スキルを使うとき
- 3段目:資料とプログラム
- 必要になったとき
中身
- 1段目:メタデータ
- スキルの名前(name)と説明(description)
- 2段目:手順(SKILL.mdの本文)
- 作業の手順やコツなどの手引き
- 3段目:資料とプログラム
- 追加の資料、実行するプログラム(スクリプト)、ひな形
コンテキストの使い方
- 1段目:メタデータ
- スキル1つにつき約100トークン
- 2段目:手順(SKILL.mdの本文)
- 5,000トークン未満が目安
- 3段目:資料とプログラム
- 読むまでは使わない。スクリプトは中身ではなく結果だけが入る
たとえ
- 1段目:メタデータ
- 本棚の背表紙
- 2段目:手順(SKILL.mdの本文)
- 必要な本の1章
- 3段目:資料とプログラム
- 巻末の資料や、使うときだけ叩く電卓
この論点の用語
用語集をすべて見る →01記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループの重要暗記項目
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|短期・長期の記憶
AIエージェントシステムは、利用者との過去のやりとりを短期・長期の記憶として保存し、それを参考にしながら応答を作ることがある。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|従来のLLMの記憶
従来のLLMシステムは、外の状況を続けて観察したり、やりとりを長く記録・更新したりする仕組みを標準では持たない。AIエージェントシステムは長期の記憶の仕組みを使い、過去の記録を残し更新しながら状況をつかめる。
ひっかけ注意「従来のLLMシステムは、対話履歴を長期にわたって保持・更新する仕組みを標準で備えており、この点ではAIエージェントシステムと違いがない」は誤り。 「標準で備えており」が誤り。J-AISIの評価観点ガイドの付録は、従来のLLMシステムはやりとりを長く保持・更新する仕組みを標準では持たないのに対し、AIエージェントシステムは長期的な記憶の仕組みを活用できると整理している。毎回はじめましての窓口係と、前回の相談内容を覚えている担当者の違いにあたる。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|コンテキストウィンドウ
コンテキストウィンドウは、AIが1回に考慮できる情報の量の上限で、トークン(文章を細かく分けた単位)の数で表す。上限の大きさはモデルによって違う。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|必要なときに読み込む
Agent Skillsは、情報を段階的に読み込む。最初は各スキルの名前と説明だけを読み、手順を書いた本文はスキルを使うときに、追加の資料は必要になったときに読み込むので、その時に関係する内容だけがコンテキストを占める。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|全部を最初に読まない
Agent Skillsで最初から読み込まれるのは名前と説明(メタデータ)だけで、手順の本文(SKILL.md)はスキルを使うときに初めて読み込まれる。
ひっかけ注意「Agent Skillsでは、インストールしたすべてのスキルの手順の本文が、起動したときからコンテキストウィンドウに読み込まれる」は誤り。 「起動したときから本文が読み込まれる」が誤り。Agent Skillsの資料は、起動時に入るのは各スキルのメタデータ(名前と説明)だけで、SKILL.mdの本文は使うときに初めて読み込まれると説明している。メタデータは「中身を説明する短い情報」のこと。本棚の背表紙だけを眺めておき、必要な本だけを取り出して読むのと同じ考え方である。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|スクリプトは出力だけ
Agent Skillsに同梱したスクリプト(小さなプログラム)は、実行してもプログラムの中身はコンテキストに入らず、結果だけが入るので、読む量を節約できる。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|コンテキストの中身
AIエージェントが作業中に使う情報(コンテキスト)は、利用者のプロンプトだけでなく、ファイル、それまでのやりとり、道具の実行結果、指示なども含む。
ひっかけ注意「AIエージェントが作業中に使うコンテキストは、利用者が入力したプロンプトの文面だけに限られる」は誤り。 「プロンプトの文面だけに限られる」が誤り。OpenAIのCodexの用語集は、コンテキストを作業中に使える情報とし、ファイル・それまでのメッセージ・ツールの出力・指示を例に挙げている(2026年11月時点)。何をどれだけ渡すかを設計するのがコンテキストエンジニアリングの考え方で、新人に仕事を頼むとき、依頼文だけでなく過去の資料や経緯も一緒に渡すのに近い。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|コンテキストエンジニアリング
Anthropicは、コンテキストエンジニアリングを、プロンプトの書き方を工夫するプロンプトエンジニアリングが自然に発展したものと位置づけ、システムプロンプト・ツール・MCP・外部データ・会話の履歴など、AIが推論のたびに読む情報全体から、限られたコンテキストウィンドウに入れるものを選び整えることとしている。
ひっかけ注意「Anthropicは、コンテキストエンジニアリングを、プロンプトエンジニアリングと同じく、プロンプトの文面の書き方だけを工夫する取り組みと位置づけている」は誤り。 「プロンプトの文面の書き方だけ」が誤り。Anthropicは、プロンプトに加えてツール・MCP・外部データ・会話の履歴まで含め、毎回何を渡すかを選び直すことをコンテキストエンジニアリングとしている。コンテキストに入る量が増えるほど、中の情報を正確に思い出しにくくなるため、目的に効く情報をなるべく少なく選ぶのが基本である。人に仕事を頼むとき、依頼文の言い回しだけでなく、渡す資料の束を選び抜くことに近い。
覚える数字と、狙われる引っかけ
- ひっかけ「従来のLLMシステムは、対話履歴を長期にわたって保持・更新する仕組みを標準で備えており、この点ではAIエージェントシステムと違いがない」は誤り。「標準で備えており」が誤り。J-AISIの評価観点ガイドの付録は、従来のLLMシステムはやりとりを長く保持・更新する仕組みを標準では持たないのに対し、AIエージェントシステムは長期的な記憶の仕組みを活用できると整理している。毎回はじめましての窓口係と、前回の相談内容を覚えている担当者の違いにあたる。
- ひっかけ「Agent Skillsでは、インストールしたすべてのスキルの手順の本文が、起動したときからコンテキストウィンドウに読み込まれる」は誤り。「起動したときから本文が読み込まれる」が誤り。Agent Skillsの資料は、起動時に入るのは各スキルのメタデータ(名前と説明)だけで、SKILL.mdの本文は使うときに初めて読み込まれると説明している。メタデータは「中身を説明する短い情報」のこと。本棚の背表紙だけを眺めておき、必要な本だけを取り出して読むのと同じ考え方である。
- ひっかけ「AIエージェントが作業中に使うコンテキストは、利用者が入力したプロンプトの文面だけに限られる」は誤り。「プロンプトの文面だけに限られる」が誤り。OpenAIのCodexの用語集は、コンテキストを作業中に使える情報とし、ファイル・それまでのメッセージ・ツールの出力・指示を例に挙げている(2026年11月時点)。何をどれだけ渡すかを設計するのがコンテキストエンジニアリングの考え方で、新人に仕事を頼むとき、依頼文だけでなく過去の資料や経緯も一緒に渡すのに近い。
- ひっかけ「Anthropicは、コンテキストエンジニアリングを、プロンプトエンジニアリングと同じく、プロンプトの文面の書き方だけを工夫する取り組みと位置づけている」は誤り。「プロンプトの文面の書き方だけ」が誤り。Anthropicは、プロンプトに加えてツール・MCP・外部データ・会話の履歴まで含め、毎回何を渡すかを選び直すことをコンテキストエンジニアリングとしている。コンテキストに入る量が増えるほど、中の情報を正確に思い出しにくくなるため、目的に効く情報をなるべく少なく選ぶのが基本である。人に仕事を頼むとき、依頼文の言い回しだけでなく、渡す資料の束を選び抜くことに近い。
- ひっかけ「2026年11月時点のOpenAIのCodexの「Memories」は、1回の会話の中だけで使われ、セッションをまたいで再利用されることはない」は誤り。「セッションをまたいで再利用されることはない」が誤り。Codexの用語集は、Memoriesを「セッションをまたいで再利用できる、手元に保存されたコンテキスト」と定義している。昨日の作業で分かった「この会社の書類はこの書式」というメモを、今日の作業でも使えるようにしておく仕組みである。
- ひっかけ「OpenAIのAPIでは、利用者が書くuserメッセージが、開発者が書くdeveloperメッセージより優先して扱われる」は誤り。優先の順番が逆である。OpenAIのプロンプトエンジニアリングのガイドは、開発者が与えるdeveloperメッセージが利用者のuserメッセージより優先されると説明している(2026年11月時点)。お店のルールとお客さんの要望が食い違ったら、店員はお店のルールに従うのと同じで、利用者の一言で決まりが覆らないようにしている。
- ひっかけ「AI事業者ガイドラインの別添が挙げるModeration Railは、特定のユースケースや利用者の意図に関係しない話題に触れないようにする手法である」は誤り。Moderation Railの説明が誤り。別添のコラムでは、関係ない話題に触れないようにするのはTopical Railで、Moderation Railは倫理的に不適切な言葉を答えに入れないようにする手法とされている。銀行の案内AIが料理の相談には乗らないのがTopical Rail、乱暴な言葉を使わないのがModeration Railのイメージである。
- ひっかけ「AIエージェントシステムが多段階の推論を繰り返す場合、途中で入った誤りは、その後の段階で自然に打ち消される」は誤り。「自然に打ち消される」が誤り。J-AISIの評価観点ガイドは、多段階の推論の途中で誤りが混じると、誤りをもとにした思考を繰り返して誤りを増幅させ、誤情報を出すおそれがあるとしている。最初の計算で桁を1つ間違えると、その数字を使った後の計算が全部ずれていくのと同じで、途中で確かめる仕組みが要る。
02試験で正誤を分けるチェック順
- 1AIエージェントシステムは、利用者との過去のやりとりを短期・長期の記憶として保存し、それを参考にしながら応答を作ることがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2従来のLLMシステムは、外の状況を続けて観察したり、やりとりを長く記録・更新したりする仕組みを標準では持たない。AIエージェントシステムは長期の記憶の仕組みを使い、過去の記録を残し更新しながら状況をつかめる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3コンテキストウィンドウは、AIが1回に考慮できる情報の量の上限で、トークン(文章を細かく分けた単位)の数で表す。上限の大きさはモデルによって違う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4Agent Skillsは、情報を段階的に読み込む。最初は各スキルの名前と説明だけを読み、手順を書いた本文はスキルを使うときに、追加の資料は必要になったときに読み込むので、その時に関係する内容だけがコンテキストを占める。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5Agent Skillsで最初から読み込まれるのは名前と説明(メタデータ)だけで、手順の本文(SKILL.md)はスキルを使うときに初めて読み込まれる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6Agent Skillsに同梱したスクリプト(小さなプログラム)は、実行してもプログラムの中身はコンテキストに入らず、結果だけが入るので、読む量を節約できる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7AIエージェントが作業中に使う情報(コンテキスト)は、利用者のプロンプトだけでなく、ファイル、それまでのやりとり、道具の実行結果、指示なども含む。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8Anthropicは、コンテキストエンジニアリングを、プロンプトの書き方を工夫するプロンプトエンジニアリングが自然に発展したものと位置づけ、システムプロンプト・ツール・MCP・外部データ・会話の履歴など、AIが推論のたびに読む情報全体から、限られたコンテキストウィンドウに入れるものを選び整えることとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 92026年11月時点のCodexの「Memories」は、セッション(1回の作業の区切り)をまたいで再利用できる、手元に保存された情報で、長期の記憶にあたる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10システムプロンプトは、望ましい答え方や禁止事項を指定してAIの振る舞いを決める指示で、ふつうはAIの開発者や提供者が設定し、利用者には見せない。利用者の入力とつなげてAIに渡される。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11OpenAIのAPIでは、開発者が書く指示(developerメッセージ)が、利用者が書く指示(userメッセージ)より優先される。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12AI事業者ガイドラインの別添は、ガードレール(AIが外れた動きをしないための歯止め)の例として、関係ない話題に触れないTopical Rail、不適切な言葉を出さないModeration Rail、うそや誤りを避けるFact Checking and Hallucination Rail、攻撃に強くするJailbreaking Railを挙げている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13AIエージェントシステムは、外のシステムを操作したあと、エラーや返ってきた内容などの結果を観察し、やり直したり別の方法を選んだりする。結果や状況の変化に合わせて行動を調整しながら目標に近づく。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14AIエージェントシステムが何段階も推論を重ねる途中で誤りが入ると、その誤りをもとに考え続けて誤りが大きくなり、誤った情報を出すおそれがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 15computer useでは、操作の前に画面の写し(スクリーンショット)で画面を確かめ、少しの操作のあとに画面を確認する。観察した結果を次の操作に生かす。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループの○×一問一答
1/8問解答 0・正解 0
AIエージェント
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|短期・長期の記憶
AIエージェントシステムは、利用者との過去の対話履歴を短期的・長期的な記憶として保存し、それを参照しながら応答を生成することがある。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループの○×一問一答15問|問題と解説
この論点で収録している15問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|短期・長期の記憶AIエージェントシステムは、利用者との過去の対話履歴を短期的・長期的な記憶として保存し、それを参照しながら応答を生成することがある。
答え:○(正しい)
解説
正しい。J-AISIの評価観点ガイドの説明のとおり。短期の記憶は今の会話の中のメモ、長期の記憶は日をまたいで残る記録にあたる。担当者が、今日の打ち合わせのメモ(短期)と、取引先ごとの過去の対応記録(長期)の両方を見ながら対応するのと同じである。記憶に誤った情報が入ると判断を誤り続ける点にも注意が要る。 要点:AIエージェントシステムは、利用者との過去のやりとりを短期・長期の記憶として保存し、それを参考にしながら応答を作ることがある。
問2
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|従来のLLMの記憶従来のLLMシステムは、対話履歴を長期にわたって保持・更新する仕組みを標準で備えており、この点ではAIエージェントシステムと違いがない。
答え:×(誤り)
解説
誤り。「標準で備えており」が誤り。J-AISIの評価観点ガイドの付録は、従来のLLMシステムはやりとりを長く保持・更新する仕組みを標準では持たないのに対し、AIエージェントシステムは長期的な記憶の仕組みを活用できると整理している。毎回はじめましての窓口係と、前回の相談内容を覚えている担当者の違いにあたる。 要点:従来のLLMシステムは、外の状況を続けて観察したり、やりとりを長く記録・更新したりする仕組みを標準では持たない。AIエージェントシステムは長期の記憶の仕組みを使い、過去の記録を残し更新しながら状況をつかめる。
問3
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|コンテキストウィンドウコンテキストウィンドウは、モデルが1回の生成で考慮できるデータの量の上限のことで、トークンの数で表される。
答え:○(正しい)
解説
正しい。OpenAIのプロンプトエンジニアリングのガイドのとおり。トークンは、AIが文章を読むときの小さな単位で、単語や文字のかけらにあたる。机の広さに例えると、一度に広げられる資料の量には限りがあり、あふれた資料は見られない。上限の大きさはモデルごとに違う。 要点:コンテキストウィンドウは、AIが1回に考慮できる情報の量の上限で、トークン(文章を細かく分けた単位)の数で表す。上限の大きさはモデルによって違う。
問4
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|必要なときに読み込むAgent Skillsでは、起動時に読み込むのは各スキルの名前と説明だけで、手順を書いた本文や追加の資料は、必要になったときに読み込まれる。
答え:○(正しい)
解説
正しい。AnthropicのAgent Skillsの資料のとおり(2026年11月時点)。Agent Skillsは、作業の手順書や道具をフォルダにまとめてAIに渡す仕組み。分厚いマニュアルを全部机に広げず、まず目次だけを見て、必要な章だけを開くやり方にあたる。多くのスキルを入れても、机(コンテキスト)があふれにくい。 要点:Agent Skillsは、情報を段階的に読み込む。最初は各スキルの名前と説明だけを読み、手順を書いた本文はスキルを使うときに、追加の資料は必要になったときに読み込むので、その時に関係する内容だけがコンテキストを占める。
問5
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|全部を最初に読まないAgent Skillsでは、インストールしたすべてのスキルの手順の本文が、起動したときからコンテキストウィンドウに読み込まれる。
答え:×(誤り)
解説
誤り。「起動したときから本文が読み込まれる」が誤り。Agent Skillsの資料は、起動時に入るのは各スキルのメタデータ(名前と説明)だけで、SKILL.mdの本文は使うときに初めて読み込まれると説明している。メタデータは「中身を説明する短い情報」のこと。本棚の背表紙だけを眺めておき、必要な本だけを取り出して読むのと同じ考え方である。 要点:Agent Skillsで最初から読み込まれるのは名前と説明(メタデータ)だけで、手順の本文(SKILL.md)はスキルを使うときに初めて読み込まれる。
問6
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|スクリプトは出力だけAgent Skillsに同梱したスクリプトを実行すると、コードそのものはコンテキストに入らず、実行の出力だけがコンテキストに入る。
答え:○(正しい)
解説
正しい。Agent Skillsの資料のとおり。スクリプトのコードは読み込まず、「検証に通った」などの結果だけを受け取る。電卓を使うとき、電卓の内部の回路を理解しなくても、表示された答えだけを見れば足りるのと同じで、限られた机の広さを結果のために使える。 要点:Agent Skillsに同梱したスクリプト(小さなプログラム)は、実行してもプログラムの中身はコンテキストに入らず、結果だけが入るので、読む量を節約できる。
問7
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|コンテキストの中身AIエージェントが作業中に使うコンテキストは、利用者が入力したプロンプトの文面だけに限られる。
答え:×(誤り)
解説
誤り。「プロンプトの文面だけに限られる」が誤り。OpenAIのCodexの用語集は、コンテキストを作業中に使える情報とし、ファイル・それまでのメッセージ・ツールの出力・指示を例に挙げている(2026年11月時点)。何をどれだけ渡すかを設計するのがコンテキストエンジニアリングの考え方で、新人に仕事を頼むとき、依頼文だけでなく過去の資料や経緯も一緒に渡すのに近い。 要点:AIエージェントが作業中に使う情報(コンテキスト)は、利用者のプロンプトだけでなく、ファイル、それまでのやりとり、道具の実行結果、指示なども含む。
問8
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|コンテキストエンジニアリングAnthropicは、コンテキストエンジニアリングを、プロンプトエンジニアリングと同じく、プロンプトの文面の書き方だけを工夫する取り組みと位置づけている。
答え:×(誤り)
解説
誤り。「プロンプトの文面の書き方だけ」が誤り。Anthropicは、プロンプトに加えてツール・MCP・外部データ・会話の履歴まで含め、毎回何を渡すかを選び直すことをコンテキストエンジニアリングとしている。コンテキストに入る量が増えるほど、中の情報を正確に思い出しにくくなるため、目的に効く情報をなるべく少なく選ぶのが基本である。人に仕事を頼むとき、依頼文の言い回しだけでなく、渡す資料の束を選び抜くことに近い。 要点:Anthropicは、コンテキストエンジニアリングを、プロンプトの書き方を工夫するプロンプトエンジニアリングが自然に発展したものと位置づけ、システムプロンプト・ツール・MCP・外部データ・会話の履歴など、AIが推論のたびに読む情報全体から、限られたコンテキストウィンドウに入れるものを選び整えることとしている。
問9
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|セッションをまたぐ記憶2026年11月時点のOpenAIのCodexの「Memories」は、1回の会話の中だけで使われ、セッションをまたいで再利用されることはない。
答え:×(誤り)
解説
誤り。「セッションをまたいで再利用されることはない」が誤り。Codexの用語集は、Memoriesを「セッションをまたいで再利用できる、手元に保存されたコンテキスト」と定義している。昨日の作業で分かった「この会社の書類はこの書式」というメモを、今日の作業でも使えるようにしておく仕組みである。 要点:2026年11月時点のCodexの「Memories」は、セッション(1回の作業の区切り)をまたいで再利用できる、手元に保存された情報で、長期の記憶にあたる。
問10
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|システムプロンプトシステムプロンプトは、望ましい出力の形や禁止事項などを指定してLLMの振る舞いを制御するもので、通常はAI開発者やAI提供者が設定し、エンドユーザーには公開しない。
答え:○(正しい)
解説
正しい。J-AISIのレッドチーミング手法ガイドの説明のとおり。システムプロンプトは、店員向けの接客マニュアルのようなもの。お客さん(利用者)には見えないが、「値引きの約束はしない」「丁寧語で話す」といった決まりが、すべての会話の前提として働いている。 要点:システムプロンプトは、望ましい答え方や禁止事項を指定してAIの振る舞いを決める指示で、ふつうはAIの開発者や提供者が設定し、利用者には見せない。利用者の入力とつなげてAIに渡される。
問11
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|開発者の指示の優先OpenAIのAPIでは、利用者が書くuserメッセージが、開発者が書くdeveloperメッセージより優先して扱われる。
答え:×(誤り)
解説
誤り。優先の順番が逆である。OpenAIのプロンプトエンジニアリングのガイドは、開発者が与えるdeveloperメッセージが利用者のuserメッセージより優先されると説明している(2026年11月時点)。お店のルールとお客さんの要望が食い違ったら、店員はお店のルールに従うのと同じで、利用者の一言で決まりが覆らないようにしている。 要点:OpenAIのAPIでは、開発者が書く指示(developerメッセージ)が、利用者が書く指示(userメッセージ)より優先される。
問12
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|ガードレールの種類AI事業者ガイドラインの別添が挙げるModeration Railは、特定のユースケースや利用者の意図に関係しない話題に触れないようにする手法である。
答え:×(誤り)
解説
誤り。Moderation Railの説明が誤り。別添のコラムでは、関係ない話題に触れないようにするのはTopical Railで、Moderation Railは倫理的に不適切な言葉を答えに入れないようにする手法とされている。銀行の案内AIが料理の相談には乗らないのがTopical Rail、乱暴な言葉を使わないのがModeration Railのイメージである。 要点:AI事業者ガイドラインの別添は、ガードレール(AIが外れた動きをしないための歯止め)の例として、関係ない話題に触れないTopical Rail、不適切な言葉を出さないModeration Rail、うそや誤りを避けるFact Checking and Hallucination Rail、攻撃に強くするJailbreaking Railを挙げている。
問13
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|観察して決め直すAIエージェントシステムは、操作を実行したあとにエラーや応答の内容を観測し、その結果に応じて再試行したり別の手段を選んだりして行動を調整する。
答え:○(正しい)
解説
正しい。J-AISIの評価観点ガイドの付録のとおり。「考える→行動する→結果を観察する→考え直す」の繰り返しを、推論と行動のフィードバックループという。予約サイトで満席と出たら別の日を探し、それも駄目なら別の店を探す、と結果を見て次の手を決める人の動き方と同じである。 要点:AIエージェントシステムは、外のシステムを操作したあと、エラーや返ってきた内容などの結果を観察し、やり直したり別の方法を選んだりする。結果や状況の変化に合わせて行動を調整しながら目標に近づく。
問14
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|誤りの増幅AIエージェントシステムが多段階の推論を繰り返す場合、途中で入った誤りは、その後の段階で自然に打ち消される。
答え:×(誤り)
解説
誤り。「自然に打ち消される」が誤り。J-AISIの評価観点ガイドは、多段階の推論の途中で誤りが混じると、誤りをもとにした思考を繰り返して誤りを増幅させ、誤情報を出すおそれがあるとしている。最初の計算で桁を1つ間違えると、その数字を使った後の計算が全部ずれていくのと同じで、途中で確かめる仕組みが要る。 要点:AIエージェントシステムが何段階も推論を重ねる途中で誤りが入ると、その誤りをもとに考え続けて誤りが大きくなり、誤った情報を出すおそれがある。
問15
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループ|画面を見てから動くOpenAIのcomputer useのガイドは、操作の前にスクリーンショットで画面を確かめ、少しまとまった操作のあとに画面を確認するよう示している。
答え:○(正しい)
解説
正しい。computer useのガイドの例のとおり(2026年11月時点)。行動の結果を観察して次の行動を決めるフィードバックループの身近な例である。慣れないサイトで手続きをするとき、ボタンを押すたびに画面が思ったとおり変わったかを確かめてから次に進むと、押し間違いに早く気づけるのと同じである。 要点:computer useでは、操作の前に画面の写し(スクリーンショット)で画面を確かめ、少しの操作のあとに画面を確認する。観察した結果を次の操作に生かす。
記憶とコンテキスト管理・コンテキストエンジニアリング・フィードバックループの問題を続けて解く
この論点に対応する15問を絞り込んで出題します。