AIエージェント
RAGとは(必要とされる理由と仕組み)
RAG(検索拡張生成)は、質問に答える前に外部のデータベースから関係する情報を探し、それを材料にLLMに答えを作らせる手法です。モデルを作り直す(ファインチューニング)のではなく「調べてから答える」点、ハルシネーションの抑制や根拠を示しやすくなる理由、文書を細かく分けて数値(ベクトル)にして検索する仕組みを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
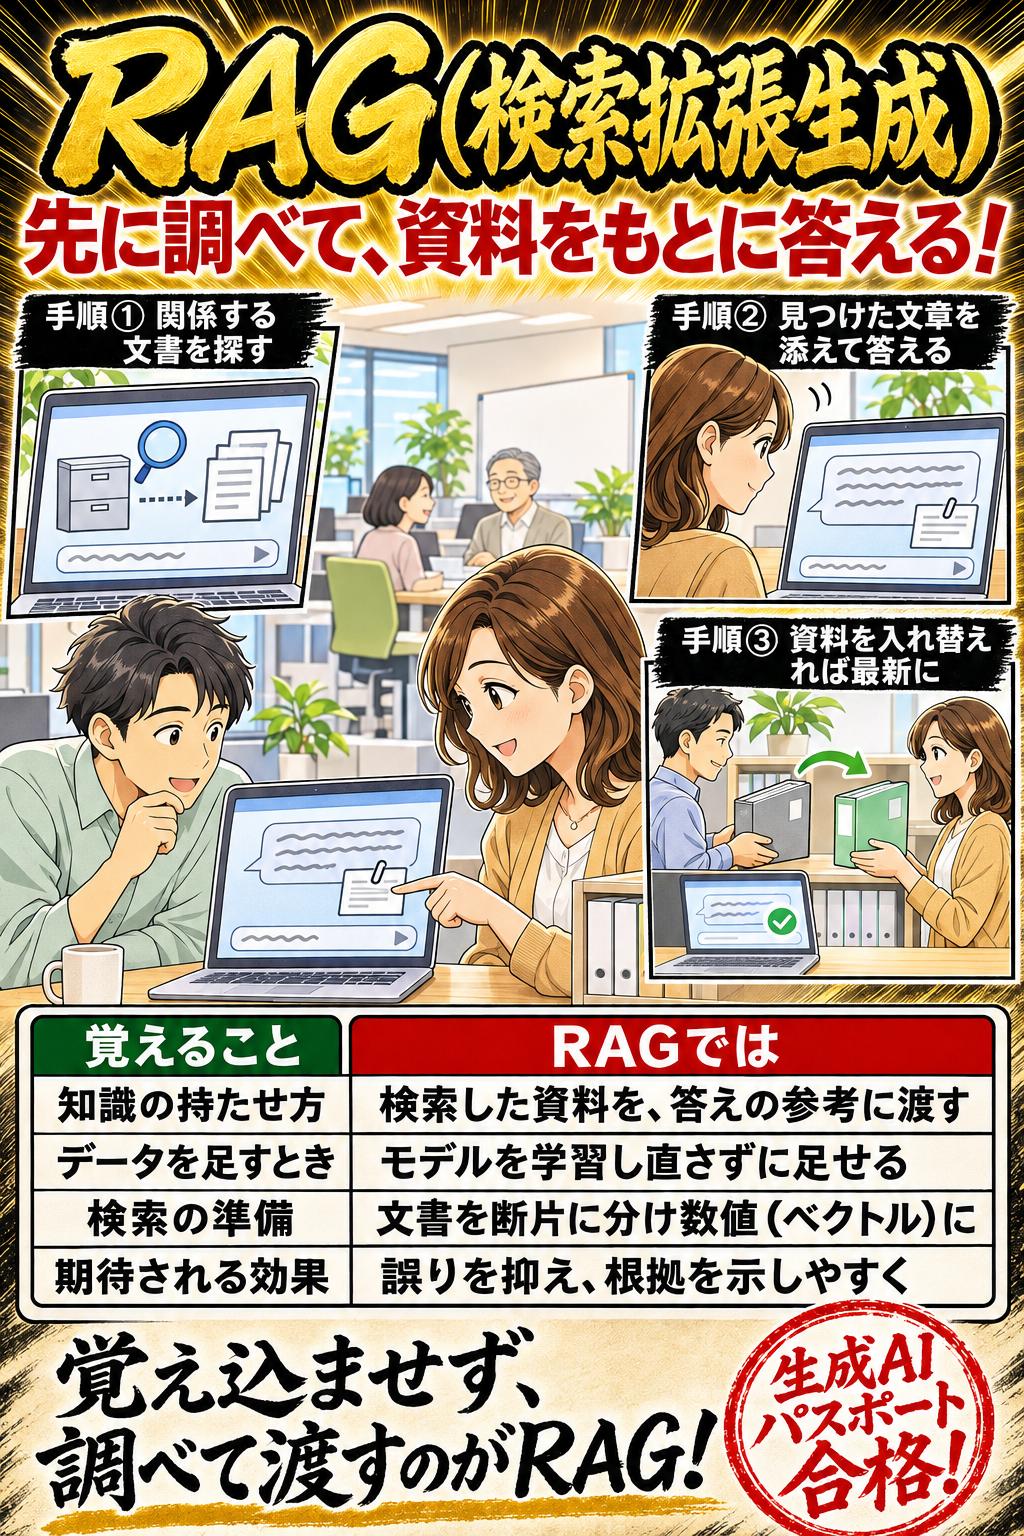
RAG(検索拡張生成)は、質問に答える前に外部のデータベースから関係する情報を探し、それを材料にLLMに答えを作らせる手法です。モデルを作り直す(ファインチューニング)のではなく「調べてから答える」点、ハルシネーションの抑制や根拠を示しやすくなる理由、文書を細かく分けて数値(ベクトル)にして検索する仕組みを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 13問
RAGとは(必要とされる理由と仕組み)|RAGの定義
RAG(検索拡張生成)は、外部のデータベースから取り出した知識をもとにLLMに答えを作らせることで、知識に沿った答えにしたり、ファインチューニングをしなくても知識を広げたりする手法である。
比較して覚える
RAGとファインチューニング
AIに新しい知識を使わせる2つの方法、検索して資料として渡すRAGと、追加で学習させるファインチューニングを並べます。「RAGはモデルを学習し直す」「データを足すたびに再学習が要る」といった取り違えをこの表で切り分けます。
| 事由 | RAG(検索拡張生成) | ファインチューニング |
|---|---|---|
| 知識の持たせ方 | 外のデータベースから検索した知識を、答えを作るときの資料として渡す | 作り終えたモデルに追加で学習させ、中身(パラメータ)を変える |
| 知識を足す・新しくするとき | 参照するデータを足したり入れ替えたりすればよく、モデルの学習し直しは要らない | モデルの学習し直しが要る |
| 期待されること | ハルシネーションの抑制、参照元を示せることによる根拠の透明性、費用の低減 | 特定の用途に合わせること(専門知識の補い、人の意図に沿った答え方など) |
| 気を付けること | 検索対象の文書の正確さと、見られる範囲(参照権限)の管理。答えが似通いやすく、独創性が要る業務に向かない場合がある | 学習に使うデータが細工されると、弱点や偏りが入り込むおそれがある |
| プロンプトインジェクション | 完全には防げない | 完全には防げない |
| たとえ | 参考書を試験に持ち込める | 試験の前に勉強して覚え込む |
知識の持たせ方
- RAG(検索拡張生成)
- 外のデータベースから検索した知識を、答えを作るときの資料として渡す
- ファインチューニング
- 作り終えたモデルに追加で学習させ、中身(パラメータ)を変える
知識を足す・新しくするとき
- RAG(検索拡張生成)
- 参照するデータを足したり入れ替えたりすればよく、モデルの学習し直しは要らない
- ファインチューニング
- モデルの学習し直しが要る
期待されること
- RAG(検索拡張生成)
- ハルシネーションの抑制、参照元を示せることによる根拠の透明性、費用の低減
- ファインチューニング
- 特定の用途に合わせること(専門知識の補い、人の意図に沿った答え方など)
気を付けること
- RAG(検索拡張生成)
- 検索対象の文書の正確さと、見られる範囲(参照権限)の管理。答えが似通いやすく、独創性が要る業務に向かない場合がある
- ファインチューニング
- 学習に使うデータが細工されると、弱点や偏りが入り込むおそれがある
プロンプトインジェクション
- RAG(検索拡張生成)
- 完全には防げない
- ファインチューニング
- 完全には防げない
たとえ
- RAG(検索拡張生成)
- 参考書を試験に持ち込める
- ファインチューニング
- 試験の前に勉強して覚え込む
この論点の用語
用語集をすべて見る →01RAGとは(必要とされる理由と仕組み)の重要暗記項目
RAGとは(必要とされる理由と仕組み)|RAGの定義
RAG(検索拡張生成)は、外部のデータベースから取り出した知識をもとにLLMに答えを作らせることで、知識に沿った答えにしたり、ファインチューニングをしなくても知識を広げたりする手法である。
RAGとは(必要とされる理由と仕組み)|FTとの取り違え
RAGは、検索した知識をモデルに覚え込ませるのではなく、答えを作るときの参考資料として渡す。知識をモデルの中身(パラメータ)に取り込むのはファインチューニングで、RAGで知識を足すのにファインチューニングは必須ではない(両方を組み合わせることもできる)。
ひっかけ注意「RAGは、外部のデータベースから取得した知識をファインチューニングでモデルのパラメータに学習させてから、回答を生成させる手法である」は誤り。 「ファインチューニングでパラメータに学習させてから」が誤り。RAGは、検索した文書を答えを作るときの追加の資料として渡す手法で、知識を足すのにモデルの学習し直しは必須ではない(ファインチューニングと組み合わせることはできる)。パラメータとは、モデルが学習で身につけた知識を蓄えている中身のこと。例えるなら、RAGは「試験に参考書を持ち込める」状態、ファインチューニングは「試験の前に勉強して覚え込む」状態である。
RAGとは(必要とされる理由と仕組み)|期待される効果
AI事業者ガイドラインは、RAGの活用などにより、ハルシネーション(もっともらしい誤り)の抑制や、出力の過程・根拠の透明性の向上が期待されているとしている。
RAGとは(必要とされる理由と仕組み)|再学習なしで追加
RAGは、ファインチューニングと違い、モデルを学習し直さずに参照するデータを足せるため、費用を抑えられると期待されている。
ひっかけ注意「RAGで参照するデータソースを追加するには、そのたびにモデルの再トレーニングが必要になるため、ファインチューニングより費用がかかりやすい」は誤り。 「そのたびに再トレーニングが必要」が誤り。AI事業者ガイドラインの別添は、RAGはモデルの再トレーニングなしで参照するデータソースを追加でき、コストの低減が期待されるとしている。例えば、社内規程が改定されたら、新しい規程の文書を検索の対象に入れ替えるだけで済み、AIそのものを作り直す必要はない。
RAGとは(必要とされる理由と仕組み)|最新性
RAGを提案した論文は、検索に使う外部の記憶(文書の索引)を入れ替えることで、世の中の変化に合わせてモデルの知識を新しくできることを示した。
RAGとは(必要とされる理由と仕組み)|2つの記憶
RAGは、生成モデルが学習で蓄えた知識(パラメトリックメモリ)と、検索で引き出す外部の文書の索引(ノンパラメトリックメモリ)を組み合わせる。
RAGとは(必要とされる理由と仕組み)|社内の独自データ
RAG(関連する情報をプロンプトに足す手法)は、モデルが学習していない独自のデータを使わせたり、答えを特定の資料の範囲に絞ったりする目的で使われる。
ひっかけ注意「RAGは、モデルが学習していない社内の独自データを回答に使わせる目的には使えない」は誤り。 「使えない」が誤り。OpenAIのプロンプトエンジニアリングのガイドは、関連する情報をプロンプト(AIへの指示文)に加える理由として、独自のデータや学習データにないデータを使わせることを挙げ、この手法をRAGと呼んでいる。例えば、自社の商品マニュアルを検索させれば、世間に公開されていない自社製品の質問にも答えられる。
RAGとは(必要とされる理由と仕組み)|検索してから生成
RAGでは、まず質問に関係する文書を検索し、見つけた文章をプロンプトに加えてから、LLMが答えを作る。
ひっかけ注意「RAGでは、LLMがまず回答を生成し、そのあとで回答に合う文書を検索して、回答の末尾に貼り付ける」は誤り。 検索と生成の順番が逆である。RAGの論文は、入力をもとに文書を検索し、それを追加の材料にして答えを作ると説明している。OpenAIのガイドも、検索して返ってきた文章をプロンプトに含める方法を挙げている。料理で言えば、先に冷蔵庫の中身(資料)を確かめてから献立(答え)を決めるのであって、作ったあとで材料を探すのではない。
覚える数字と、狙われる引っかけ
- ひっかけ「RAGは、外部のデータベースから取得した知識をファインチューニングでモデルのパラメータに学習させてから、回答を生成させる手法である」は誤り。「ファインチューニングでパラメータに学習させてから」が誤り。RAGは、検索した文書を答えを作るときの追加の資料として渡す手法で、知識を足すのにモデルの学習し直しは必須ではない(ファインチューニングと組み合わせることはできる)。パラメータとは、モデルが学習で身につけた知識を蓄えている中身のこと。例えるなら、RAGは「試験に参考書を持ち込める」状態、ファインチューニングは「試験の前に勉強して覚え込む」状態である。
- ひっかけ「RAGで参照するデータソースを追加するには、そのたびにモデルの再トレーニングが必要になるため、ファインチューニングより費用がかかりやすい」は誤り。「そのたびに再トレーニングが必要」が誤り。AI事業者ガイドラインの別添は、RAGはモデルの再トレーニングなしで参照するデータソースを追加でき、コストの低減が期待されるとしている。例えば、社内規程が改定されたら、新しい規程の文書を検索の対象に入れ替えるだけで済み、AIそのものを作り直す必要はない。
- ひっかけ「RAGは、モデルが学習していない社内の独自データを回答に使わせる目的には使えない」は誤り。「使えない」が誤り。OpenAIのプロンプトエンジニアリングのガイドは、関連する情報をプロンプト(AIへの指示文)に加える理由として、独自のデータや学習データにないデータを使わせることを挙げ、この手法をRAGと呼んでいる。例えば、自社の商品マニュアルを検索させれば、世間に公開されていない自社製品の質問にも答えられる。
- ひっかけ「RAGでは、LLMがまず回答を生成し、そのあとで回答に合う文書を検索して、回答の末尾に貼り付ける」は誤り。検索と生成の順番が逆である。RAGの論文は、入力をもとに文書を検索し、それを追加の材料にして答えを作ると説明している。OpenAIのガイドも、検索して返ってきた文章をプロンプトに含める方法を挙げている。料理で言えば、先に冷蔵庫の中身(資料)を確かめてから献立(答え)を決めるのであって、作ったあとで材料を探すのではない。
- ひっかけ「RAGで機密情報を参照させる場合でも、利用者や役割によって参照権限を分ける必要はなく、全員が同じ範囲を検索できるようにしてよい」は誤り。「分ける必要はない」が誤り。デジタル庁のガイドラインは、RAG用のデータへの参照権限を利用者や役割に応じて適切に設定するとしている。OWASPも、データにタグを付けて分類し見られる範囲を管理することを挙げる。人事部しか見られない給与表をRAGに入れたのに、全社員のAIが検索できたら、AI経由で給与が漏れてしまう。
- ひっかけ「RAGでは、検索対象の文書が事実にもとづくかを確かめなくても、回答の正確性は保たれる」は誤り。「確かめなくても正確性は保たれる」が誤り。J-AISIの評価観点ガイドは、RAGで検索の対象になる文書が事実にもとづくデータかに留意が必要としている。デジタル庁のガイドラインにも同じ確認の項目がある。古い料金表が検索の対象に残っていれば、AIは自信を持って古い料金を案内してしまう。正確さは資料の質に左右される。
- ひっかけ「AI事業者ガイドラインは、RAGを活用すると回答の多様性が高まるため、独創性が求められる業務にこそ向いているとしている」は誤り。ガイドラインの説明と逆である。ガイドラインは、RAGを使うと回答の収束が加速する可能性が高く、多様性・独創性が必要な業務では適切でない場合もあるとしている。過去の企画書ばかりを見せて新商品のアイデアを出させると、過去の企画に似た案ばかりになりがちなのと同じである。
02試験で正誤を分けるチェック順
- 1RAG(検索拡張生成)は、外部のデータベースから取り出した知識をもとにLLMに答えを作らせることで、知識に沿った答えにしたり、ファインチューニングをしなくても知識を広げたりする手法である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2RAGは、検索した知識をモデルに覚え込ませるのではなく、答えを作るときの参考資料として渡す。知識をモデルの中身(パラメータ)に取り込むのはファインチューニングで、RAGで知識を足すのにファインチューニングは必須ではない(両方を組み合わせることもできる)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3AI事業者ガイドラインは、RAGの活用などにより、ハルシネーション(もっともらしい誤り)の抑制や、出力の過程・根拠の透明性の向上が期待されているとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4RAGは、ファインチューニングと違い、モデルを学習し直さずに参照するデータを足せるため、費用を抑えられると期待されている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5RAGを提案した論文は、検索に使う外部の記憶(文書の索引)を入れ替えることで、世の中の変化に合わせてモデルの知識を新しくできることを示した。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6RAGは、生成モデルが学習で蓄えた知識(パラメトリックメモリ)と、検索で引き出す外部の文書の索引(ノンパラメトリックメモリ)を組み合わせる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7RAG(関連する情報をプロンプトに足す手法)は、モデルが学習していない独自のデータを使わせたり、答えを特定の資料の範囲に絞ったりする目的で使われる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8RAGでは、まず質問に関係する文書を検索し、見つけた文章をプロンプトに加えてから、LLMが答えを作る。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9RAGの準備では、文書を一定の長さの断片(チャンク)に分け、それぞれを埋め込み(Embedding)で数値の並び(ベクトル)に変えて、検索用の索引(ベクトルデータベース)を作る。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10RAGを提案した論文の検索の仕組みは、質問もベクトルに変え、文書のベクトルと比べて関連が強い上位の文書を取り出す。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11RAGで機密情報のように見られる人が限られた情報を使うときは、RAG用のデータへの参照権限を、利用者や役割に応じて設定する。データにタグ(メタデータ)を付けて分類し、見られる範囲を管理する方法もある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12RAGを使うシステムでは、検索の対象にする文書が事実にもとづいているかにも気を配る。検索した文書が間違っていれば、答えも間違いうる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13AI事業者ガイドラインは、RAGを使うと答えが似通いやすく(収束しやすく)なるため、多様さや独創性が要る業務ではRAGが向かない場合もあるとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
RAGとは(必要とされる理由と仕組み)の○×一問一答
1/8問解答 0・正解 0
AIエージェント
RAGとは(必要とされる理由と仕組み)|RAGの定義
RAGは、外部のデータベースから取得した知識にもとづいてLLMに回答を生成させる手法で、ファインチューニングを経ずに知識を広げることができる。
RAGとは(必要とされる理由と仕組み)の○×一問一答13問|問題と解説
この論点で収録している13問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
RAGとは(必要とされる理由と仕組み)|RAGの定義RAGは、外部のデータベースから取得した知識にもとづいてLLMに回答を生成させる手法で、ファインチューニングを経ずに知識を広げることができる。
答え:○(正しい)
解説
正しい。デジタル庁の生成AIの調達・利活用ガイドライン(第2.0版)の説明のとおり。RAGはRetrieval-Augmented Generationの略。ファインチューニングは、作り終えたモデルに追加で学習させること。RAGは、新人が社内の規程集を開いて該当ページを確かめてから答えるようなもので、新人の頭の中(モデル)を作り直さなくても新しい規程を使える。 要点:RAG(検索拡張生成)は、外部のデータベースから取り出した知識をもとにLLMに答えを作らせることで、知識に沿った答えにしたり、ファインチューニングをしなくても知識を広げたりする手法である。
問2
RAGとは(必要とされる理由と仕組み)|FTとの取り違えRAGは、外部のデータベースから取得した知識をファインチューニングでモデルのパラメータに学習させてから、回答を生成させる手法である。
答え:×(誤り)
解説
誤り。「ファインチューニングでパラメータに学習させてから」が誤り。RAGは、検索した文書を答えを作るときの追加の資料として渡す手法で、知識を足すのにモデルの学習し直しは必須ではない(ファインチューニングと組み合わせることはできる)。パラメータとは、モデルが学習で身につけた知識を蓄えている中身のこと。例えるなら、RAGは「試験に参考書を持ち込める」状態、ファインチューニングは「試験の前に勉強して覚え込む」状態である。 要点:RAGは、検索した知識をモデルに覚え込ませるのではなく、答えを作るときの参考資料として渡す。知識をモデルの中身(パラメータ)に取り込むのはファインチューニングで、RAGで知識を足すのにファインチューニングは必須ではない(両方を組み合わせることもできる)。
問3
RAGとは(必要とされる理由と仕組み)|期待される効果AI事業者ガイドラインは、RAGの活用によって、ハルシネーションの抑制や、出力の過程・根拠の透明性の向上が期待されているとしている。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(第1.2版)の注記のとおり。ハルシネーションとは、AIが事実と違うことをもっともらしく答えること。別添は、参照元を示せることが根拠の透明性につながると説明している。記憶だけで話す人より、「この資料の3ページにこう書いてあります」と出典を添えて話す人のほうが、間違いに気づきやすく信頼しやすいのと同じである。 要点:AI事業者ガイドラインは、RAGの活用などにより、ハルシネーション(もっともらしい誤り)の抑制や、出力の過程・根拠の透明性の向上が期待されているとしている。
問4
RAGとは(必要とされる理由と仕組み)|再学習なしで追加RAGで参照するデータソースを追加するには、そのたびにモデルの再トレーニングが必要になるため、ファインチューニングより費用がかかりやすい。
答え:×(誤り)
解説
誤り。「そのたびに再トレーニングが必要」が誤り。AI事業者ガイドラインの別添は、RAGはモデルの再トレーニングなしで参照するデータソースを追加でき、コストの低減が期待されるとしている。例えば、社内規程が改定されたら、新しい規程の文書を検索の対象に入れ替えるだけで済み、AIそのものを作り直す必要はない。 要点:RAGは、ファインチューニングと違い、モデルを学習し直さずに参照するデータを足せるため、費用を抑えられると期待されている。
問5
RAGとは(必要とされる理由と仕組み)|最新性RAGを提案した論文は、検索に使う文書の索引を入れ替えることで、世の中の変化に合わせてモデルの知識を新しくできることを示した。
答え:○(正しい)
解説
正しい。Lewisらの論文(NeurIPS 2020)のとおり。学習を終えたモデルだけでは、根拠を示すことや知識を新しくすることが難しい。索引とは、検索しやすいように文書を整理した目録のこと。図書館の本を新刊に入れ替えれば、司書(モデル)を替えなくても最新の情報で答えられるのと同じで、RAGは「最新性」を保つのに使われる。 要点:RAGを提案した論文は、検索に使う外部の記憶(文書の索引)を入れ替えることで、世の中の変化に合わせてモデルの知識を新しくできることを示した。
問6
RAGとは(必要とされる理由と仕組み)|2つの記憶RAGを提案した論文では、生成モデルのパラメータに蓄えた知識と、検索で引き出す外部の文書の索引という2種類の記憶を組み合わせている。
答え:○(正しい)
解説
正しい。RAGの論文のとおり。パラメトリックメモリは「頭の中の知識」、ノンパラメトリックメモリは「手元の資料棚」にあたる。論文ではWikipediaを資料棚にした。ベテラン社員が、身につけた知識(頭の中)とキャビネットの資料(棚)の両方を使って答えるのと同じ組み合わせである。 要点:RAGは、生成モデルが学習で蓄えた知識(パラメトリックメモリ)と、検索で引き出す外部の文書の索引(ノンパラメトリックメモリ)を組み合わせる。
問7
RAGとは(必要とされる理由と仕組み)|社内の独自データRAGは、モデルが学習していない社内の独自データを回答に使わせる目的には使えない。
答え:×(誤り)
解説
誤り。「使えない」が誤り。OpenAIのプロンプトエンジニアリングのガイドは、関連する情報をプロンプト(AIへの指示文)に加える理由として、独自のデータや学習データにないデータを使わせることを挙げ、この手法をRAGと呼んでいる。例えば、自社の商品マニュアルを検索させれば、世間に公開されていない自社製品の質問にも答えられる。 要点:RAG(関連する情報をプロンプトに足す手法)は、モデルが学習していない独自のデータを使わせたり、答えを特定の資料の範囲に絞ったりする目的で使われる。
問8
RAGとは(必要とされる理由と仕組み)|検索してから生成RAGでは、LLMがまず回答を生成し、そのあとで回答に合う文書を検索して、回答の末尾に貼り付ける。
答え:×(誤り)
解説
誤り。検索と生成の順番が逆である。RAGの論文は、入力をもとに文書を検索し、それを追加の材料にして答えを作ると説明している。OpenAIのガイドも、検索して返ってきた文章をプロンプトに含める方法を挙げている。料理で言えば、先に冷蔵庫の中身(資料)を確かめてから献立(答え)を決めるのであって、作ったあとで材料を探すのではない。 要点:RAGでは、まず質問に関係する文書を検索し、見つけた文章をプロンプトに加えてから、LLMが答えを作る。
問9
RAGとは(必要とされる理由と仕組み)|チャンク分割と埋め込みRAGを提案した論文では、Wikipediaの記事を一定の長さの断片に分け、断片ごとに埋め込み(ベクトル)を計算して検索用の索引を作っている。
答え:○(正しい)
解説
正しい。論文のとおり。デジタル庁のガイドラインも、RAGの部品としてテキストを分割するプログラム・ベクトルに変換するプログラム・ベクトルDBを挙げている。埋め込みは、文章の意味を数値の並びで表すこと。分厚いマニュアルを1ページずつに切り分け、ページごとに内容の目印を付けて棚に並べておくと、あとで必要なページだけを素早く取り出せるのと同じである。 要点:RAGの準備では、文書を一定の長さの断片(チャンク)に分け、それぞれを埋め込み(Embedding)で数値の並び(ベクトル)に変えて、検索用の索引(ベクトルデータベース)を作る。
問10
RAGとは(必要とされる理由と仕組み)|質問もベクトルにするRAGを提案した論文の検索器は、質問もベクトルに変換し、文書のベクトルと比べて関連が強い上位の文書を取り出す。
答え:○(正しい)
解説
正しい。論文の検索器(DPR)のとおり。質問と文書を同じ形の数値(ベクトル)にそろえ、近いものを探す。文字が一致するかではなく、表している内容が近いかで探せるのが特徴である。例えば「有給の取り方」と聞いても、「年次休暇の申請手続」と書かれた規程を見つけやすくなる(意味的検索の考え方)。 要点:RAGを提案した論文の検索の仕組みは、質問もベクトルに変え、文書のベクトルと比べて関連が強い上位の文書を取り出す。
問11
RAGとは(必要とされる理由と仕組み)|参照権限の設定RAGで機密情報を参照させる場合でも、利用者や役割によって参照権限を分ける必要はなく、全員が同じ範囲を検索できるようにしてよい。
答え:×(誤り)
解説
誤り。「分ける必要はない」が誤り。デジタル庁のガイドラインは、RAG用のデータへの参照権限を利用者や役割に応じて適切に設定するとしている。OWASPも、データにタグを付けて分類し見られる範囲を管理することを挙げる。人事部しか見られない給与表をRAGに入れたのに、全社員のAIが検索できたら、AI経由で給与が漏れてしまう。 要点:RAGで機密情報のように見られる人が限られた情報を使うときは、RAG用のデータへの参照権限を、利用者や役割に応じて設定する。データにタグ(メタデータ)を付けて分類し、見られる範囲を管理する方法もある。
問12
RAGとは(必要とされる理由と仕組み)|検索対象の正確性RAGでは、検索対象の文書が事実にもとづくかを確かめなくても、回答の正確性は保たれる。
答え:×(誤り)
解説
誤り。「確かめなくても正確性は保たれる」が誤り。J-AISIの評価観点ガイドは、RAGで検索の対象になる文書が事実にもとづくデータかに留意が必要としている。デジタル庁のガイドラインにも同じ確認の項目がある。古い料金表が検索の対象に残っていれば、AIは自信を持って古い料金を案内してしまう。正確さは資料の質に左右される。 要点:RAGを使うシステムでは、検索の対象にする文書が事実にもとづいているかにも気を配る。検索した文書が間違っていれば、答えも間違いうる。
問13
RAGとは(必要とされる理由と仕組み)|独創性が要る業務AI事業者ガイドラインは、RAGを活用すると回答の多様性が高まるため、独創性が求められる業務にこそ向いているとしている。
答え:×(誤り)
解説
誤り。ガイドラインの説明と逆である。ガイドラインは、RAGを使うと回答の収束が加速する可能性が高く、多様性・独創性が必要な業務では適切でない場合もあるとしている。過去の企画書ばかりを見せて新商品のアイデアを出させると、過去の企画に似た案ばかりになりがちなのと同じである。 要点:AI事業者ガイドラインは、RAGを使うと答えが似通いやすく(収束しやすく)なるため、多様さや独創性が要る業務ではRAGが向かない場合もあるとしている。
RAGとは(必要とされる理由と仕組み)の問題を続けて解く
この論点に対応する13問を絞り込んで出題します。