生成AIの実践と活用事例
Zero-Shot・Few-Shot・Chain-of-Thought
Zero-Shot は例を示さず指示だけ、One-Shot は例を1つ、Few-Shot は入力と答えの例をいくつか示すやり方で、どれもモデルの重みを更新しないコンテキスト内学習(In-Context Learning)です。Chain-of-Thought は答えまでの途中の考えを書かせる考え方で、十分に大きなモデルで、段階を踏む推論の性能が上がることを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
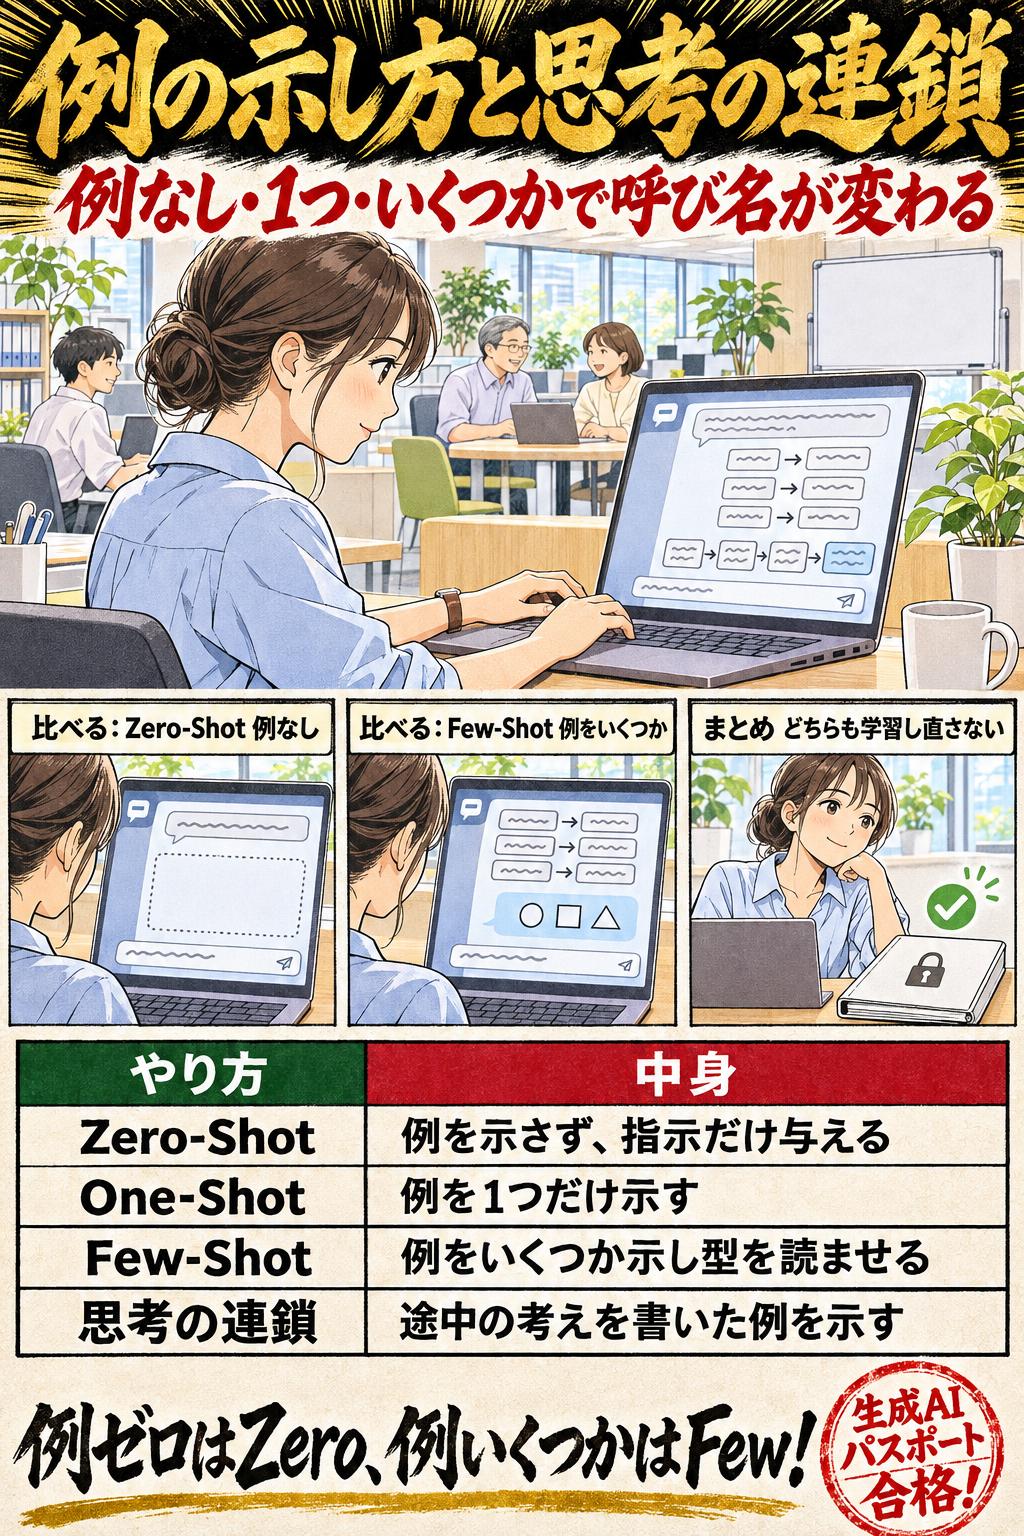
Zero-Shot は例を示さず指示だけ、One-Shot は例を1つ、Few-Shot は入力と答えの例をいくつか示すやり方で、どれもモデルの重みを更新しないコンテキスト内学習(In-Context Learning)です。Chain-of-Thought は答えまでの途中の考えを書かせる考え方で、十分に大きなモデルで、段階を踏む推論の性能が上がることを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 13問
Zero-Shot・Few-Shot・Chain-of-Thought|Zero-Shot とは
Zero-Shot は、解き方の例を示さず、タスク(やってほしい作業)を説明する指示だけをAIに与えるやり方である(GPT-3 の論文)。
比較して覚える
Zero-Shot・One-Shot・Few-Shot とファインチューニング
例を示さない Zero-Shot、例を1つ示す One-Shot、例をいくつか示す Few-Shot と、モデルを追加で学習させるファインチューニングを並べます。示す例の数と、モデルの重みを更新するかどうかの取り違えを切り分けます。
| 事由 | Zero-Shot | One-Shot | Few-Shot | ファインチューニング |
|---|---|---|---|---|
| プロンプトに示す例 | 示さない(タスクを説明する指示だけ) | 1つだけ示す(タスクの説明とあわせて) | いくつか示す(入力と望む答えの例) | プロンプトの例ではなく、タスク専用のデータで学習させる |
| モデルの重みの更新 | しない | しない | しない | する |
| 分類 | コンテキスト内学習 | コンテキスト内学習 | コンテキスト内学習 | 追加の学習 |
| 気をつけること | 表の形式など、タスクの形が伝わりにくいことがある | 人に仕事を頼むときによくある形(見本を1つ渡す)に近い | 似た例ばかりでなく、さまざまな入力の例を示す | タスク専用の学習データを用意する必要がある(GPT-3 の論文は、タスクごとに新しい大きなデータセットが要る点を当時の難点に挙げた) |
プロンプトに示す例
- Zero-Shot
- 示さない(タスクを説明する指示だけ)
- One-Shot
- 1つだけ示す(タスクの説明とあわせて)
- Few-Shot
- いくつか示す(入力と望む答えの例)
- ファインチューニング
- プロンプトの例ではなく、タスク専用のデータで学習させる
モデルの重みの更新
- Zero-Shot
- しない
- One-Shot
- しない
- Few-Shot
- しない
- ファインチューニング
- する
分類
- Zero-Shot
- コンテキスト内学習
- One-Shot
- コンテキスト内学習
- Few-Shot
- コンテキスト内学習
- ファインチューニング
- 追加の学習
気をつけること
- Zero-Shot
- 表の形式など、タスクの形が伝わりにくいことがある
- One-Shot
- 人に仕事を頼むときによくある形(見本を1つ渡す)に近い
- Few-Shot
- 似た例ばかりでなく、さまざまな入力の例を示す
- ファインチューニング
- タスク専用の学習データを用意する必要がある(GPT-3 の論文は、タスクごとに新しい大きなデータセットが要る点を当時の難点に挙げた)
この論点の用語
用語集をすべて見る →01Zero-Shot・Few-Shot・Chain-of-Thoughtの重要暗記項目
Zero-Shot・Few-Shot・Chain-of-Thought|Zero-Shot とは
Zero-Shot は、解き方の例を示さず、タスク(やってほしい作業)を説明する指示だけをAIに与えるやり方である(GPT-3 の論文)。
Zero-Shot・Few-Shot・Chain-of-Thought|指示文は与える
Zero-Shot でも、何をしてほしいかの指示は与える。与えないのは「例」である。
ひっかけ注意「Zero-Shot プロンプティングでは、例を示さないだけでなく、タスクを説明する指示文も与えず、処理したいデータだけをモデルに渡す」は誤り。 誤り。GPT-3 の論文は、Zero-Shot を「例は示さず、タスクを説明する自然言語の指示だけを与える」設定としている。示さないのは例で、指示は与える。たとえば議事録の文字だけを渡しても、要約してほしいのか誤字を直してほしいのかAIには分からない。「次の議事録を3行で要約して」と指示を添えるのが Zero-Shot である。
Zero-Shot・Few-Shot・Chain-of-Thought|例1つは One-Shot
例を1つだけ示し、タスクの説明とあわせて与えるのは One-Shot。例を示さないのが Zero-Shot、いくつか示すのが Few-Shot(GPT-3 の論文)。
ひっかけ注意「Zero-Shot プロンプティングでは、タスクの例を1つだけ示し、それにならってモデルに答えさせる」は誤り。 誤り。例を1つだけ示すのは One-Shot である。GPT-3 の論文は、One-Shot をタスクの説明に加えて例を1つだけ認める設定、Zero-Shot を例を認めず指示だけを与える設定として区別している。新人に「見本はこの1枚です」と渡して書類を作らせるのが One-Shot、見本なしで口頭の説明だけで頼むのが Zero-Shot。
Zero-Shot・Few-Shot・Chain-of-Thought|形式が伝わりにくい
例を示さない Zero-Shot では、表の形式や含める項目など、タスクの中身や形式が伝わりにくい場合がある。形式を伝えたいときは例を示すと伝わりやすい(GPT-3 の論文)。
Zero-Shot・Few-Shot・Chain-of-Thought|Few-Shot とは
Few-Shot は、入力と望む答えの例をいくつかプロンプトに入れ、AIにそのパターンを読み取らせて新しい入力に当てはめさせるやり方で、AIを追加で学習させることはしない(OpenAI のガイド)。
Zero-Shot・Few-Shot・Chain-of-Thought|重みは更新しない
Few-Shot では、頼むときに例を見せるだけで、AIの中身(重み=パラメータ)は変えない。中身を変えるのはファインチューニングである(GPT-3 の論文)。
ひっかけ注意「Few-Shot プロンプティングは、プロンプトに示した例を使ってモデルの重み(パラメータ)を更新するので、ファインチューニングの一種である」は誤り。 誤り。GPT-3 の論文は、Few-Shot を、例を条件として与えるが重みの更新は認めない設定とし、専用のデータで学習して重みを更新するファインチューニングと区別している。重み(パラメータ)は、AIが学習で身につけた知識を表す大量の数値。Few-Shot は「その場で見本を見せる」だけで、研修を受け直させる(ファインチューニング)のとは違う。
Zero-Shot・Few-Shot・Chain-of-Thought|例はいろいろな種類を
Few-Shot の例は、似たものばかりにせず、さまざまな入力とそれぞれの望む答えを示すのがよい(OpenAI のガイド)。
Zero-Shot・Few-Shot・Chain-of-Thought|コンテキスト内学習
大規模言語モデルが、学習済みの中身(パラメータ)を変えずに、プロンプトで与えた指示や例に応じてそのタスクをこなすことを、コンテキスト内学習(In-Context Learning)という。
覚える数字と、狙われる引っかけ
- ひっかけ「Zero-Shot プロンプティングでは、例を示さないだけでなく、タスクを説明する指示文も与えず、処理したいデータだけをモデルに渡す」は誤り。誤り。GPT-3 の論文は、Zero-Shot を「例は示さず、タスクを説明する自然言語の指示だけを与える」設定としている。示さないのは例で、指示は与える。たとえば議事録の文字だけを渡しても、要約してほしいのか誤字を直してほしいのかAIには分からない。「次の議事録を3行で要約して」と指示を添えるのが Zero-Shot である。
- ひっかけ「Zero-Shot プロンプティングでは、タスクの例を1つだけ示し、それにならってモデルに答えさせる」は誤り。誤り。例を1つだけ示すのは One-Shot である。GPT-3 の論文は、One-Shot をタスクの説明に加えて例を1つだけ認める設定、Zero-Shot を例を認めず指示だけを与える設定として区別している。新人に「見本はこの1枚です」と渡して書類を作らせるのが One-Shot、見本なしで口頭の説明だけで頼むのが Zero-Shot。
- ひっかけ「Few-Shot プロンプティングは、プロンプトに示した例を使ってモデルの重み(パラメータ)を更新するので、ファインチューニングの一種である」は誤り。誤り。GPT-3 の論文は、Few-Shot を、例を条件として与えるが重みの更新は認めない設定とし、専用のデータで学習して重みを更新するファインチューニングと区別している。重み(パラメータ)は、AIが学習で身につけた知識を表す大量の数値。Few-Shot は「その場で見本を見せる」だけで、研修を受け直させる(ファインチューニング)のとは違う。
- ひっかけ「Chain-of-Thought の論文は、思考の連鎖による推論の能力は小さな言語モデルほど現れやすく、モデルが大きくなると効果が薄れると報告している」は誤り。誤り。逆である。Chain-of-Thought の論文は、こうした推論の能力は十分に大きな言語モデル(sufficiently large language models)で、例を示すだけの簡単な方法によって自然に現れるとしている。途中式の見本を見せて効果が出るのは、もともと計算の地力がある人に限られるのと似ている。
- ひっかけ「Chain-of-Thought プロンプティングは、推論の過程を書いた大量のデータでモデルを追加学習(ファインチューニング)させる手法である」は誤り。誤り。Chain-of-Thought の論文のやり方は、思考の連鎖の例をいくつかプロンプトの中で示すもので、モデルを学習し直さない。プロンプトだけで済むので大きな学習データが要らず、算数の文章題では、追加学習した GPT-3 を上回った結果も報告されている。研修をやり直すのではなく、その場で解き方の見本を見せるだけ、と覚える。Few-Shot と同じく、頼み方の工夫の1つである。
- ひっかけ「OpenAI のガイドによると、推論モデルは内部で思考の連鎖を生成するぶん、GPT モデルより一般に速く、費用も安い」は誤り。誤り。OpenAI のガイドは、推論モデルは内部で思考の連鎖を生成し、複雑な課題や複数の段階の計画を得意とする一方で、一般に GPT モデルより遅く、費用も高いとしている。じっくり考える担当者は難しい案件に強いが、時間も人件費もかかるのと同じ。簡単な仕事は速くて安いモデル、込み入った仕事は推論モデル、と使い分ける。
02試験で正誤を分けるチェック順
- 1Zero-Shot は、解き方の例を示さず、タスク(やってほしい作業)を説明する指示だけをAIに与えるやり方である(GPT-3 の論文)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2Zero-Shot でも、何をしてほしいかの指示は与える。与えないのは「例」である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3例を1つだけ示し、タスクの説明とあわせて与えるのは One-Shot。例を示さないのが Zero-Shot、いくつか示すのが Few-Shot(GPT-3 の論文)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4例を示さない Zero-Shot では、表の形式や含める項目など、タスクの中身や形式が伝わりにくい場合がある。形式を伝えたいときは例を示すと伝わりやすい(GPT-3 の論文)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5Few-Shot は、入力と望む答えの例をいくつかプロンプトに入れ、AIにそのパターンを読み取らせて新しい入力に当てはめさせるやり方で、AIを追加で学習させることはしない(OpenAI のガイド)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6Few-Shot では、頼むときに例を見せるだけで、AIの中身(重み=パラメータ)は変えない。中身を変えるのはファインチューニングである(GPT-3 の論文)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7Few-Shot の例は、似たものばかりにせず、さまざまな入力とそれぞれの望む答えを示すのがよい(OpenAI のガイド)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8大規模言語モデルが、学習済みの中身(パラメータ)を変えずに、プロンプトで与えた指示や例に応じてそのタスクをこなすことを、コンテキスト内学習(In-Context Learning)という。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9Chain-of-Thought(思考の連鎖)は、答えに至るまでの途中の考えの段階のこと。Chain-of-Thought プロンプティングは、途中の考えを書いた解き方の例をいくつか示し、AIにも途中の考えを書かせるやり方である(Wei ほかの論文)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10Chain-of-Thought プロンプティングは、算数の文章題・常識の推論・記号の操作のように、いくつかの段階を踏んで考える課題で性能を高めた(Wei ほかの論文)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11思考の連鎖による推論の力は、十分に大きな言語モデルで自然に現れる(Wei ほかの論文)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12Chain-of-Thought プロンプティングは、途中の考えを書いた例をプロンプトに少し示すだけのやり方で、AIの追加学習(ファインチューニング)はしない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13推論モデルは、入力を分析するために内部で思考の連鎖を生成し、複雑な課題や何段階もの計画が得意な一方、一般に GPT モデルより遅く、費用も高い(OpenAI のガイド)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
Zero-Shot・Few-Shot・Chain-of-Thoughtの○×一問一答
1/8問解答 0・正解 0
生成AIの実践と活用事例
Zero-Shot・Few-Shot・Chain-of-Thought|Zero-Shot とは
Zero-Shot プロンプティングは、解き方の例を示さず、タスクを説明する自然言語の指示だけをモデルに与えて答えさせるやり方である。
Zero-Shot・Few-Shot・Chain-of-Thoughtの○×一問一答13問|問題と解説
この論点で収録している13問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
Zero-Shot・Few-Shot・Chain-of-Thought|Zero-Shot とはZero-Shot プロンプティングは、解き方の例を示さず、タスクを説明する自然言語の指示だけをモデルに与えて答えさせるやり方である。
答え:○(正しい)
解説
正しい。GPT-3 の論文は、Zero-Shot を、例(デモンストレーション)を一切与えず、タスクを説明する自然言語の指示だけを与える設定と定義している。ショット(shot)は「見せる例の数」のことで、ゼロは例なし。「この文章を英語にして」とだけ頼むのが Zero-Shot。手軽な一方、望む形式が伝わりにくいことがある。 要点:Zero-Shot は、解き方の例を示さず、タスク(やってほしい作業)を説明する指示だけをAIに与えるやり方である(GPT-3 の論文)。
問2
Zero-Shot・Few-Shot・Chain-of-Thought|指示文は与えるZero-Shot プロンプティングでは、例を示さないだけでなく、タスクを説明する指示文も与えず、処理したいデータだけをモデルに渡す。
答え:×(誤り)
解説
誤り。誤り。GPT-3 の論文は、Zero-Shot を「例は示さず、タスクを説明する自然言語の指示だけを与える」設定としている。示さないのは例で、指示は与える。たとえば議事録の文字だけを渡しても、要約してほしいのか誤字を直してほしいのかAIには分からない。「次の議事録を3行で要約して」と指示を添えるのが Zero-Shot である。 要点:Zero-Shot でも、何をしてほしいかの指示は与える。与えないのは「例」である。
問3
Zero-Shot・Few-Shot・Chain-of-Thought|例1つは One-ShotZero-Shot プロンプティングでは、タスクの例を1つだけ示し、それにならってモデルに答えさせる。
答え:×(誤り)
解説
誤り。誤り。例を1つだけ示すのは One-Shot である。GPT-3 の論文は、One-Shot をタスクの説明に加えて例を1つだけ認める設定、Zero-Shot を例を認めず指示だけを与える設定として区別している。新人に「見本はこの1枚です」と渡して書類を作らせるのが One-Shot、見本なしで口頭の説明だけで頼むのが Zero-Shot。 要点:例を1つだけ示し、タスクの説明とあわせて与えるのは One-Shot。例を示さないのが Zero-Shot、いくつか示すのが Few-Shot(GPT-3 の論文)。
問4
Zero-Shot・Few-Shot・Chain-of-Thought|形式が伝わりにくい例を示さずに「200m走の世界記録の表を作って」とだけ指示すると、表の形式や含める項目があいまいになりやすい。GPT-3 の論文も、例がないとタスクの内容や形式を伝えるのが難しい場合があると述べている。
答え:○(正しい)
解説
正しい。GPT-3 の論文は、「200m走の世界記録の表を作って」という頼み方では、どんな形式の表にするか、何を含めるかがあいまいになりうると例を挙げ、例がないとタスクの内容や形式を伝えにくいことがあるとしている。「売上の表を作って」だけでは月別か店別か分からないが、1行だけ見本を見せれば一気に伝わる。 要点:例を示さない Zero-Shot では、表の形式や含める項目など、タスクの中身や形式が伝わりにくい場合がある。形式を伝えたいときは例を示すと伝わりやすい(GPT-3 の論文)。
問5
Zero-Shot・Few-Shot・Chain-of-Thought|Few-Shot とはFew-Shot プロンプティングは、プロンプトの中に入力と望む出力の例をいくつか示し、モデルにそのパターンを読み取らせて新しい入力に当てはめさせるやり方である。
答え:○(正しい)
解説
正しい。OpenAI のガイドは、Few-shot learning を、ファインチューニング(作り終えたモデルに追加で学習させること)の代わりに、入力と出力の例をいくつかプロンプトに入れて新しいタスクへ導くやり方とし、モデルは例からパターンを読み取ると説明している。過去の問い合わせ対応の例を3件見せてから「この調子で返信して」と頼むのが Few-Shot。 要点:Few-Shot は、入力と望む答えの例をいくつかプロンプトに入れ、AIにそのパターンを読み取らせて新しい入力に当てはめさせるやり方で、AIを追加で学習させることはしない(OpenAI のガイド)。
問6
Zero-Shot・Few-Shot・Chain-of-Thought|重みは更新しないFew-Shot プロンプティングは、プロンプトに示した例を使ってモデルの重み(パラメータ)を更新するので、ファインチューニングの一種である。
答え:×(誤り)
解説
誤り。誤り。GPT-3 の論文は、Few-Shot を、例を条件として与えるが重みの更新は認めない設定とし、専用のデータで学習して重みを更新するファインチューニングと区別している。重み(パラメータ)は、AIが学習で身につけた知識を表す大量の数値。Few-Shot は「その場で見本を見せる」だけで、研修を受け直させる(ファインチューニング)のとは違う。 要点:Few-Shot では、頼むときに例を見せるだけで、AIの中身(重み=パラメータ)は変えない。中身を変えるのはファインチューニングである(GPT-3 の論文)。
問7
Zero-Shot・Few-Shot・Chain-of-Thought|例はいろいろな種類を問い合わせの文を「肯定的」「否定的」「中立」に分類させるために Few-Shot の例を用意するときは、似た例ばかりでなく、さまざまな入力とそれぞれの望む出力を示すのがよい。
答え:○(正しい)
解説
正しい。OpenAI のガイドは、例を示すときは、ありうる入力の幅広い範囲とそれぞれの望む出力を示すとよいとし、製品のレビューを肯定・否定・中立に分ける例を並べている。褒める口コミの見本ばかり見せると、不満の口コミの扱い方が伝わらない。窓口の研修で、喜ぶ客・怒る客・迷う客の例をそろえて見せるのと同じ。 要点:Few-Shot の例は、似たものばかりにせず、さまざまな入力とそれぞれの望む答えを示すのがよい(OpenAI のガイド)。
問8
Zero-Shot・Few-Shot・Chain-of-Thought|コンテキスト内学習大規模言語モデルが、学習済みのパラメータを更新しないまま、プロンプトで与えた指示や例に応じて特定のタスクをこなすことを、コンテキスト内学習(In-Context Learning)という。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(第1.2版)は、生成AIでは利用者がコンテキスト内学習と呼ばれる方法で、学習済パラメータを更新せずに、プロンプトに応じて特定のタスクを学ばせられるとしている。GPT-3 の論文も、指示や例でタスクを伝えるやり方を in-context learning と呼ぶ。コンテキストは「文脈」。会議の冒頭に配った資料を見て、その場で段取りをつかむ人のようなもの。 要点:大規模言語モデルが、学習済みの中身(パラメータ)を変えずに、プロンプトで与えた指示や例に応じてそのタスクをこなすことを、コンテキスト内学習(In-Context Learning)という。
問9
Zero-Shot・Few-Shot・Chain-of-Thought|Chain-of-Thought とはChain-of-Thought プロンプティングは、答えだけでなく、答えに至るまでの中間の推論の過程を書いた例をいくつかプロンプトに示し、モデルにも推論の過程を生成させるやり方である。
答え:○(正しい)
解説
正しい。Chain-of-Thought の論文は、思考の連鎖を一連の中間の推論の段階とし、途中の考えを書いた例をプロンプトに示すことで、大規模言語モデルの複雑な推論の性能が上がるとした。算数の文章題で、答えだけでなく「まず単価を出し、次に個数をかける」と途中式を書いた解答例を見せると、相手も途中式を書いて解くようになるのと同じ。 要点:Chain-of-Thought(思考の連鎖)は、答えに至るまでの途中の考えの段階のこと。Chain-of-Thought プロンプティングは、途中の考えを書いた解き方の例をいくつか示し、AIにも途中の考えを書かせるやり方である(Wei ほかの論文)。
問10
Zero-Shot・Few-Shot・Chain-of-Thought|CoT が効く課題Chain-of-Thought プロンプティングは、算数の文章題や常識の推論、記号の操作のような、複数の段階を踏む推論が必要な課題で性能を高めることが示された。
答え:○(正しい)
解説
正しい。Chain-of-Thought の論文は、3つの大規模言語モデルでの実験で、算数(arithmetic)、常識(commonsense)、記号(symbolic)の推論の課題の性能が上がったと報告している。推論は、分かっていることから筋道を立てて結論を出すこと。「割引後の金額に送料を足して、予算に収まるか」のように、手順を順に踏む問いほど途中の考えを書かせる効果が出やすい。 要点:Chain-of-Thought プロンプティングは、算数の文章題・常識の推論・記号の操作のように、いくつかの段階を踏んで考える課題で性能を高めた(Wei ほかの論文)。
問11
Zero-Shot・Few-Shot・Chain-of-Thought|大きなモデルで現れるChain-of-Thought の論文は、思考の連鎖による推論の能力は小さな言語モデルほど現れやすく、モデルが大きくなると効果が薄れると報告している。
答え:×(誤り)
解説
誤り。誤り。逆である。Chain-of-Thought の論文は、こうした推論の能力は十分に大きな言語モデル(sufficiently large language models)で、例を示すだけの簡単な方法によって自然に現れるとしている。途中式の見本を見せて効果が出るのは、もともと計算の地力がある人に限られるのと似ている。 要点:思考の連鎖による推論の力は、十分に大きな言語モデルで自然に現れる(Wei ほかの論文)。
問12
Zero-Shot・Few-Shot・Chain-of-Thought|CoT は追加学習ではないChain-of-Thought プロンプティングは、推論の過程を書いた大量のデータでモデルを追加学習(ファインチューニング)させる手法である。
答え:×(誤り)
解説
誤り。誤り。Chain-of-Thought の論文のやり方は、思考の連鎖の例をいくつかプロンプトの中で示すもので、モデルを学習し直さない。プロンプトだけで済むので大きな学習データが要らず、算数の文章題では、追加学習した GPT-3 を上回った結果も報告されている。研修をやり直すのではなく、その場で解き方の見本を見せるだけ、と覚える。Few-Shot と同じく、頼み方の工夫の1つである。 要点:Chain-of-Thought プロンプティングは、途中の考えを書いた例をプロンプトに少し示すだけのやり方で、AIの追加学習(ファインチューニング)はしない。
問13
Zero-Shot・Few-Shot・Chain-of-Thought|推論モデルの得手不得手OpenAI のガイドによると、推論モデルは内部で思考の連鎖を生成するぶん、GPT モデルより一般に速く、費用も安い。
答え:×(誤り)
解説
誤り。誤り。OpenAI のガイドは、推論モデルは内部で思考の連鎖を生成し、複雑な課題や複数の段階の計画を得意とする一方で、一般に GPT モデルより遅く、費用も高いとしている。じっくり考える担当者は難しい案件に強いが、時間も人件費もかかるのと同じ。簡単な仕事は速くて安いモデル、込み入った仕事は推論モデル、と使い分ける。 要点:推論モデルは、入力を分析するために内部で思考の連鎖を生成し、複雑な課題や何段階もの計画が得意な一方、一般に GPT モデルより遅く、費用も高い(OpenAI のガイド)。
Zero-Shot・Few-Shot・Chain-of-Thoughtの問題を続けて解く
この論点に対応する13問を絞り込んで出題します。