生成AIのリスク予防・AI倫理・ガバナンス
生成AIのリスクの全体像・ハルシネーション・情報漏えい
生成AIのリスクには、権利侵害・情報漏えい・誤った出力の鵜呑み・攻撃への悪用などがあり、社会全体への影響も含めて考えます。ハルシネーション(事実と異なる内容をもっともらしく出力すること)はRAGで抑制できても無くならないこと、入力した情報が運営企業に渡り学習に使われうることと、設定や規約の確認で防ぐことを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
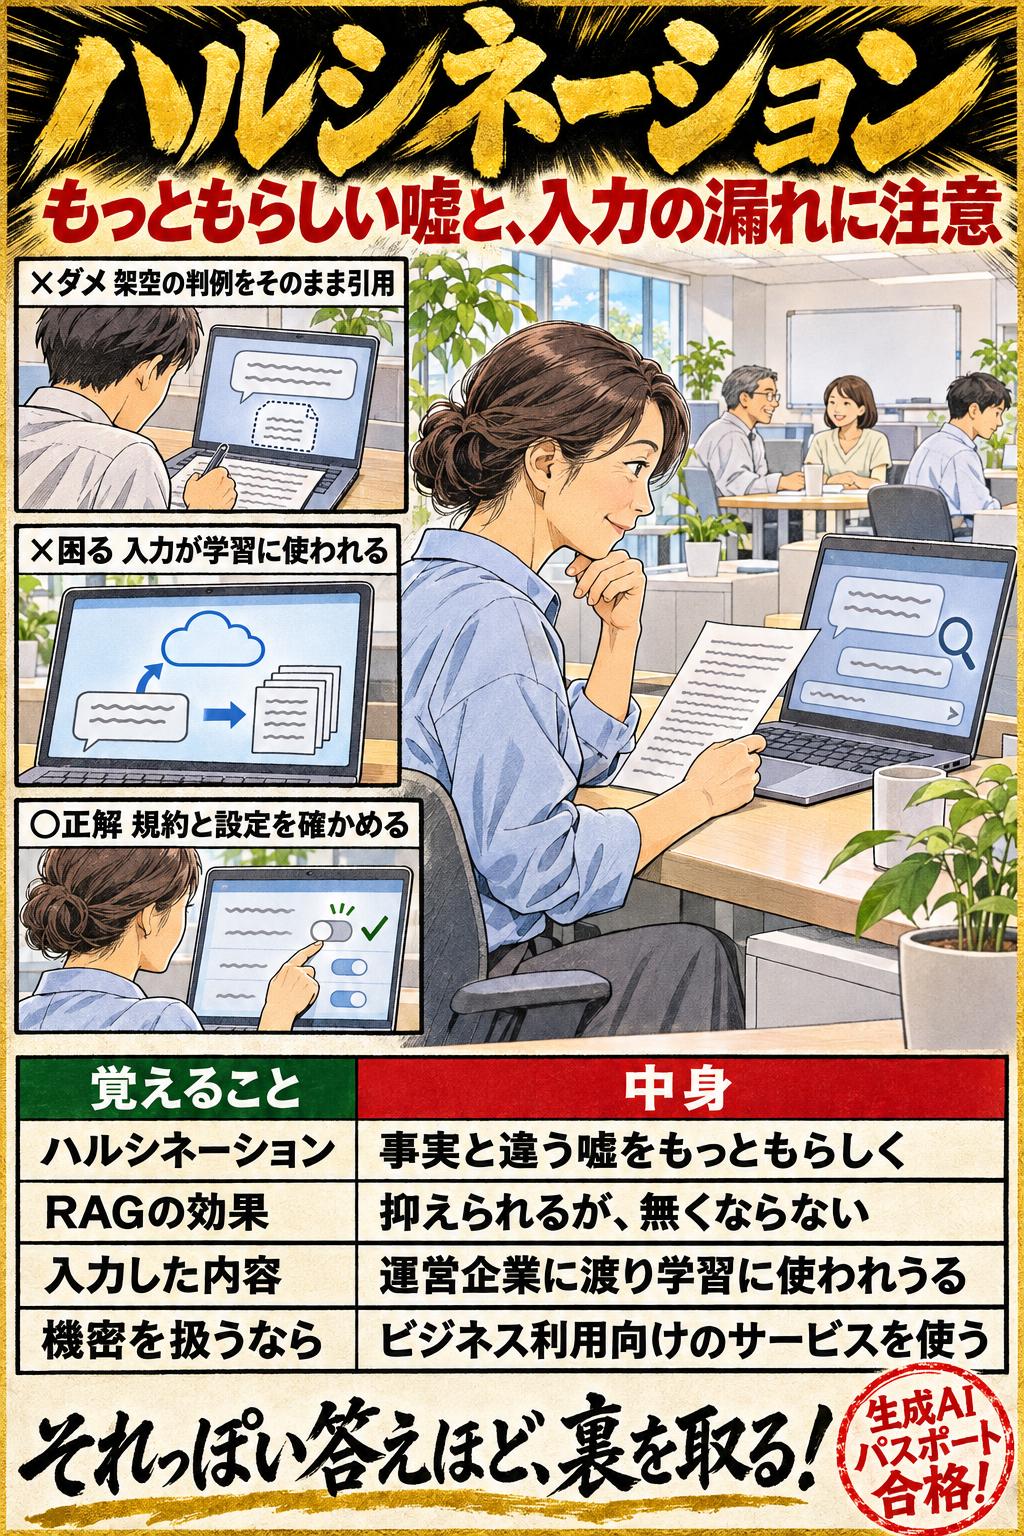
生成AIのリスクには、権利侵害・情報漏えい・誤った出力の鵜呑み・攻撃への悪用などがあり、社会全体への影響も含めて考えます。ハルシネーション(事実と異なる内容をもっともらしく出力すること)はRAGで抑制できても無くならないこと、入力した情報が運営企業に渡り学習に使われうることと、設定や規約の確認で防ぐことを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 13問
生成AIのリスクの全体像・ハルシネーション・情報漏えい|AIのリスクが10大脅威に
IPA「情報セキュリティ10大脅威 2026」の組織編では、「AIの利用をめぐるサイバーリスク」が初めて選ばれ、3位となった。
この論点の用語
用語集をすべて見る →01生成AIのリスクの全体像・ハルシネーション・情報漏えいの重要暗記項目
生成AIのリスクの全体像・ハルシネーション・情報漏えい|AIのリスクが10大脅威に
IPA「情報セキュリティ10大脅威 2026」の組織編では、「AIの利用をめぐるサイバーリスク」が初めて選ばれ、3位となった。
生成AIのリスクの全体像・ハルシネーション・情報漏えい|順位は危険度ではない
IPAは、組織の10大脅威の順位は危険度を表すものではなく、選考会の参加者が社会的に影響が大きかったと判断した脅威の順であるとしている。
ひっかけ注意「IPAの10大脅威の組織編の順位は各脅威の危険度の高さを表しており、3位のAIのリスクは4位以下の脅威より危険度が高いことを示している」は誤り。 IPAは「順位が危険度を表しているわけではない」としている。順位は、選考会の参加者が、前年の被害事例などから社会的な影響が大きかったと判断した順である。たとえば、ある会社にとっては10位のビジネスメール詐欺のほうが、3位のAIのリスクより身近で深刻なこともありうる。順位にとらわれず、自社の業務にどのリスクがあるかを洗い出すことが大事だとしている。
生成AIのリスクの全体像・ハルシネーション・情報漏えい|AIをめぐる問題の全体像
IPAは、AIの利用をめぐる問題として、AIへの不十分な理解による他者の権利侵害や情報漏えい、加工・生成した結果を十分に検証せず鵜呑みにすることで生じる問題、AIの悪用によるサイバー攻撃の容易化や手口の巧妙化を挙げている。
生成AIのリスクの全体像・ハルシネーション・情報漏えい|社会全体へのリスクも見る
AI事業者ガイドラインの別添は、リスクは各事業者に発生する不利益だけでなく、ステークホルダー及び社会全体に発生するリスクも検討対象になるとしている。
ひっかけ注意「AI事業者ガイドラインの別添は、AIのリスクとして検討するのは、AIを使う事業者自身に生じる不利益だけでよいとしている」は誤り。 AI事業者ガイドラインの別添は、リスクは各事業者に生じる不利益だけでなく、ステークホルダー(取引先や利用者など、AIの活用で影響を受けうる全ての人や組織)や社会全体に生じるリスクも検討の対象としている。たとえば、AIで作られた偽の事故情報を企業のアカウントが拡散すれば、自社の信用だけでなく、読んだ人の行動や社会の混乱にもつながる。
生成AIのリスクの全体像・ハルシネーション・情報漏えい|ハルシネーションとは
ハルシネーションとは、生成AIが事実とは異なる嘘の回答を生成すること(架空の情報をあたかも事実として生成すること)をいう。学習データに不適切なデータを混ぜて不正動作を狙う攻撃は、データポイズニングという。
ひっかけ注意「ハルシネーションとは、攻撃者が不正なデータを学習データに混ぜ込み、AIモデルに誤った動作をさせるサイバー攻撃のことである」は誤り。 問題文はデータポイズニング(学習データに不正なデータを混ぜてAIを誤動作させる攻撃)の説明である。ハルシネーションは、生成AIが事実と異なる内容を、あたかも事実のように答えることをいう(IPA)。たとえば、実在しない社内規程の条番号をもっともらしく示すのがハルシネーションで、誰かの攻撃がなくても起こる。原因も対策も違うので取り違えない。
生成AIのリスクの全体像・ハルシネーション・情報漏えい|知らないと答えない
IPAの用語集は、最新の生成AIでも、架空の大学や企業のプロフィールを尋ねると「そのような組織は知りません」と答えずに、出鱈目なプロフィールを回答する傾向があるとしている。
生成AIのリスクの全体像・ハルシネーション・情報漏えい|実在しない判例の引用
米国では、生成AIを用いて作成した意見書に実在しない判例が引用されていたことが判明し、その弁護士は生成AIでハルシネーションが起こりうることを知らなかったという事例がある。
生成AIのリスクの全体像・ハルシネーション・情報漏えい|RAGでも無くならない
AI事業者ガイドラインは、RAG(検索拡張生成)の活用等により、ハルシネーションの抑制や出力過程・根拠の透明性の向上等が期待されているとしている。抑制であって、無くなるわけではない。
ひっかけ注意「AI事業者ガイドラインは、RAG(検索拡張生成)を使えばハルシネーションは発生しなくなるとしている」は誤り。 AI事業者ガイドラインは、RAGの活用でハルシネーションの「抑制」や根拠の透明性の向上が期待されるとしており、無くなるとはしていない。RAG(検索拡張生成)は、答える前に社内文書などを探して読み込み、それをもとに答える仕組みである。たとえば、規程集を見ながら答える新人でも、関係のないページを読み違えることはある。参照元を示せるので確かめやすくなるのが利点である。
覚える数字と、狙われる引っかけ
- ひっかけ「IPAの10大脅威の組織編の順位は各脅威の危険度の高さを表しており、3位のAIのリスクは4位以下の脅威より危険度が高いことを示している」は誤り。IPAは「順位が危険度を表しているわけではない」としている。順位は、選考会の参加者が、前年の被害事例などから社会的な影響が大きかったと判断した順である。たとえば、ある会社にとっては10位のビジネスメール詐欺のほうが、3位のAIのリスクより身近で深刻なこともありうる。順位にとらわれず、自社の業務にどのリスクがあるかを洗い出すことが大事だとしている。
- ひっかけ「AI事業者ガイドラインの別添は、AIのリスクとして検討するのは、AIを使う事業者自身に生じる不利益だけでよいとしている」は誤り。AI事業者ガイドラインの別添は、リスクは各事業者に生じる不利益だけでなく、ステークホルダー(取引先や利用者など、AIの活用で影響を受けうる全ての人や組織)や社会全体に生じるリスクも検討の対象としている。たとえば、AIで作られた偽の事故情報を企業のアカウントが拡散すれば、自社の信用だけでなく、読んだ人の行動や社会の混乱にもつながる。
- ひっかけ「ハルシネーションとは、攻撃者が不正なデータを学習データに混ぜ込み、AIモデルに誤った動作をさせるサイバー攻撃のことである」は誤り。問題文はデータポイズニング(学習データに不正なデータを混ぜてAIを誤動作させる攻撃)の説明である。ハルシネーションは、生成AIが事実と異なる内容を、あたかも事実のように答えることをいう(IPA)。たとえば、実在しない社内規程の条番号をもっともらしく示すのがハルシネーションで、誰かの攻撃がなくても起こる。原因も対策も違うので取り違えない。
- ひっかけ「AI事業者ガイドラインは、RAG(検索拡張生成)を使えばハルシネーションは発生しなくなるとしている」は誤り。AI事業者ガイドラインは、RAGの活用でハルシネーションの「抑制」や根拠の透明性の向上が期待されるとしており、無くなるとはしていない。RAG(検索拡張生成)は、答える前に社内文書などを探して読み込み、それをもとに答える仕組みである。たとえば、規程集を見ながら答える新人でも、関係のないページを読み違えることはある。参照元を示せるので確かめやすくなるのが利点である。
- ひっかけ「チャットAIに入力した内容は、サービスの規約や設定にかかわらず必ず学習に使われるため、学習の対象から除外する方法はない」は誤り。IPAの資料は、サービス規約やチャットAIの利用時の設定を確認することで、入力を保存や学習の対象から除外できるとしている。必ず学習に使われるわけではない。たとえば、入力を学習に使わない設定にしてから使う、学習に使わないと規約で定めた業務用のプランを選ぶ、といった方法がある。業務で使う前に、規約と設定を確かめるのが基本である。
- ひっかけ「個人情報保護委員会は、生成AIサービスに入力された個人情報は、出力されるときには必ず正確な内容になるため、不正確な個人情報が出力されるリスクはないとしている」は誤り。個人情報保護委員会の注意喚起(令和5年6月2日)は、入力された個人情報が機械学習に使われ、他の情報と統計的に結びついたうえで「正確又は不正確な内容で」出力されるリスクがあるとしている。たとえば、顧客の名前と苦情の内容を入力すると、別の人への回答で、その顧客の名前と事実と違う話が組み合わされて出てくるおそれがある。入力するかは、このリスクを踏まえて判断する。
02試験で正誤を分けるチェック順
- 1IPA「情報セキュリティ10大脅威 2026」の組織編では、「AIの利用をめぐるサイバーリスク」が初めて選ばれ、3位となった。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2IPAは、組織の10大脅威の順位は危険度を表すものではなく、選考会の参加者が社会的に影響が大きかったと判断した脅威の順であるとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3IPAは、AIの利用をめぐる問題として、AIへの不十分な理解による他者の権利侵害や情報漏えい、加工・生成した結果を十分に検証せず鵜呑みにすることで生じる問題、AIの悪用によるサイバー攻撃の容易化や手口の巧妙化を挙げている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4AI事業者ガイドラインの別添は、リスクは各事業者に発生する不利益だけでなく、ステークホルダー及び社会全体に発生するリスクも検討対象になるとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5ハルシネーションとは、生成AIが事実とは異なる嘘の回答を生成すること(架空の情報をあたかも事実として生成すること)をいう。学習データに不適切なデータを混ぜて不正動作を狙う攻撃は、データポイズニングという。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6IPAの用語集は、最新の生成AIでも、架空の大学や企業のプロフィールを尋ねると「そのような組織は知りません」と答えずに、出鱈目なプロフィールを回答する傾向があるとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7米国では、生成AIを用いて作成した意見書に実在しない判例が引用されていたことが判明し、その弁護士は生成AIでハルシネーションが起こりうることを知らなかったという事例がある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8AI事業者ガイドラインは、RAG(検索拡張生成)の活用等により、ハルシネーションの抑制や出力過程・根拠の透明性の向上等が期待されているとしている。抑制であって、無くなるわけではない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9AIがプログラムのコード生成時に存在しないパッケージ名を提案してしまうハルシネーションを悪用し、その名前でマルウェアのパッケージを登録して開発者にインストールさせる攻撃の実例が報告されている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10クラウド型のチャットAIに入力した内容は運営企業に渡り、ユーザーとのやりとりが将来のAI改良のための学習データとして運営企業に流用される場合がある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11利用するチャットAIのサービス規約や利用時の設定を確認することで、ユーザーの入力を保存や学習の対象から除外できる場合がある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12個人情報保護委員会は、生成AIサービスに入力された個人情報が機械学習に利用され、他の情報と統計的に結びついた上で、正確又は不正確な内容で出力されるリスクがあるとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13AI事業者ガイドラインの別添は、従業員が機密情報に当たるソースコードを業務外利用者向けの対話型生成AIに入力してしまう事例を挙げ、企業が機密情報を処理する場合は、エンタープライズグレードのセキュリティ機能が組み込まれたビジネス利用向けのサービスを使うことが推奨されるとしている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
生成AIのリスクの全体像・ハルシネーション・情報漏えいの○×一問一答
1/8問解答 0・正解 0
生成AIのリスク予防・AI倫理・ガバナンス
生成AIのリスクの全体像・ハルシネーション・情報漏えい|AIのリスクが10大脅威に
IPAの「情報セキュリティ10大脅威 2026」の組織編では、「AIの利用をめぐるサイバーリスク」が初めて選ばれ、3位に入った。
生成AIのリスクの全体像・ハルシネーション・情報漏えいの○×一問一答13問|問題と解説
この論点で収録している13問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
生成AIのリスクの全体像・ハルシネーション・情報漏えい|AIのリスクが10大脅威にIPAの「情報セキュリティ10大脅威 2026」の組織編では、「AIの利用をめぐるサイバーリスク」が初めて選ばれ、3位に入った。
答え:○(正しい)
解説
正しい。IPAの解説書のとおり。「情報セキュリティ10大脅威」は、前年に社会的な影響が大きかった事故や攻撃から、専門家の投票で選ぶ一覧である。2026年版の組織編で、AIに関するリスクが初めて入った。AIへの理解が足りないまま使うと、権利侵害や情報漏えいにつながることがあるとしている。たとえば、社員が便利だからと社外秘の資料をそのままAIに貼り付ける使い方がそれに当たる。 要点:IPA「情報セキュリティ10大脅威 2026」の組織編では、「AIの利用をめぐるサイバーリスク」が初めて選ばれ、3位となった。
問2
生成AIのリスクの全体像・ハルシネーション・情報漏えい|順位は危険度ではないIPAの10大脅威の組織編の順位は各脅威の危険度の高さを表しており、3位のAIのリスクは4位以下の脅威より危険度が高いことを示している。
答え:×(誤り)
解説
誤り。IPAは「順位が危険度を表しているわけではない」としている。順位は、選考会の参加者が、前年の被害事例などから社会的な影響が大きかったと判断した順である。たとえば、ある会社にとっては10位のビジネスメール詐欺のほうが、3位のAIのリスクより身近で深刻なこともありうる。順位にとらわれず、自社の業務にどのリスクがあるかを洗い出すことが大事だとしている。 要点:IPAは、組織の10大脅威の順位は危険度を表すものではなく、選考会の参加者が社会的に影響が大きかったと判断した脅威の順であるとしている。
問3
生成AIのリスクの全体像・ハルシネーション・情報漏えい|AIをめぐる問題の全体像IPAは、AIの利用をめぐるリスクとして、AIへの理解不足による権利侵害や情報漏えいに加えて、AIの悪用によってサイバー攻撃が容易になることも挙げている。
答え:○(正しい)
解説
正しい。IPAの解説書の3位の説明のとおり。AIのリスクは、使う側の理解不足から起きるもの(権利侵害・情報漏えい・結果の鵜呑み)と、攻撃者がAIを悪用するもの(攻撃の容易化・手口の巧妙化)に分けると整理しやすい。たとえば、前者は社員がAIで作った画像を確認せずに広告に使うこと、後者は詐欺グループがAIで自然な日本語の詐欺メールを大量に作ることである。 要点:IPAは、AIの利用をめぐる問題として、AIへの不十分な理解による他者の権利侵害や情報漏えい、加工・生成した結果を十分に検証せず鵜呑みにすることで生じる問題、AIの悪用によるサイバー攻撃の容易化や手口の巧妙化を挙げている。
問4
生成AIのリスクの全体像・ハルシネーション・情報漏えい|社会全体へのリスクも見るAI事業者ガイドラインの別添は、AIのリスクとして検討するのは、AIを使う事業者自身に生じる不利益だけでよいとしている。
答え:×(誤り)
解説
誤り。AI事業者ガイドラインの別添は、リスクは各事業者に生じる不利益だけでなく、ステークホルダー(取引先や利用者など、AIの活用で影響を受けうる全ての人や組織)や社会全体に生じるリスクも検討の対象としている。たとえば、AIで作られた偽の事故情報を企業のアカウントが拡散すれば、自社の信用だけでなく、読んだ人の行動や社会の混乱にもつながる。 要点:AI事業者ガイドラインの別添は、リスクは各事業者に発生する不利益だけでなく、ステークホルダー及び社会全体に発生するリスクも検討対象になるとしている。
問5
生成AIのリスクの全体像・ハルシネーション・情報漏えい|ハルシネーションとはハルシネーションとは、攻撃者が不正なデータを学習データに混ぜ込み、AIモデルに誤った動作をさせるサイバー攻撃のことである。
答え:×(誤り)
解説
誤り。問題文はデータポイズニング(学習データに不正なデータを混ぜてAIを誤動作させる攻撃)の説明である。ハルシネーションは、生成AIが事実と異なる内容を、あたかも事実のように答えることをいう(IPA)。たとえば、実在しない社内規程の条番号をもっともらしく示すのがハルシネーションで、誰かの攻撃がなくても起こる。原因も対策も違うので取り違えない。 要点:ハルシネーションとは、生成AIが事実とは異なる嘘の回答を生成すること(架空の情報をあたかも事実として生成すること)をいう。学習データに不適切なデータを混ぜて不正動作を狙う攻撃は、データポイズニングという。
問6
生成AIのリスクの全体像・ハルシネーション・情報漏えい|知らないと答えないIPAの用語集では、最新の生成AIでも、架空の企業のプロフィールを尋ねると「知らない」と答えずに出鱈目なプロフィールを回答する傾向があると説明している。
答え:○(正しい)
解説
正しい。IPAの用語集の説明のとおり。生成AIは、知らないことを「知らない」と言うより、それらしい答えを作ってしまう傾向がある。たとえば、新しく取引を始める小さな会社の名前を入れて沿革を尋ねると、実際とは違う設立年や事業内容が並ぶことがある。知らない相手や新しい情報ほど、会社の公式サイトなど元の情報で確かめる。 要点:IPAの用語集は、最新の生成AIでも、架空の大学や企業のプロフィールを尋ねると「そのような組織は知りません」と答えずに、出鱈目なプロフィールを回答する傾向があるとしている。
問7
生成AIのリスクの全体像・ハルシネーション・情報漏えい|実在しない判例の引用IPAが紹介した米国の事例では、生成AIを用いて作成した意見書に実在しない判例が引用されていたことが判明し、その弁護士はハルシネーションが起こりうることを知らなかったという。
答え:○(正しい)
解説
正しい。IPAの解説書が紹介した2025年1月の米国テキサス州の事例のとおり。専門家でも、生成AIがハルシネーションを起こしうると知らなければ、出力を信じてしまう。たとえば、社内の稟議書にAIが挙げた業界統計を引用する場合も、元の統計資料が本当にあるか、数字が合っているかを確かめないと、同じ失敗になる。性質を知っておくことが対策の第一歩である。 要点:米国では、生成AIを用いて作成した意見書に実在しない判例が引用されていたことが判明し、その弁護士は生成AIでハルシネーションが起こりうることを知らなかったという事例がある。
問8
生成AIのリスクの全体像・ハルシネーション・情報漏えい|RAGでも無くならないAI事業者ガイドラインは、RAG(検索拡張生成)を使えばハルシネーションは発生しなくなるとしている。
答え:×(誤り)
解説
誤り。AI事業者ガイドラインは、RAGの活用でハルシネーションの「抑制」や根拠の透明性の向上が期待されるとしており、無くなるとはしていない。RAG(検索拡張生成)は、答える前に社内文書などを探して読み込み、それをもとに答える仕組みである。たとえば、規程集を見ながら答える新人でも、関係のないページを読み違えることはある。参照元を示せるので確かめやすくなるのが利点である。 要点:AI事業者ガイドラインは、RAG(検索拡張生成)の活用等により、ハルシネーションの抑制や出力過程・根拠の透明性の向上等が期待されているとしている。抑制であって、無くなるわけではない。
問9
生成AIのリスクの全体像・ハルシネーション・情報漏えい|存在しない部品名の悪用AIがプログラムの生成時に存在しないパッケージ名を提案してしまうハルシネーションを悪用し、その名前で不正なパッケージを登録してインストールさせる攻撃の例が報告されている。
答え:○(正しい)
解説
正しい。IPAの解説書のコラムが紹介した攻撃である。パッケージとは、プログラムを作るときに組み込む、他の人が作った部品のこと。AIが架空の部品名を提案する性質を逆手に取り、攻撃者がその名前で悪意のある部品を公開しておく。たとえるなら、AIが口にした架空の店の名前で、詐欺師が本当に偽の店を開いて客を待つようなものである。AIが書いたコードも確かめてから使う。 要点:AIがプログラムのコード生成時に存在しないパッケージ名を提案してしまうハルシネーションを悪用し、その名前でマルウェアのパッケージを登録して開発者にインストールさせる攻撃の実例が報告されている。
問10
生成AIのリスクの全体像・ハルシネーション・情報漏えい|入力は運営企業に渡るインターネット経由で使うクラウド型のチャットAIに入力した内容は、運営企業に渡り、将来のAIの改良のための学習データとして使われる場合がある。
答え:○(正しい)
解説
正しい。IPA「AI利用者のためのセキュリティ豆知識」のとおり。クラウド型(インターネット経由で事業者のコンピュータを使う形)のチャットAIでは、入力した内容は運営企業に送られる。たとえば、新製品の未発表の企画書を貼り付けて要約させると、その内容は社外の事業者に渡ったことになり、学習データとして使われる場合もある。入力した時点で社外に出た、と考えておく。 要点:クラウド型のチャットAIに入力した内容は運営企業に渡り、ユーザーとのやりとりが将来のAI改良のための学習データとして運営企業に流用される場合がある。
問11
生成AIのリスクの全体像・ハルシネーション・情報漏えい|規約と設定で除外できるチャットAIに入力した内容は、サービスの規約や設定にかかわらず必ず学習に使われるため、学習の対象から除外する方法はない。
答え:×(誤り)
解説
誤り。IPAの資料は、サービス規約やチャットAIの利用時の設定を確認することで、入力を保存や学習の対象から除外できるとしている。必ず学習に使われるわけではない。たとえば、入力を学習に使わない設定にしてから使う、学習に使わないと規約で定めた業務用のプランを選ぶ、といった方法がある。業務で使う前に、規約と設定を確かめるのが基本である。 要点:利用するチャットAIのサービス規約や利用時の設定を確認することで、ユーザーの入力を保存や学習の対象から除外できる場合がある。
問12
生成AIのリスクの全体像・ハルシネーション・情報漏えい|入力した個人情報の出力個人情報保護委員会は、生成AIサービスに入力された個人情報は、出力されるときには必ず正確な内容になるため、不正確な個人情報が出力されるリスクはないとしている。
答え:×(誤り)
解説
誤り。個人情報保護委員会の注意喚起(令和5年6月2日)は、入力された個人情報が機械学習に使われ、他の情報と統計的に結びついたうえで「正確又は不正確な内容で」出力されるリスクがあるとしている。たとえば、顧客の名前と苦情の内容を入力すると、別の人への回答で、その顧客の名前と事実と違う話が組み合わされて出てくるおそれがある。入力するかは、このリスクを踏まえて判断する。 要点:個人情報保護委員会は、生成AIサービスに入力された個人情報が機械学習に利用され、他の情報と統計的に結びついた上で、正確又は不正確な内容で出力されるリスクがあるとしている。
問13
生成AIのリスクの全体像・ハルシネーション・情報漏えい|機密情報はビジネス向けでAI事業者ガイドラインの別添は、企業が機密情報を処理する場合には、エンタープライズグレードのセキュリティ機能が組み込まれたビジネス利用向けの対話型生成AIを使うことを推奨している。
答え:○(正しい)
解説
正しい。AI事業者ガイドラインの別添のとおり。エンタープライズグレードとは、企業での利用を想定した水準のことで、ここでは企業向けのセキュリティ機能を備えたサービスを指す。別添は、従業員が社外秘のソースコード(プログラムの設計図にあたる文字列)を一般向けのAIに入力した事例を挙げている。たとえば、会社が契約した業務用のAIを使い、個人で登録した無料版には業務の情報を入れない。 要点:AI事業者ガイドラインの別添は、従業員が機密情報に当たるソースコードを業務外利用者向けの対話型生成AIに入力してしまう事例を挙げ、企業が機密情報を処理する場合は、エンタープライズグレードのセキュリティ機能が組み込まれたビジネス利用向けのサービスを使うことが推奨されるとしている。
生成AIのリスクの全体像・ハルシネーション・情報漏えいの問題を続けて解く
この論点に対応する13問を絞り込んで出題します。