AIの基礎と歴史
CNN・RNN・LSTM
CNN(畳み込みニューラルネットワーク)は画像のような格子状のデータを畳み込みという演算で処理し、物体認識などのコンピュータビジョンで成果を上げました。RNN(再帰型ニューラルネットワーク)は文章や音声のような順番のあるシーケンスデータを、前の時点の計算結果を引き継いで処理しますが、長い系列では勾配消失問題・勾配爆発問題が起きやすく、LSTMはゲートで情報の出し入れを調整してこれを和らげました。Transformerは再帰も畳み込みも使わず、系列の中の関係をAttentionでとらえます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
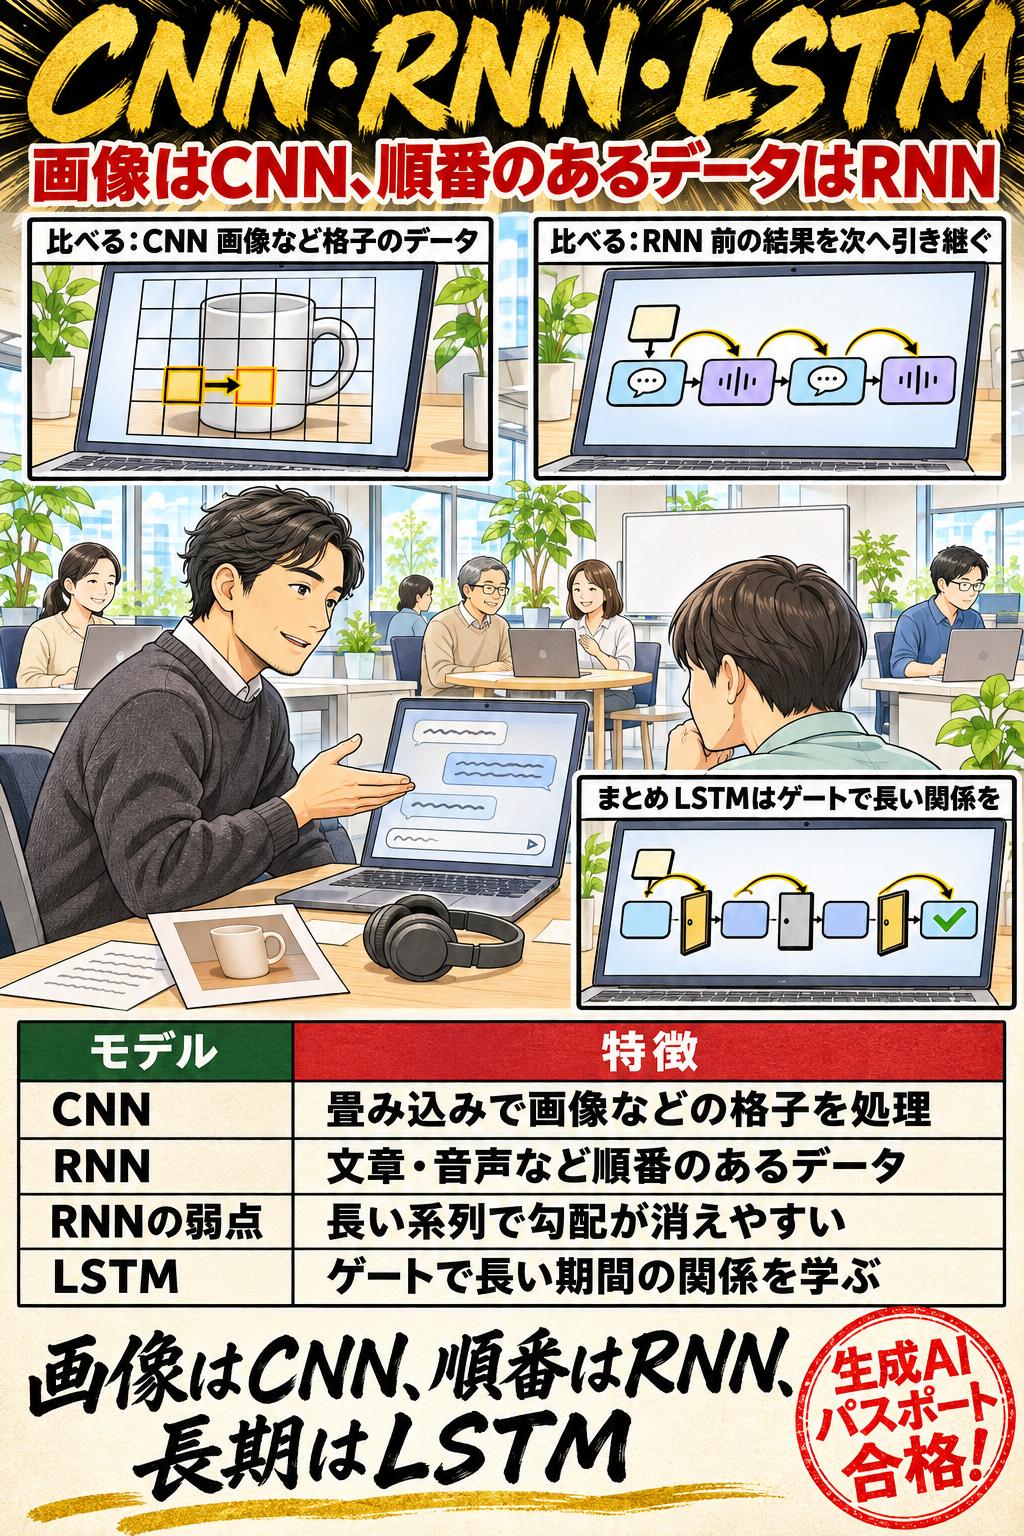
CNN(畳み込みニューラルネットワーク)は画像のような格子状のデータを畳み込みという演算で処理し、物体認識などのコンピュータビジョンで成果を上げました。RNN(再帰型ニューラルネットワーク)は文章や音声のような順番のあるシーケンスデータを、前の時点の計算結果を引き継いで処理しますが、長い系列では勾配消失問題・勾配爆発問題が起きやすく、LSTMはゲートで情報の出し入れを調整してこれを和らげました。Transformerは再帰も畳み込みも使わず、系列の中の関係をAttentionでとらえます。
このサイトでの学習
学習優先度 A対応する一問一答 15問
CNN・RNN・LSTM|CNNが得意なデータ
CNNは、格子状に並んだデータ(画像は2次元のピクセルの格子、時系列は1次元の格子)の処理に特化したニューラルネットワークである。
比較して覚える
CNN・RNN・LSTM・Transformerの違い
代表的な4つのモデルを、得意なデータと仕組みで並べます。画像のCNNと系列のRNN、RNNの弱点をゲートで和らげたLSTM、再帰も畳み込みも使わないTransformerを取り違える肢を切り分けられます。
| 事由 | CNN | RNN | LSTM | Transformer |
|---|---|---|---|---|
| 得意なデータ | 画像のような格子状のデータ | 文章・音声のような順番のあるシーケンスデータ | RNNと同じくシーケンスデータ(長い期間の関係がある系列) | 文章などの系列(論文では機械翻訳で評価) |
| 仕組みの要点 | 少なくとも1つの層で畳み込みを使う | ある時点の計算結果を次の時点に引き継ぐ(フィードバックのつながり) | 入力・忘却・出力のゲートで情報の出し入れを調整する(忘却ゲートは1997年の最初のモデルのあとに加わった) | 再帰も畳み込みも使わず、系列の中の関係をAttentionでとらえる |
| 特徴・成果 | 物体認識などのコンピュータビジョンで成果(2012年のImageNetの競技会) | 長い系列で勾配消失・勾配爆発が起きやすい | 勾配が消えも爆発もしない経路を作り、長い期間の情報を保つ | 学習のときに並列に計算しやすく、学習時間が大幅に短い(生成は1トークン(単語や単語の一部など)ずつ順に出す) |
| 身近なたとえ | 虫眼鏡を写真に順に当てて模様を探す | 前の発言を覚えたまま議事録を1文ずつ読む | 何を書く・消す・読み上げるかを決めるメモ帳 | 文全体を見渡して大事な語どうしを結び付ける |
得意なデータ
- CNN
- 画像のような格子状のデータ
- RNN
- 文章・音声のような順番のあるシーケンスデータ
- LSTM
- RNNと同じくシーケンスデータ(長い期間の関係がある系列)
- Transformer
- 文章などの系列(論文では機械翻訳で評価)
仕組みの要点
- CNN
- 少なくとも1つの層で畳み込みを使う
- RNN
- ある時点の計算結果を次の時点に引き継ぐ(フィードバックのつながり)
- LSTM
- 入力・忘却・出力のゲートで情報の出し入れを調整する(忘却ゲートは1997年の最初のモデルのあとに加わった)
- Transformer
- 再帰も畳み込みも使わず、系列の中の関係をAttentionでとらえる
特徴・成果
- CNN
- 物体認識などのコンピュータビジョンで成果(2012年のImageNetの競技会)
- RNN
- 長い系列で勾配消失・勾配爆発が起きやすい
- LSTM
- 勾配が消えも爆発もしない経路を作り、長い期間の情報を保つ
- Transformer
- 学習のときに並列に計算しやすく、学習時間が大幅に短い(生成は1トークン(単語や単語の一部など)ずつ順に出す)
身近なたとえ
- CNN
- 虫眼鏡を写真に順に当てて模様を探す
- RNN
- 前の発言を覚えたまま議事録を1文ずつ読む
- LSTM
- 何を書く・消す・読み上げるかを決めるメモ帳
- Transformer
- 文全体を見渡して大事な語どうしを結び付ける
この論点の用語
用語集をすべて見る →01CNN・RNN・LSTMの重要暗記項目
CNN・RNN・LSTM|CNNが得意なデータ
CNNは、格子状に並んだデータ(画像は2次元のピクセルの格子、時系列は1次元の格子)の処理に特化したニューラルネットワークである。
CNN・RNN・LSTM|畳み込み
CNNという名前は、畳み込みという演算を使うことを表す。CNNは、少なくとも1つの層で、一般の行列の掛け算の代わりに畳み込みを使うニューラルネットワークである。
CNN・RNN・LSTM|CNNの名前の由来
CNNの名前は、畳み込み(convolution)という演算を使うことに由来する。前の時点の結果を次の時点へ引き継ぐ再帰の仕組みを持つのはRNNである。
ひっかけ注意「CNNという名前は、出力を入力側へ戻して同じ計算を繰り返す「再帰」という仕組みを使うことに由来する」は誤り。 「再帰という仕組みに由来する」の部分が違う。CNNの名前は畳み込み(convolution)という演算を使うことから来ている(『Deep Learning』)。前の時点の計算結果を次へ引き継いで繰り返すのは、RNN(再帰型ニューラルネットワーク)の特徴である。CNNは画像を「見る」のが得意、RNNは文章を「順に読む」のが得意、と分けて覚えるとよい。
CNN・RNN・LSTM|コンピュータビジョン
CNNは、画像に写った物体を見分ける物体認識などのコンピュータビジョンで成果を上げ、2012年の画像認識の競技会(ImageNet)での勝利が、ディープラーニングへの商業的な関心を高めるきっかけになった。
CNN・RNN・LSTM|RNNが得意なデータ
RNN(再帰型ニューラルネットワーク)は、文章や音声のように順番のある値の並び(シーケンスデータ)の処理に特化したニューラルネットワークで、長さの違う系列も処理できる。
CNN・RNN・LSTM|RNNとCNNの取り違え
順番のあるデータの処理に特化しているのはRNNで、画像のような格子状のデータの処理に特化しているのはCNNである。
ひっかけ注意「RNNは、文章や音声のような順番のあるデータではなく、画像のような格子状のデータの処理に特化したニューラルネットワークである」は誤り。 CNNとRNNの得意分野を入れ替えている。画像のような格子状のデータが得意なのはCNNで、RNNは文章や音声のような順番のあるデータの処理に特化している(『Deep Learning』)。写真を見分けるのはCNN、話し言葉を順に聞き取るのはRNN、と場面で区別すると覚えやすい。
CNN・RNN・LSTM|前の時点を引き継ぐ
RNNは、出力をモデル自身に戻すフィードバックのつながりを持ち、ある時点の計算結果(隠れ状態)を次の時点の計算に引き継ぐ。
CNN・RNN・LSTM|勾配消失と勾配爆発
RNNで多くの時点(段)にわたって伝わる勾配は、たいていは消えていき(勾配消失)、まれに大きくなりすぎる(勾配爆発)。このため、離れた時点どうしの長期の依存関係を学ぶのが難しい。
覚える数字と、狙われる引っかけ
- ひっかけ「CNNという名前は、出力を入力側へ戻して同じ計算を繰り返す「再帰」という仕組みを使うことに由来する」は誤り。「再帰という仕組みに由来する」の部分が違う。CNNの名前は畳み込み(convolution)という演算を使うことから来ている(『Deep Learning』)。前の時点の計算結果を次へ引き継いで繰り返すのは、RNN(再帰型ニューラルネットワーク)の特徴である。CNNは画像を「見る」のが得意、RNNは文章を「順に読む」のが得意、と分けて覚えるとよい。
- ひっかけ「RNNは、文章や音声のような順番のあるデータではなく、画像のような格子状のデータの処理に特化したニューラルネットワークである」は誤り。CNNとRNNの得意分野を入れ替えている。画像のような格子状のデータが得意なのはCNNで、RNNは文章や音声のような順番のあるデータの処理に特化している(『Deep Learning』)。写真を見分けるのはCNN、話し言葉を順に聞き取るのはRNN、と場面で区別すると覚えやすい。
- ひっかけ「RNNでは、長い系列を学習するほど勾配が安定し、遠く離れた時点どうしの関係をかえって学びやすくなる」は誤り。「かえって学びやすくなる」の部分が違う。『Deep Learning』は、RNNでは多くの段を伝わる勾配が消えたり爆発したりしやすく、遠く離れた時点どうしの関係を学ぶのが難しいとしている。長い文章の冒頭に出た人名と、終わりの方の「彼」を結び付けるような、離れた関係ほど学びにくいというイメージである。
- ひっかけ「勾配消失問題とは、誤差逆伝播で伝わる勾配が大きくなりすぎて、パラメータの更新が大きく飛んでしまう問題である」は誤り。説明しているのは勾配消失問題ではなく勾配爆発問題である。勾配が大きくなりすぎてパラメータの更新が大きく飛んでしまうのが勾配爆発問題で、勾配消失問題は勾配が消えていく(小さくなりすぎる)問題である(『Deep Learning』)。消失は声が小さくなって聞こえない状態、爆発は声が大きくなりすぎて割れてしまう状態、とたとえると区別しやすい。
- ひっかけ「LSTMは、RNNからゲートの仕組みを取り除いて構造を単純にすることで、長い期間の依存関係を学びやすくした」は誤り。「ゲートの仕組みを取り除いて」の部分が違う。LSTMは、RNNにゲート(情報の出し入れを決める門)の仕組みを加えたモデルである(『Deep Learning』)。ゲートで覚える・忘れる・出すを調整し、勾配が消えにくい経路を作ることで、長い期間の関係を学べるようにした。単純にしたのではなく、記憶の管理役を足したのである。
- ひっかけ「Transformerは、RNNの再帰の仕組みを土台にして、その上にAttentionの仕組みを加えたモデルである」は誤り。「RNNの再帰の仕組みを土台にして」の部分が違う。Transformerの論文(Vaswani ら、2017年)は、Transformerを、再帰と畳み込みを完全に使わず、Attention(注目すべき語を計算する仕組み)で系列の中の関係をとらえるモデルとしている。1語ずつ順に読むRNNの読み方をやめたことで、学習のときに並列に計算しやすくなった。
02試験で正誤を分けるチェック順
- 1CNNは、格子状に並んだデータ(画像は2次元のピクセルの格子、時系列は1次元の格子)の処理に特化したニューラルネットワークである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2CNNという名前は、畳み込みという演算を使うことを表す。CNNは、少なくとも1つの層で、一般の行列の掛け算の代わりに畳み込みを使うニューラルネットワークである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3CNNの名前は、畳み込み(convolution)という演算を使うことに由来する。前の時点の結果を次の時点へ引き継ぐ再帰の仕組みを持つのはRNNである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4CNNは、画像に写った物体を見分ける物体認識などのコンピュータビジョンで成果を上げ、2012年の画像認識の競技会(ImageNet)での勝利が、ディープラーニングへの商業的な関心を高めるきっかけになった。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5RNN(再帰型ニューラルネットワーク)は、文章や音声のように順番のある値の並び(シーケンスデータ)の処理に特化したニューラルネットワークで、長さの違う系列も処理できる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6順番のあるデータの処理に特化しているのはRNNで、画像のような格子状のデータの処理に特化しているのはCNNである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7RNNは、出力をモデル自身に戻すフィードバックのつながりを持ち、ある時点の計算結果(隠れ状態)を次の時点の計算に引き継ぐ。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8RNNで多くの時点(段)にわたって伝わる勾配は、たいていは消えていき(勾配消失)、まれに大きくなりすぎる(勾配爆発)。このため、離れた時点どうしの長期の依存関係を学ぶのが難しい。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9RNNでは、長い系列ほど勾配が消えたり爆発したりしやすく、離れた時点どうしの関係を学ぶのが難しい。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10勾配消失問題は、多くの段を逆向きに伝わる勾配が消えていく(小さくなりすぎる)問題で、勾配が大きくなりすぎてパラメータの更新が大きく飛んでしまうのは勾配爆発問題である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11LSTMは、RNNで長い期間の関係を学ぶのが難しい(勾配が消えやすい)問題に対し、勾配が長い期間流れ続ける経路を作る工夫を取り入れたモデルで、最初のLSTMは1997年に Hochreiter と Schmidhuber が発表した。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12代表的なLSTMは、入力ゲート・忘却ゲート・出力ゲートで、情報を状態に入れるか、古い状態を忘れるか、外に出すかを調整し、勾配が消えたり爆発したりしにくい経路を作る。忘却ゲートにあたる仕組みは、1997年の最初のLSTMのあとに加わった。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13LSTMは、RNNにゲートの仕組みを加えて、長い期間の依存関係を学びやすくしたモデルである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14Transformerは、再帰(RNN)も畳み込み(CNN)も使わず、系列の中の語どうしの関係をAttention(注意機構)でとらえるモデルで、学習のときに並列に計算しやすく、学習にかかる時間が大幅に短い(2017年の論文)。文を生成するときは1トークン(単語や単語の一部など)ずつ順に出す。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 15Transformerは、再帰と畳み込みを完全に使わず、系列の中の関係をとらえるのにAttentionの仕組みを使うモデルである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
CNN・RNN・LSTMの○×一問一答
1/8問解答 0・正解 0
AIの基礎と歴史
CNN・RNN・LSTM|CNNが得意なデータ
CNNは、画像のように格子状に並んだデータの処理に特化したニューラルネットワークである。
CNN・RNN・LSTMの○×一問一答15問|問題と解説
この論点で収録している15問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
CNN・RNN・LSTM|CNNが得意なデータCNNは、画像のように格子状に並んだデータの処理に特化したニューラルネットワークである。
答え:○(正しい)
解説
正しい。『Deep Learning』は、CNN(畳み込みニューラルネットワーク)を格子状のデータの処理に特化したネットワークとし、ピクセルが縦横に並んだ画像や、一定の間隔で並ぶ時系列を例に挙げている。画像はマス目に色の値が並んだものなので、方眼紙に描いた絵をマスごとに読み取るような処理が得意である。 要点:CNNは、格子状に並んだデータ(画像は2次元のピクセルの格子、時系列は1次元の格子)の処理に特化したニューラルネットワークである。
問2
CNN・RNN・LSTM|畳み込みCNNは、少なくとも1つの層で、一般の行列の掛け算の代わりに畳み込みという演算を使うニューラルネットワークである。
答え:○(正しい)
解説
正しい。『Deep Learning』は、CNNは少なくとも1つの層で畳み込みという演算を使うネットワークだとしている。畳み込みは、小さな窓を画像の上で少しずつずらしながら、窓の中の模様を読み取っていくような計算である。虫眼鏡を写真の端から順に当て、線や角などの模様を探していく作業にたとえられる。 要点:CNNという名前は、畳み込みという演算を使うことを表す。CNNは、少なくとも1つの層で、一般の行列の掛け算の代わりに畳み込みを使うニューラルネットワークである。
問3
CNN・RNN・LSTM|CNNの名前の由来CNNという名前は、出力を入力側へ戻して同じ計算を繰り返す「再帰」という仕組みを使うことに由来する。
答え:×(誤り)
解説
誤り。誤りは「再帰という仕組みに由来する」の部分。CNNの名前は畳み込み(convolution)という演算を使うことから来ている(『Deep Learning』)。前の時点の計算結果を次へ引き継いで繰り返すのは、RNN(再帰型ニューラルネットワーク)の特徴である。CNNは画像を「見る」のが得意、RNNは文章を「順に読む」のが得意、と分けて覚えるとよい。 要点:CNNの名前は、畳み込み(convolution)という演算を使うことに由来する。前の時点の結果を次の時点へ引き継ぐ再帰の仕組みを持つのはRNNである。
問4
CNN・RNN・LSTM|コンピュータビジョンCNNは、画像に写った物体を見分ける物体認識など、コンピュータビジョンの分野で大きな成果を上げてきた。
答え:○(正しい)
解説
正しい。『Deep Learning』は、CNNは実用で大きな成功を収め、コンピュータビジョン(コンピューターに画像や映像を理解させる分野)の競技会で使われてきたとし、2012年のImageNetの物体認識の競技会での勝利がディープラーニングへの商業的な関心を高めたとしている。写真に写った物が何かを当てる画像認識が、この分野の代表的な仕事である。 要点:CNNは、画像に写った物体を見分ける物体認識などのコンピュータビジョンで成果を上げ、2012年の画像認識の競技会(ImageNet)での勝利が、ディープラーニングへの商業的な関心を高めるきっかけになった。
問5
CNN・RNN・LSTM|RNNが得意なデータRNNは、文章や音声のように順番のある値の並び(シーケンスデータ)の処理に特化したニューラルネットワークである。
答え:○(正しい)
解説
正しい。『Deep Learning』は、RNN(再帰型ニューラルネットワーク)を、順番のある値の並び(シーケンスデータ)を処理するネットワークとし、多くは長さの違う並びも扱えるとしている。シーケンスデータとは、文章の単語の並びや音声のように、順番に意味があるデータである。「犬が人をかむ」と「人が犬をかむ」のように、並び順で意味が変わるデータを扱うのに向く。 要点:RNN(再帰型ニューラルネットワーク)は、文章や音声のように順番のある値の並び(シーケンスデータ)の処理に特化したニューラルネットワークで、長さの違う系列も処理できる。
問6
CNN・RNN・LSTM|RNNとCNNの取り違えRNNは、文章や音声のような順番のあるデータではなく、画像のような格子状のデータの処理に特化したニューラルネットワークである。
答え:×(誤り)
解説
誤り。CNNとRNNの得意分野を入れ替えている。画像のような格子状のデータが得意なのはCNNで、RNNは文章や音声のような順番のあるデータの処理に特化している(『Deep Learning』)。写真を見分けるのはCNN、話し言葉を順に聞き取るのはRNN、と場面で区別すると覚えやすい。 要点:順番のあるデータの処理に特化しているのはRNNで、画像のような格子状のデータの処理に特化しているのはCNNである。
問7
CNN・RNN・LSTM|前の時点を引き継ぐRNNは、ある時点の計算結果を次の時点の計算に引き継ぐ、フィードバックのつながりを持つニューラルネットワークである。
答え:○(正しい)
解説
正しい。『Deep Learning』は、順伝播型のネットワークにフィードバック(結果を自分に戻すこと)のつながりを加えたものをRNNと呼ぶとしている。前の時点の計算結果を次の時点に引き継ぐので、それまでの流れを踏まえて次を処理できる。会議の議事録を、前の発言の内容を覚えたまま1文ずつ読み進めていくのに似ている。 要点:RNNは、出力をモデル自身に戻すフィードバックのつながりを持ち、ある時点の計算結果(隠れ状態)を次の時点の計算に引き継ぐ。
問8
CNN・RNN・LSTM|勾配消失と勾配爆発RNNでは、多くの時点にわたって伝わる勾配が小さくなりすぎたり大きくなりすぎたりしやすく、離れた時点どうしの関係を学ぶのが難しい。
答え:○(正しい)
解説
正しい。『Deep Learning』は、RNNで多くの段をさかのぼって伝わる勾配(学習の手がかりとなる傾き)は、たいてい消えていき(勾配消失)、まれに大きくなりすぎる(勾配爆発)ため、離れた時点どうしの関係を学ぶのが難しいとしている。長い伝言ゲームで、最初の言葉ほど薄れて正しく伝わらなくなるのに似ている。 要点:RNNで多くの時点(段)にわたって伝わる勾配は、たいていは消えていき(勾配消失)、まれに大きくなりすぎる(勾配爆発)。このため、離れた時点どうしの長期の依存関係を学ぶのが難しい。
問9
CNN・RNN・LSTM|長い系列ほど難しいRNNでは、長い系列を学習するほど勾配が安定し、遠く離れた時点どうしの関係をかえって学びやすくなる。
答え:×(誤り)
解説
誤り。誤りは「かえって学びやすくなる」の部分。『Deep Learning』は、RNNでは多くの段を伝わる勾配が消えたり爆発したりしやすく、遠く離れた時点どうしの関係を学ぶのが難しいとしている。長い文章の冒頭に出た人名と、終わりの方の「彼」を結び付けるような、離れた関係ほど学びにくいというイメージである。 要点:RNNでは、長い系列ほど勾配が消えたり爆発したりしやすく、離れた時点どうしの関係を学ぶのが難しい。
問10
CNN・RNN・LSTM|勾配消失と爆発の区別勾配消失問題とは、誤差逆伝播で伝わる勾配が大きくなりすぎて、パラメータの更新が大きく飛んでしまう問題である。
答え:×(誤り)
解説
誤り。説明しているのは勾配消失問題ではなく勾配爆発問題である。勾配が大きくなりすぎてパラメータの更新が大きく飛んでしまうのが勾配爆発問題で、勾配消失問題は勾配が消えていく(小さくなりすぎる)問題である(『Deep Learning』)。消失は声が小さくなって聞こえない状態、爆発は声が大きくなりすぎて割れてしまう状態、とたとえると区別しやすい。 要点:勾配消失問題は、多くの段を逆向きに伝わる勾配が消えていく(小さくなりすぎる)問題で、勾配が大きくなりすぎてパラメータの更新が大きく飛んでしまうのは勾配爆発問題である。
問11
CNN・RNN・LSTM|LSTMの登場LSTMは、RNNが長い期間にわたる情報を学びにくいという問題に対処するために提案され、1997年に論文として発表された。
答え:○(正しい)
解説
正しい。『Deep Learning』は、勾配が長い期間流れ続ける経路を作る工夫を、1997年に Hochreiter と Schmidhuber が発表した最初のLSTM(Long Short-Term Memory)の中心の貢献とし、LSTMは単純なRNNより長い期間の関係を学びやすいことが示されてきたとしている。長いやり取りの中でも、大事な前提を忘れずに覚えておけるように工夫したRNNと考えるとよい。 要点:LSTMは、RNNで長い期間の関係を学ぶのが難しい(勾配が消えやすい)問題に対し、勾配が長い期間流れ続ける経路を作る工夫を取り入れたモデルで、最初のLSTMは1997年に Hochreiter と Schmidhuber が発表した。
問12
CNN・RNN・LSTM|ゲートの働き代表的なLSTMは、入力ゲート・忘却ゲート・出力ゲートで、情報を取り込むか、忘れるか、出力するかを調整する。
答え:○(正しい)
解説
正しい。『Deep Learning』は、LSTMを入力ゲート・忘却ゲート・出力ゲートを持つ図で示し、ゲートで情報の流れを時点ごとに調整するとしている。ゲートは情報の出し入れを決める門のようなものである。メモ帳にたとえると、何を書き込むか(入力)、何を消すか(忘却)、何を読み上げるか(出力)をその都度決めている。なお忘却ゲートにあたる仕組みは、1997年の最初のLSTMのあとに加えられた。 要点:代表的なLSTMは、入力ゲート・忘却ゲート・出力ゲートで、情報を状態に入れるか、古い状態を忘れるか、外に出すかを調整し、勾配が消えたり爆発したりしにくい経路を作る。忘却ゲートにあたる仕組みは、1997年の最初のLSTMのあとに加わった。
問13
CNN・RNN・LSTM|ゲートを加えたLSTMは、RNNからゲートの仕組みを取り除いて構造を単純にすることで、長い期間の依存関係を学びやすくした。
答え:×(誤り)
解説
誤り。誤りは「ゲートの仕組みを取り除いて」の部分。LSTMは、RNNにゲート(情報の出し入れを決める門)の仕組みを加えたモデルである(『Deep Learning』)。ゲートで覚える・忘れる・出すを調整し、勾配が消えにくい経路を作ることで、長い期間の関係を学べるようにした。単純にしたのではなく、記憶の管理役を足したのである。 要点:LSTMは、RNNにゲートの仕組みを加えて、長い期間の依存関係を学びやすくしたモデルである。
問14
CNN・RNN・LSTM|TransformerTransformerは、再帰も畳み込みも使わずに、系列の中の関係をAttentionの仕組みでとらえるモデルで、学習のときに並列に計算しやすい。
答え:○(正しい)
解説
正しい。Transformerの論文(Vaswani ら、2017年)は、Transformerは再帰も畳み込みも使わずAttention(注意機構)の仕組みにもとづき、並列に計算しやすく学習時間も短いとしている(生成するときは、前に出した部分を使って1トークン(単語や単語の一部など)ずつ出す)。Attentionは、文の中のどの語に注目すべきかを計算する仕組みである。文を1語ずつ順に読むのではなく、全体を見渡して大事な語どうしを結び付ける読み方にたとえられる。 要点:Transformerは、再帰(RNN)も畳み込み(CNN)も使わず、系列の中の語どうしの関係をAttention(注意機構)でとらえるモデルで、学習のときに並列に計算しやすく、学習にかかる時間が大幅に短い(2017年の論文)。文を生成するときは1トークン(単語や単語の一部など)ずつ順に出す。
問15
CNN・RNN・LSTM|再帰は使わないTransformerは、RNNの再帰の仕組みを土台にして、その上にAttentionの仕組みを加えたモデルである。
答え:×(誤り)
解説
誤り。誤りは「RNNの再帰の仕組みを土台にして」の部分。Transformerの論文(Vaswani ら、2017年)は、Transformerを、再帰と畳み込みを完全に使わず、Attention(注目すべき語を計算する仕組み)で系列の中の関係をとらえるモデルとしている。1語ずつ順に読むRNNの読み方をやめたことで、学習のときに並列に計算しやすくなった。 要点:Transformerは、再帰と畳み込みを完全に使わず、系列の中の関係をとらえるのにAttentionの仕組みを使うモデルである。
CNN・RNN・LSTMの問題を続けて解く
この論点に対応する15問を絞り込んで出題します。