AIの基礎と歴史
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理
教師なし学習は正解のないデータから構造を見つける方法(似たものをまとめるクラスタリング、次元を減らす次元削減)、強化学習は環境とのやり取りで試行錯誤しながら報酬の合計を最大にする行動の選び方(方策)を学ぶ方法で、行動は目先の報酬ではなく長い目で見た価値で選びます。半教師あり学習は正解付きの少ないデータと正解なしの大量のデータを合わせて使い、ノーフリーランチ定理はどんな課題にも最も良い万能のアルゴリズムはないことを示す、を押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
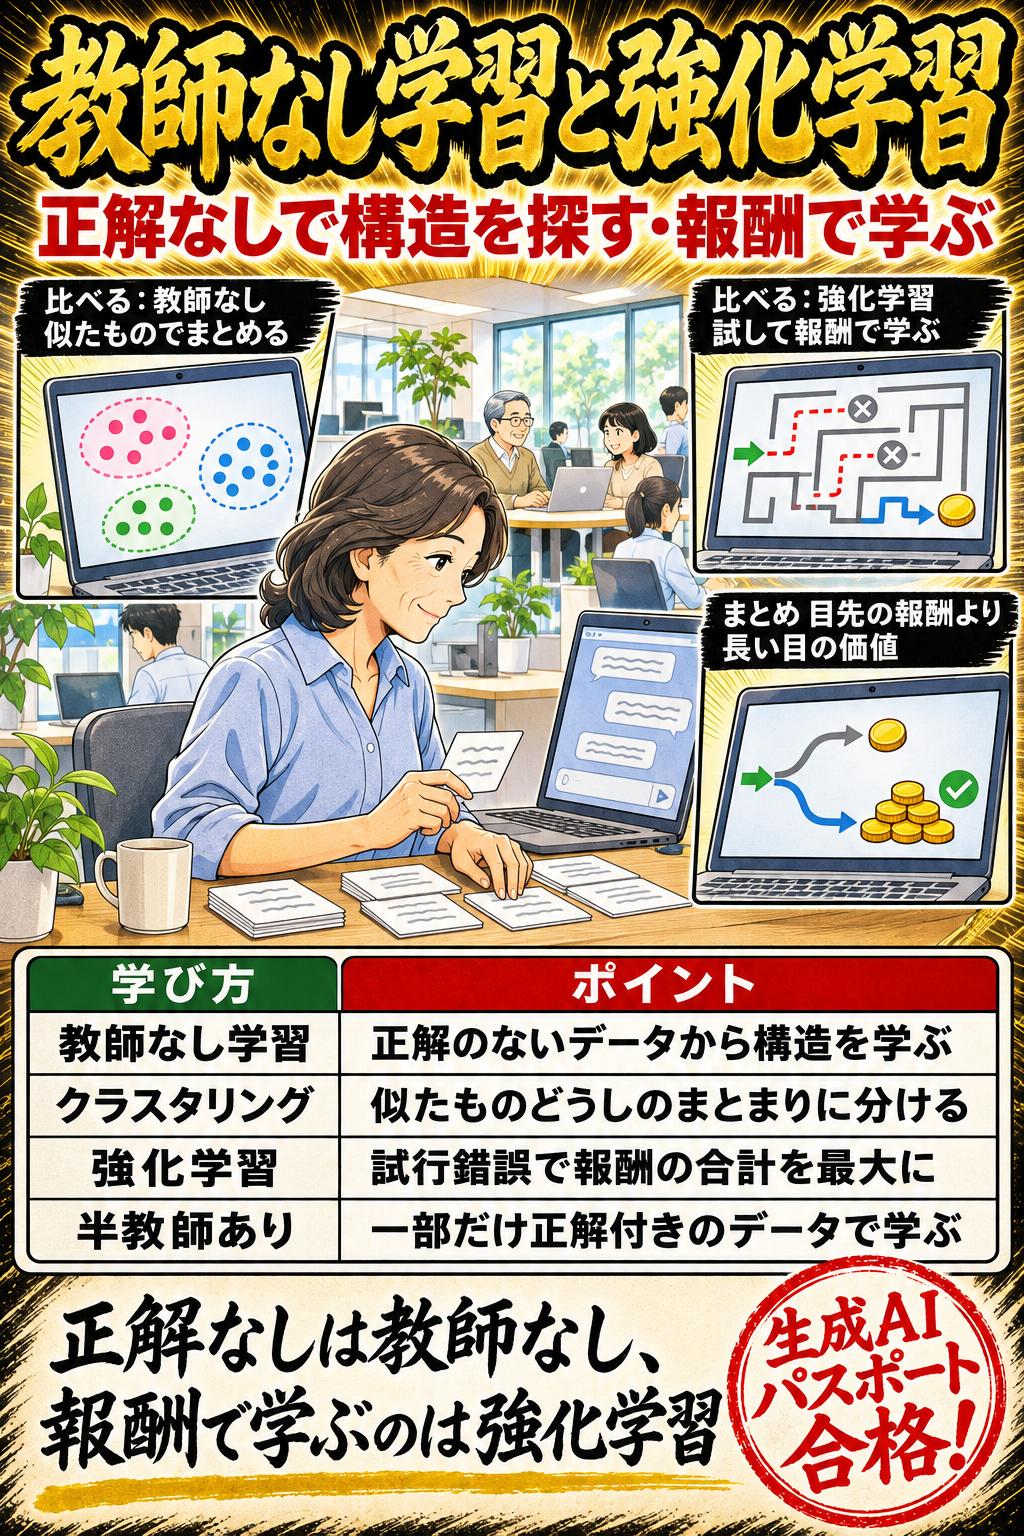
教師なし学習は正解のないデータから構造を見つける方法(似たものをまとめるクラスタリング、次元を減らす次元削減)、強化学習は環境とのやり取りで試行錯誤しながら報酬の合計を最大にする行動の選び方(方策)を学ぶ方法で、行動は目先の報酬ではなく長い目で見た価値で選びます。半教師あり学習は正解付きの少ないデータと正解なしの大量のデータを合わせて使い、ノーフリーランチ定理はどんな課題にも最も良い万能のアルゴリズムはないことを示す、を押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 15問
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|教師なし学習
教師なし学習は、正解(ラベル)の付いていないデータから、データの構造の有用な性質を学ぶ。
比較して覚える
機械学習の4つの学び方:教師あり・教師なし・強化・半教師あり
教師あり学習・教師なし学習・強化学習・半教師あり学習を、使うデータと学ぶことで並べます。正解ラベルの有無と、報酬から学ぶ強化学習を取り違える肢を切り分けられます。
| 事由 | 教師あり学習 | 教師なし学習 | 強化学習 | 半教師あり学習 |
|---|---|---|---|---|
| 使うデータ | 正解(ラベル)付きの教師データ | 正解の付いていないデータ | 決まったデータではなく、環境とのやり取りで得る経験と報酬 | 正解付きの少量のデータと、正解の付いていない大量のデータ |
| 学ぶこと | 入力から正解を予測すること | データに隠れた構造や性質 | 報酬の合計を最大にする行動の選び方(方策) | 正解のないデータからも学び、正解付きのデータの課題を解く |
| 代表的な課題・手法 | 分類(二値分類・多値分類)、回帰 | クラスタリング、次元削減(主成分分析) | 報酬・価値・方策を使って試行錯誤する | 正解のないデータで良い表し方を学び、正解付きのデータの課題に使う |
| 正解の行動・答えは教えられるか | 教えられる(ラベル) | 教えられない | 教えられない(試して報酬の多い行動を見つける) | 一部のデータだけ教えられる |
| 身近なたとえ | 答え付きの問題集で練習する | 答えのない資料から共通点を見つける | 自転車に何度も乗って転ばないコツをつかむ | 一部だけ答えの付いた問題集で練習する |
使うデータ
- 教師あり学習
- 正解(ラベル)付きの教師データ
- 教師なし学習
- 正解の付いていないデータ
- 強化学習
- 決まったデータではなく、環境とのやり取りで得る経験と報酬
- 半教師あり学習
- 正解付きの少量のデータと、正解の付いていない大量のデータ
学ぶこと
- 教師あり学習
- 入力から正解を予測すること
- 教師なし学習
- データに隠れた構造や性質
- 強化学習
- 報酬の合計を最大にする行動の選び方(方策)
- 半教師あり学習
- 正解のないデータからも学び、正解付きのデータの課題を解く
代表的な課題・手法
- 教師あり学習
- 分類(二値分類・多値分類)、回帰
- 教師なし学習
- クラスタリング、次元削減(主成分分析)
- 強化学習
- 報酬・価値・方策を使って試行錯誤する
- 半教師あり学習
- 正解のないデータで良い表し方を学び、正解付きのデータの課題に使う
正解の行動・答えは教えられるか
- 教師あり学習
- 教えられる(ラベル)
- 教師なし学習
- 教えられない
- 強化学習
- 教えられない(試して報酬の多い行動を見つける)
- 半教師あり学習
- 一部のデータだけ教えられる
身近なたとえ
- 教師あり学習
- 答え付きの問題集で練習する
- 教師なし学習
- 答えのない資料から共通点を見つける
- 強化学習
- 自転車に何度も乗って転ばないコツをつかむ
- 半教師あり学習
- 一部だけ答えの付いた問題集で練習する
比較して覚える
強化学習の報酬・価値・方策
強化学習の3つの用語を、何を表すか・時間の見方で並べます。目先の良さを表す報酬と、長い目で見た良さを表す価値を取り違える肢を切り分けられます。
| 事由 | 報酬 | 価値 | 方策 |
|---|---|---|---|
| 何を表すか | 各時点で環境からエージェントに送られる1つの数値 | ある状態から先に得られると見込める報酬の合計 | 認識した状態から取る行動への対応(振る舞い方) |
| 時間の見方 | その場で何が良いか | 長い目で見て何が良いか | ある時点での振る舞い方 |
| 役割 | 強化学習の問題の目的を定める。方策を変える主な根拠 | 行動を選ぶ判断に使う(報酬でなく価値が最も大きい状態を目指す) | エージェントの中心。方策だけで振る舞いが決まる |
| 決まり方 | 環境から直接与えられる | 経験から見積もり、見積もり直す必要がある | 報酬が低ければ、別の行動を選ぶように変えられる |
| 身近なたとえ | ゲームの加点・減点 | 資格の勉強(その日は楽しくなくても、先々の得が大きい) | 「信号が黄色ならブレーキ」という判断の仕方 |
何を表すか
- 報酬
- 各時点で環境からエージェントに送られる1つの数値
- 価値
- ある状態から先に得られると見込める報酬の合計
- 方策
- 認識した状態から取る行動への対応(振る舞い方)
時間の見方
- 報酬
- その場で何が良いか
- 価値
- 長い目で見て何が良いか
- 方策
- ある時点での振る舞い方
役割
- 報酬
- 強化学習の問題の目的を定める。方策を変える主な根拠
- 価値
- 行動を選ぶ判断に使う(報酬でなく価値が最も大きい状態を目指す)
- 方策
- エージェントの中心。方策だけで振る舞いが決まる
決まり方
- 報酬
- 環境から直接与えられる
- 価値
- 経験から見積もり、見積もり直す必要がある
- 方策
- 報酬が低ければ、別の行動を選ぶように変えられる
身近なたとえ
- 報酬
- ゲームの加点・減点
- 価値
- 資格の勉強(その日は楽しくなくても、先々の得が大きい)
- 方策
- 「信号が黄色ならブレーキ」という判断の仕方
この論点の用語
用語集をすべて見る →01教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理の重要暗記項目
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|教師なし学習
教師なし学習は、正解(ラベル)の付いていないデータから、データの構造の有用な性質を学ぶ。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|クラスタリング
クラスタリングは、データを似たものどうしのまとまり(クラスタ)に分ける教師なし学習の手法で、k平均法(k-means)はデータを互いに近いk個のまとまりに分ける。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|クラスタリングに正解は不要
クラスタリングは、正解の付いていないデータを似たものどうしのまとまりに分ける教師なし学習の手法である。
ひっかけ注意「似たデータどうしをまとまりに分けるクラスタリングは、正解のラベルを付けたデータを必要とする教師あり学習の手法である」は誤り。 「正解のラベルを付けたデータを必要とする教師あり学習」の部分が違う。クラスタリングは、正解の付いていないデータを似たものどうしに分ける教師なし学習の手法である(『Deep Learning』)。名前の似た「分類」は、正解付きのデータで学ぶ教師あり学習である。答えの決まっていない名刺の山を、似た業種ごとに分けていくのがクラスタリングと考えるとよい。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|次元削減
次元削減は、データの情報をできるだけ保ちながら、元のデータより少ない次元(項目の数)で表す方法で、主成分分析(PCA)はその代表である。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|次元を増やすのではない
次元削減は、元のデータより少ない次元(項目の数)でデータを表す方法である。
ひっかけ注意「次元削減は、データを表す項目の数を元のデータより増やして、情報をより細かく表す方法である」は誤り。 「項目の数を増やして」の部分が違う。次元削減は、データを表す項目(次元)の数を元より減らしながら、情報をできるだけ保つ方法である(『Deep Learning』の主成分分析の説明)。たとえば、細かい質問が並ぶアンケートの結果を、少数の大きな傾向にまとめて読みやすくするのが次元削減の考え方である。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|強化学習
強化学習は、どの行動を取るべきかを教えられず、試すことで最も多くの報酬をもたらす行動を見つけ、数値の報酬を最大にするように状況から行動への対応を学ぶ(試行錯誤と、遅れて得られる報酬が特徴)。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|正解の行動は与えられない
強化学習では、取るべき行動は正解として教えられず、エージェントが試行錯誤で報酬の多い行動を見つける。
ひっかけ注意「強化学習では、場面ごとに取るべき正しい行動が正解のラベルとして与えられ、それを手本にして学ぶ」は誤り。 「正しい行動が正解のラベルとして与えられ」の部分が違う。Sutton と Barto は、強化学習では取るべき行動は教えられず、試して報酬の多い行動を見つけるとしている。正解付きの例から学ぶのは教師あり学習である。ゲームで、一手ごとに正解を教わるのではなく、勝ち負けの結果から良い打ち方を覚えていくのが強化学習の学び方である。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|報酬
報酬は、各時点で環境から強化学習のエージェントに送られる1つの数値で、エージェントの目的は長い期間に受け取る報酬の合計を最大にすることである。
覚える数字と、狙われる引っかけ
- ひっかけ「似たデータどうしをまとまりに分けるクラスタリングは、正解のラベルを付けたデータを必要とする教師あり学習の手法である」は誤り。「正解のラベルを付けたデータを必要とする教師あり学習」の部分が違う。クラスタリングは、正解の付いていないデータを似たものどうしに分ける教師なし学習の手法である(『Deep Learning』)。名前の似た「分類」は、正解付きのデータで学ぶ教師あり学習である。答えの決まっていない名刺の山を、似た業種ごとに分けていくのがクラスタリングと考えるとよい。
- ひっかけ「次元削減は、データを表す項目の数を元のデータより増やして、情報をより細かく表す方法である」は誤り。「項目の数を増やして」の部分が違う。次元削減は、データを表す項目(次元)の数を元より減らしながら、情報をできるだけ保つ方法である(『Deep Learning』の主成分分析の説明)。たとえば、細かい質問が並ぶアンケートの結果を、少数の大きな傾向にまとめて読みやすくするのが次元削減の考え方である。
- ひっかけ「強化学習では、場面ごとに取るべき正しい行動が正解のラベルとして与えられ、それを手本にして学ぶ」は誤り。「正しい行動が正解のラベルとして与えられ」の部分が違う。Sutton と Barto は、強化学習では取るべき行動は教えられず、試して報酬の多い行動を見つけるとしている。正解付きの例から学ぶのは教師あり学習である。ゲームで、一手ごとに正解を教わるのではなく、勝ち負けの結果から良い打ち方を覚えていくのが強化学習の学び方である。
- ひっかけ「強化学習のエージェントは、その場ですぐ得られる報酬が最も大きい行動を選ぶように学ぶ」は誤り。「その場ですぐ得られる報酬が最も大きい行動」の部分が違う。Sutton と Barto は、行動は報酬ではなく価値(長い目で見た良さ)が最も大きい状態をもたらすものを選ぶとしている。目先の値引きにつられて品を選ぶより、長く使えて結局得をする品を選ぶのと同じで、目先の点数より先々の合計を重んじる。
- ひっかけ「半教師あり学習は、すべてのデータに正解(ラベル)が付いていることを前提とする学習方法である」は誤り。「すべてのデータに正解が付いている」の部分が違う。半教師あり学習は、一部のデータにだけ正解(ラベル)があり、残りにはない状況で両方を使う方法である(『Deep Learning』)。正解を付ける作業は手間がかかるため、少しだけ正解を付け、残りは正解なしのまま活用したいときに役立つ。
- ひっかけ「ノーフリーランチ定理は、どんな課題にも最も高い性能を出す万能の学習アルゴリズムが存在することを示している」は誤り。示している内容が逆である。ノーフリーランチ定理は、すべての課題で平均すればどのアルゴリズムも同じ性能になり、万能のものはないことを示す。『Deep Learning』は、研究の目的は万能のアルゴリズム探しではなく、課題に合うものを作ることだとしている。何にでも一番の道具はなく、仕事に合った道具を選ぶ、という考え方である。
02試験で正誤を分けるチェック順
- 1教師なし学習は、正解(ラベル)の付いていないデータから、データの構造の有用な性質を学ぶ。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2クラスタリングは、データを似たものどうしのまとまり(クラスタ)に分ける教師なし学習の手法で、k平均法(k-means)はデータを互いに近いk個のまとまりに分ける。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3クラスタリングは、正解の付いていないデータを似たものどうしのまとまりに分ける教師なし学習の手法である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4次元削減は、データの情報をできるだけ保ちながら、元のデータより少ない次元(項目の数)で表す方法で、主成分分析(PCA)はその代表である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5次元削減は、元のデータより少ない次元(項目の数)でデータを表す方法である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6強化学習は、どの行動を取るべきかを教えられず、試すことで最も多くの報酬をもたらす行動を見つけ、数値の報酬を最大にするように状況から行動への対応を学ぶ(試行錯誤と、遅れて得られる報酬が特徴)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7強化学習では、取るべき行動は正解として教えられず、エージェントが試行錯誤で報酬の多い行動を見つける。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8報酬は、各時点で環境から強化学習のエージェントに送られる1つの数値で、エージェントの目的は長い期間に受け取る報酬の合計を最大にすることである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9報酬がその場で何が良いかを示すのに対し、価値(価値関数)は長い目で見て何が良いかを示し、ある状態の価値はそこから先に得られると見込める報酬の合計である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10強化学習では、目先の報酬が最も大きい状態ではなく、価値が最も大きい状態をもたらす行動を選ぶ。長い目で見て最も多くの報酬が得られるからである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11方策は、ある時点での学習するエージェントの振る舞い方で、おおまかには、認識した環境の状態から、その状態で取る行動への対応である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12半教師あり学習は、一部のデータには正解(ラベル)があり、ほかのデータにはないときに、正解のないデータからも学ぶ方法で、正解付きのデータが少ないときの過学習を和らげる手立てになる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13半教師あり学習は、一部のデータにだけ正解(ラベル)があり、ほかのデータにはない状況で、両方を使って学ぶ方法である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14ノーフリーランチ定理は、ありうるすべてのデータの生まれ方について平均すると、どの分類アルゴリズムも未知の点を分類するときの誤り率は同じになり、どんな課題にも優れた万能のアルゴリズムはないことを示す。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 15ノーフリーランチ定理から、機械学習では万能のアルゴリズムを探すのではなく、取り組む課題に合わせてうまく働くアルゴリズムを選び、設計する必要がある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理の○×一問一答
1/8問解答 0・正解 0
AIの基礎と歴史
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|教師なし学習
教師なし学習は、正解の付いていないデータを使い、データの中に隠れた構造や性質を学ぶ方法である。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理の○×一問一答15問|問題と解説
この論点で収録している15問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|教師なし学習教師なし学習は、正解の付いていないデータを使い、データの中に隠れた構造や性質を学ぶ方法である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、教師なし学習は正解のないデータから、そのデータの構造の役立つ性質を学ぶとし、Sutton と Barto の強化学習の教科書も、正解のないデータに隠れた構造を見つけることとしている。たとえば、答えの付いていない大量のアンケートの回答から、似た意見のまとまりを見つけさせるのが教師なし学習である。 要点:教師なし学習は、正解(ラベル)の付いていないデータから、データの構造の有用な性質を学ぶ。
問2
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|クラスタリングクラスタリングは、データの集まりを似たものどうしのまとまりに分ける、教師なし学習の手法である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、クラスタリングを、データを似た例のまとまり(クラスタ)に分けることとし、k平均法(データを互いに近いk個のまとまりに分ける方法)を例に挙げている。たとえば、購買の履歴から「週末にまとめ買いする人」「平日に少しずつ買う人」のような、似た買い方をするお客様のまとまりを見つけるのがクラスタリングのイメージである。 要点:クラスタリングは、データを似たものどうしのまとまり(クラスタ)に分ける教師なし学習の手法で、k平均法(k-means)はデータを互いに近いk個のまとまりに分ける。
問3
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|クラスタリングに正解は不要似たデータどうしをまとまりに分けるクラスタリングは、正解のラベルを付けたデータを必要とする教師あり学習の手法である。
答え:×(誤り)
解説
誤り。誤りは「正解のラベルを付けたデータを必要とする教師あり学習」の部分。クラスタリングは、正解の付いていないデータを似たものどうしに分ける教師なし学習の手法である(『Deep Learning』)。名前の似た「分類」は、正解付きのデータで学ぶ教師あり学習である。答えの決まっていない名刺の山を、似た業種ごとに分けていくのがクラスタリングと考えるとよい。 要点:クラスタリングは、正解の付いていないデータを似たものどうしのまとまりに分ける教師なし学習の手法である。
問4
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|次元削減次元削減は、データの情報をできるだけ保ちながら、元のデータより少ない数の項目で表す方法で、主成分分析(PCA)はその例である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、主成分分析(PCA)を、元より次元の低い表現を学ぶ教師なし学習とし、情報をできるだけ保つ次元削減の方法としている。次元とはデータを表す項目の数のことである。たとえば、社員の評価の20項目を少数の大きな軸にまとめ、全体の傾向をつかみやすくするイメージである。 要点:次元削減は、データの情報をできるだけ保ちながら、元のデータより少ない次元(項目の数)で表す方法で、主成分分析(PCA)はその代表である。
問5
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|次元を増やすのではない次元削減は、データを表す項目の数を元のデータより増やして、情報をより細かく表す方法である。
答え:×(誤り)
解説
誤り。誤りは「項目の数を増やして」の部分。次元削減は、データを表す項目(次元)の数を元より減らしながら、情報をできるだけ保つ方法である(『Deep Learning』の主成分分析の説明)。たとえば、細かい質問が並ぶアンケートの結果を、少数の大きな傾向にまとめて読みやすくするのが次元削減の考え方である。 要点:次元削減は、元のデータより少ない次元(項目の数)でデータを表す方法である。
問6
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|強化学習強化学習では、取るべき行動を教えられないまま、さまざまな行動を試し、報酬が最も多くなる行動を見つけ出すように学ぶ。
答え:○(正しい)
解説
正しい。Sutton と Barto は、強化学習を、数値の報酬を最大にするように状況から行動への対応を学ぶこととし、取るべき行動は教えられず試して見つけるとしている。試行錯誤と、報酬が後から届くことが特徴である。自転車の乗り方を、教わるより何度も試して、転ばないコツを自分でつかむのに近い。 要点:強化学習は、どの行動を取るべきかを教えられず、試すことで最も多くの報酬をもたらす行動を見つけ、数値の報酬を最大にするように状況から行動への対応を学ぶ(試行錯誤と、遅れて得られる報酬が特徴)。
問7
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|正解の行動は与えられない強化学習では、場面ごとに取るべき正しい行動が正解のラベルとして与えられ、それを手本にして学ぶ。
答え:×(誤り)
解説
誤り。誤りは「正しい行動が正解のラベルとして与えられ」の部分。Sutton と Barto は、強化学習では取るべき行動は教えられず、試して報酬の多い行動を見つけるとしている。正解付きの例から学ぶのは教師あり学習である。ゲームで、一手ごとに正解を教わるのではなく、勝ち負けの結果から良い打ち方を覚えていくのが強化学習の学び方である。 要点:強化学習では、取るべき行動は正解として教えられず、エージェントが試行錯誤で報酬の多い行動を見つける。
問8
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|報酬強化学習の報酬は、各時点で環境からエージェントに送られる数値で、エージェントは長い期間に受け取る報酬の合計を最大にすることを目指す。
答え:○(正しい)
解説
正しい。Sutton と Barto は、報酬を、各時点で環境からエージェント(学習して行動する主体)に送られる1つの数値とし、目的は長い期間の報酬の合計を最大にすることだとしている。報酬は、その行動が良かったか悪かったかを表す点数のようなものである。ゲームで、敵を倒すと加点、ぶつかると減点、という点数がこれに当たる。 要点:報酬は、各時点で環境から強化学習のエージェントに送られる1つの数値で、エージェントの目的は長い期間に受け取る報酬の合計を最大にすることである。
問9
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|価値強化学習の価値は、ある状態からその先に得られると見込める報酬の合計を表し、長い目で見たその状態の良さを示す。
答え:○(正しい)
解説
正しい。Sutton と Barto は、報酬が「その場の良さ」を示すのに対し、価値は「長い目で見た良さ」を示すとし、状態の価値をそこから先に得られる報酬の総量の見込みとしている。たとえば資格の勉強は、その日は楽しくなくても(報酬は低い)、合格や昇進につながるので長い目で見た価値は高い、という関係である。 要点:報酬がその場で何が良いかを示すのに対し、価値(価値関数)は長い目で見て何が良いかを示し、ある状態の価値はそこから先に得られると見込める報酬の合計である。
問10
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|行動は価値で選ぶ強化学習のエージェントは、その場ですぐ得られる報酬が最も大きい行動を選ぶように学ぶ。
答え:×(誤り)
解説
誤り。誤りは「その場ですぐ得られる報酬が最も大きい行動」の部分。Sutton と Barto は、行動は報酬ではなく価値(長い目で見た良さ)が最も大きい状態をもたらすものを選ぶとしている。目先の値引きにつられて品を選ぶより、長く使えて結局得をする品を選ぶのと同じで、目先の点数より先々の合計を重んじる。 要点:強化学習では、目先の報酬が最も大きい状態ではなく、価値が最も大きい状態をもたらす行動を選ぶ。長い目で見て最も多くの報酬が得られるからである。
問11
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|方策強化学習の方策とは、エージェントが認識した環境の状態に応じて、どの行動を取るかを決める振る舞い方のことである。
答え:○(正しい)
解説
正しい。Sutton と Barto は、方策を、エージェントの振る舞い方で、おおまかには認識した状態から取る行動への対応としている。方策は「この場面ではこうする」という行動の決め方そのものである。たとえば車の運転で「信号が黄色ならブレーキ、青なら進む」という判断の仕方が方策に当たる。 要点:方策は、ある時点での学習するエージェントの振る舞い方で、おおまかには、認識した環境の状態から、その状態で取る行動への対応である。
問12
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|半教師あり学習半教師あり学習は、正解の付いた少量のデータと、正解の付いていない大量のデータの両方を使って学ぶ方法である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、半教師あり学習を、一部のデータにだけ正解があり、ほかにはない状況での学習とし、正解のない大量のデータからも学ぶことで過学習(学習データに合わせすぎること)を和らげられるとしている。たとえば、写真1万枚のうち100枚にだけ「不良品」の印があるとき、印のない残りの写真も使って学ばせるのがこの方法である。 要点:半教師あり学習は、一部のデータには正解(ラベル)があり、ほかのデータにはないときに、正解のないデータからも学ぶ方法で、正解付きのデータが少ないときの過学習を和らげる手立てになる。
問13
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|半教師ありの前提半教師あり学習は、すべてのデータに正解(ラベル)が付いていることを前提とする学習方法である。
答え:×(誤り)
解説
誤り。誤りは「すべてのデータに正解が付いている」の部分。半教師あり学習は、一部のデータにだけ正解(ラベル)があり、残りにはない状況で両方を使う方法である(『Deep Learning』)。正解を付ける作業は手間がかかるため、少しだけ正解を付け、残りは正解なしのまま活用したいときに役立つ。 要点:半教師あり学習は、一部のデータにだけ正解(ラベル)があり、ほかのデータにはない状況で、両方を使って学ぶ方法である。
問14
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|ノーフリーランチ定理ノーフリーランチ定理によると、ありうるすべての問題について平均すれば、どの学習アルゴリズムも他より常に優れているとはいえない。
答え:○(正しい)
解説
正しい。『Deep Learning』は、ありうるすべてのデータについて平均すると、どの分類のアルゴリズム(計算の手順)も未知のデータでの誤り率は同じになり、どれも万能に優れてはいないとしている。どんな料理にも一番合う万能の包丁がないように、課題によって向く手法は変わる、ということである。 要点:ノーフリーランチ定理は、ありうるすべてのデータの生まれ方について平均すると、どの分類アルゴリズムも未知の点を分類するときの誤り率は同じになり、どんな課題にも優れた万能のアルゴリズムはないことを示す。
問15
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理|万能のアルゴリズムはないノーフリーランチ定理は、どんな課題にも最も高い性能を出す万能の学習アルゴリズムが存在することを示している。
答え:×(誤り)
解説
誤り。示している内容が逆である。ノーフリーランチ定理は、すべての課題で平均すればどのアルゴリズムも同じ性能になり、万能のものはないことを示す。『Deep Learning』は、研究の目的は万能のアルゴリズム探しではなく、課題に合うものを作ることだとしている。何にでも一番の道具はなく、仕事に合った道具を選ぶ、という考え方である。 要点:ノーフリーランチ定理から、機械学習では万能のアルゴリズムを探すのではなく、取り組む課題に合わせてうまく働くアルゴリズムを選び、設計する必要がある。
教師なし学習・強化学習・半教師あり学習とノーフリーランチ定理の問題を続けて解く
この論点に対応する15問を絞り込んで出題します。