AIの基礎と歴史
機械学習と教師あり学習(分類・回帰・正解率)
機械学習は、データを使ってAIモデルのパラメータを決める「学習」で学習済みモデルを作り、未知のデータに当てる「推論」で使います。教師あり学習は、正解(ラベル)付きの教師データから入力→正解を予測する方法で、カテゴリを当てる分類(二値分類・多値分類)と数値を当てる回帰があり、性能は学習に使っていないテストデータで正解率などを測ることを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
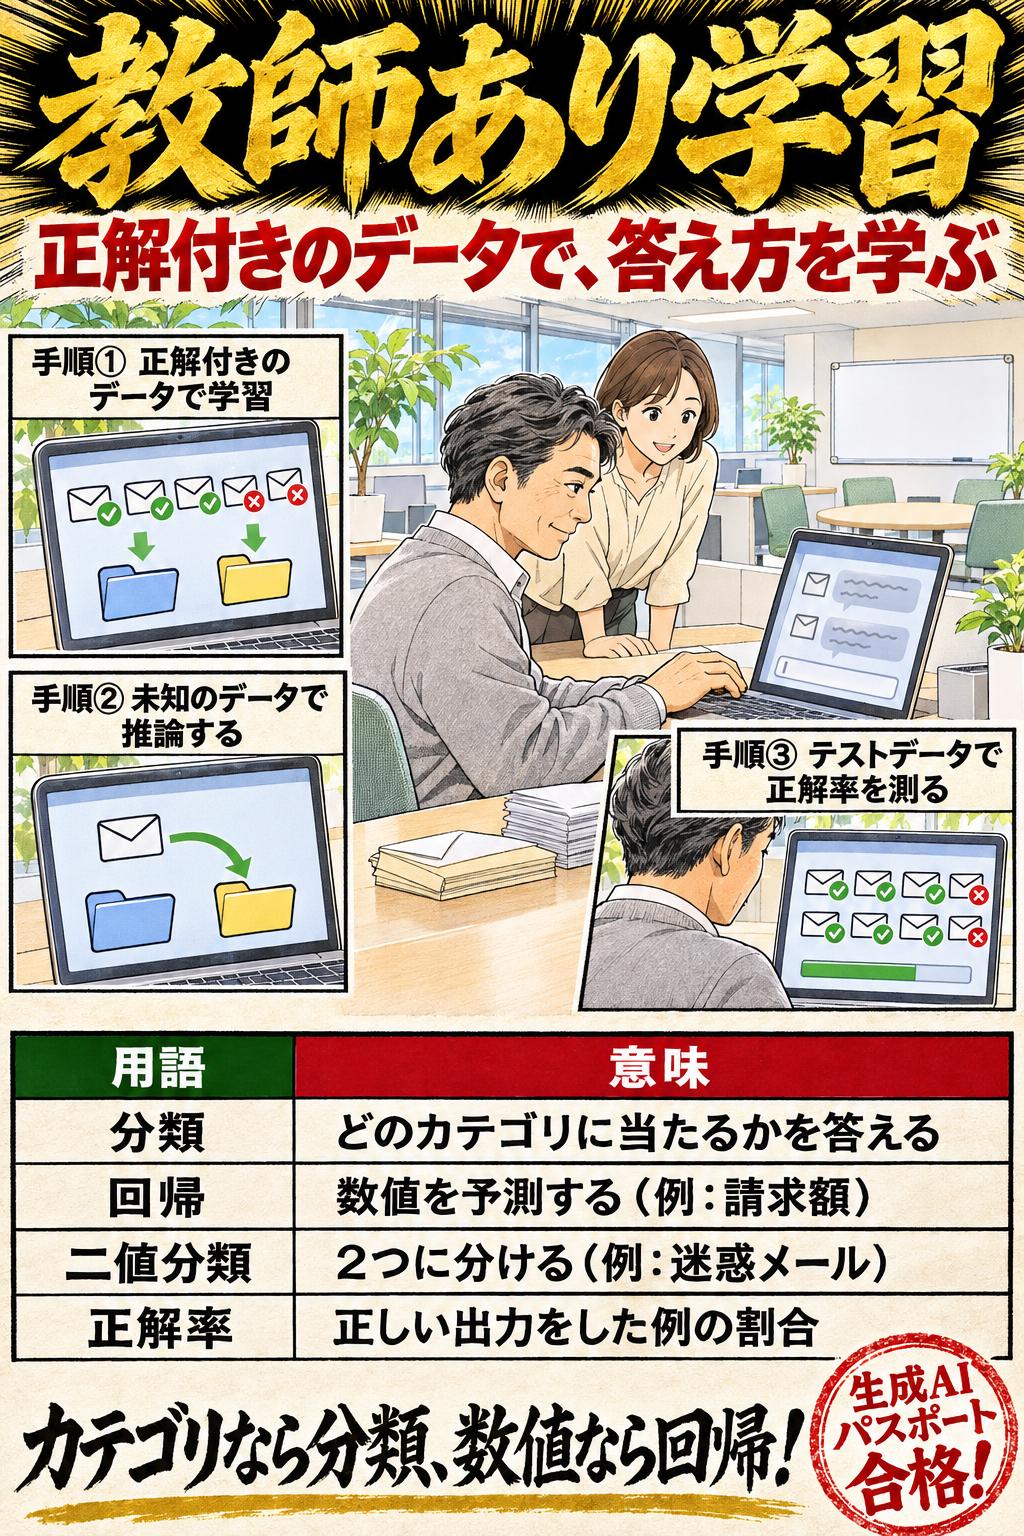
機械学習は、データを使ってAIモデルのパラメータを決める「学習」で学習済みモデルを作り、未知のデータに当てる「推論」で使います。教師あり学習は、正解(ラベル)付きの教師データから入力→正解を予測する方法で、カテゴリを当てる分類(二値分類・多値分類)と数値を当てる回帰があり、性能は学習に使っていないテストデータで正解率などを測ることを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 14問
機械学習と教師あり学習(分類・回帰・正解率)|学習とは
学習とは、データを用いてAIモデルのパラメータを決定または改善するプロセスで、教師あり学習・教師なし学習・強化学習などの手法がある(AI事業者ガイドライン)。
この論点の用語
用語集をすべて見る →01機械学習と教師あり学習(分類・回帰・正解率)の重要暗記項目
機械学習と教師あり学習(分類・回帰・正解率)|学習とは
学習とは、データを用いてAIモデルのパラメータを決定または改善するプロセスで、教師あり学習・教師なし学習・強化学習などの手法がある(AI事業者ガイドライン)。
機械学習と教師あり学習(分類・回帰・正解率)|学習済みモデルと推論
推論とは、学習済みモデルに未知のデータを与え、予測・分類・生成などの出力を得るプロセスである(AI事業者ガイドライン)。
機械学習と教師あり学習(分類・回帰・正解率)|学習と推論の取り違え
推論とは、学習済みモデルに未知のデータを与え、予測・分類・生成などの出力を得るプロセスである。データを用いてAIモデルのパラメータを決定または改善するのが学習である。
ひっかけ注意「学習済みモデルに新しいデータを与えて予測や分類の結果を得る工程は、機械学習では「学習」と呼ばれる」は誤り。 「学習と呼ばれる」の部分が違う。AI事業者ガイドライン(第1.2版)では、学習済みモデルに未知のデータを与えて出力を得るのは「推論」で、「学習」はデータでモデルのパラメータを決めたり改善したりすることである。料理にたとえると、レシピを練習して身につけるのが学習、身につけたレシピで今日の注文の料理を作るのが推論である。
機械学習と教師あり学習(分類・回帰・正解率)|教師あり学習
教師あり学習は、それぞれのデータに正解(ラベル)が付いた教師データを使い、入力から正解を予測できるように学ぶ。
機械学習と教師あり学習(分類・回帰・正解率)|正解のないデータ
教師あり学習は、正解(ラベル)付きの教師データを使って学ぶ。正解の付いていないデータから隠れた構造を見つけるのは教師なし学習である。
ひっかけ注意「教師あり学習では、正解(ラベル)の付いていないデータだけを使い、データの中に隠れた構造を見つけ出す」は誤り。 正解のないデータから隠れた構造を見つけるのは教師なし学習で、教師あり学習と取り違えている。教師あり学習は、正解(ラベル)付きの教師データを使い、入力から正解を当てられるように学ぶ(『Deep Learning』)。答え付きの問題集で練習するのが教師あり学習、答えのない資料を眺めて共通点を見つけるのが教師なし学習、と考えると区別しやすい。
機械学習と教師あり学習(分類・回帰・正解率)|「教師」の意味
「教師あり」という名前は、正解(目標の値)を、機械学習のシステムに何をすべきかを示す指導者や教師が与えるという見方に由来する。
機械学習と教師あり学習(分類・回帰・正解率)|分類
分類は、入力がいくつか(k個)のカテゴリのどれに当たるかを答える課題で、画像に写った物体を見分ける物体認識はその例である。
機械学習と教師あり学習(分類・回帰・正解率)|回帰
回帰は、入力から数値を予測する課題で、保険で見込まれる請求額の予測や将来の株価の予測はその例である。
覚える数字と、狙われる引っかけ
- ひっかけ「学習済みモデルに新しいデータを与えて予測や分類の結果を得る工程は、機械学習では「学習」と呼ばれる」は誤り。「学習と呼ばれる」の部分が違う。AI事業者ガイドライン(第1.2版)では、学習済みモデルに未知のデータを与えて出力を得るのは「推論」で、「学習」はデータでモデルのパラメータを決めたり改善したりすることである。料理にたとえると、レシピを練習して身につけるのが学習、身につけたレシピで今日の注文の料理を作るのが推論である。
- ひっかけ「教師あり学習では、正解(ラベル)の付いていないデータだけを使い、データの中に隠れた構造を見つけ出す」は誤り。正解のないデータから隠れた構造を見つけるのは教師なし学習で、教師あり学習と取り違えている。教師あり学習は、正解(ラベル)付きの教師データを使い、入力から正解を当てられるように学ぶ(『Deep Learning』)。答え付きの問題集で練習するのが教師あり学習、答えのない資料を眺めて共通点を見つけるのが教師なし学習、と考えると区別しやすい。
- ひっかけ「将来の株価のように数値を予測する課題は、教師あり学習のうちの分類に当たる」は誤り。「分類に当たる」の部分が違う。数値を予測する課題は回帰で、『Deep Learning』は将来の証券の価格の予測を回帰の例に挙げている。分類は「どの種類か」を答える課題である。株価を「何円」と当てるなら回帰、と答えの形で見分けるとよい。来月の売上金額や明日の気温の予測も、答えが数値なので回帰である。
- ひっかけ「メールを迷惑メールか通常のメールかに分ける課題は、答えのカテゴリが2つなので多値分類に当たる」は誤り。「多値分類に当たる」の部分が違う。答えの種類が2つの分類は二値分類である。『Deep Learning』は、通常のメールと迷惑メールを分けることを単純な機械学習の例に挙げている。多値分類は答えの種類が3つ以上の場合で、たとえば問い合わせを「請求・配送・返品」の3つに振り分けるような課題を指す。
- ひっかけ「機械学習のモデルの性能は、学習に使ったデータと同じデータで正解率などを測って評価するのが基本である」は誤り。「学習に使ったデータと同じデータで測る」の部分が違う。『Deep Learning』は、知りたいのはまだ見ていないデータでの性能なので、学習に使ったものとは別のテストデータで評価するとしている。練習した過去問だけで実力を測っても答えを覚えているだけかもしれないのと同じで、初めて見る問題で試して初めて本当の力が分かる。
- ひっかけ「正解率は、モデルが誤った出力をした例の割合を表す指標である」は誤り。「誤った出力をした例の割合」の部分が違う。それは誤り率で、正解率は正しい出力をした例の割合である(『Deep Learning』)。たとえば100件中90件を正しく答えたなら、正解率は90%、誤り率は10%で、2つを足すと100%になる関係である。
02試験で正誤を分けるチェック順
- 1学習とは、データを用いてAIモデルのパラメータを決定または改善するプロセスで、教師あり学習・教師なし学習・強化学習などの手法がある(AI事業者ガイドライン)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2推論とは、学習済みモデルに未知のデータを与え、予測・分類・生成などの出力を得るプロセスである(AI事業者ガイドライン)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3推論とは、学習済みモデルに未知のデータを与え、予測・分類・生成などの出力を得るプロセスである。データを用いてAIモデルのパラメータを決定または改善するのが学習である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4教師あり学習は、それぞれのデータに正解(ラベル)が付いた教師データを使い、入力から正解を予測できるように学ぶ。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5教師あり学習は、正解(ラベル)付きの教師データを使って学ぶ。正解の付いていないデータから隠れた構造を見つけるのは教師なし学習である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6「教師あり」という名前は、正解(目標の値)を、機械学習のシステムに何をすべきかを示す指導者や教師が与えるという見方に由来する。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7分類は、入力がいくつか(k個)のカテゴリのどれに当たるかを答える課題で、画像に写った物体を見分ける物体認識はその例である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8回帰は、入力から数値を予測する課題で、保険で見込まれる請求額の予測や将来の株価の予測はその例である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9数値を予測する課題は回帰で、入力がどのカテゴリに当たるかを答える課題が分類である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10答えのカテゴリが2つの分類を二値分類(例:迷惑メールか通常のメールか)、3つ以上の分類を多値分類(例:アヤメを3つの品種に分ける)という。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11答えのカテゴリが2つの分類を二値分類、3つ以上の分類を多値分類という。迷惑メールか通常のメールかを分ける課題は二値分類である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12正解率は、モデルが正しい出力をした例の割合である。誤った出力をした例の割合は誤り率という。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13モデルの性能は、現実で使ったときの働きを見るため、学習に使ったデータとは別のテストデータで測る。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14正解率は、モデルが正しい出力をした例の割合である。誤った出力をした例の割合は誤り率という。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
機械学習と教師あり学習(分類・回帰・正解率)の○×一問一答
1/8問解答 0・正解 0
AIの基礎と歴史
機械学習と教師あり学習(分類・回帰・正解率)|学習とは
AI事業者ガイドラインは、学習を、データを用いてAIモデルのパラメータを決定または改善するプロセスと定義している。
機械学習と教師あり学習(分類・回帰・正解率)の○×一問一答14問|問題と解説
この論点で収録している14問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
機械学習と教師あり学習(分類・回帰・正解率)|学習とはAI事業者ガイドラインは、学習を、データを用いてAIモデルのパラメータを決定または改善するプロセスと定義している。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(第1.2版)の定義どおり。パラメータとは、AIモデルの中にある調整用のつまみのような数値で、学習はデータを使ってそのつまみを合わせていく作業である。たとえば過去の売上データを使い、来月の売上を当てられるように予測の式の数値を調整していくことが学習に当たる。 要点:学習とは、データを用いてAIモデルのパラメータを決定または改善するプロセスで、教師あり学習・教師なし学習・強化学習などの手法がある(AI事業者ガイドライン)。
問2
機械学習と教師あり学習(分類・回帰・正解率)|学習済みモデルと推論学習済みモデルに未知のデータを与えて、予測や分類などの出力を得る工程を推論という。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(第1.2版)の定義どおり。学習でできあがったモデル(学習済みモデル)に新しいデータを入れて答えを出させるのが推論である。たとえば、学習を終えた迷惑メールの判定の仕組みに今日届いたメールを読ませ、「迷惑メール」と判定させるのが推論に当たる。学習は作る段階、推論は使う段階と覚えるとよい。 要点:推論とは、学習済みモデルに未知のデータを与え、予測・分類・生成などの出力を得るプロセスである(AI事業者ガイドライン)。
問3
機械学習と教師あり学習(分類・回帰・正解率)|学習と推論の取り違え学習済みモデルに新しいデータを与えて予測や分類の結果を得る工程は、機械学習では「学習」と呼ばれる。
答え:×(誤り)
解説
誤り。誤りは「学習と呼ばれる」の部分。AI事業者ガイドライン(第1.2版)では、学習済みモデルに未知のデータを与えて出力を得るのは「推論」で、「学習」はデータでモデルのパラメータを決めたり改善したりすることである。料理にたとえると、レシピを練習して身につけるのが学習、身につけたレシピで今日の注文の料理を作るのが推論である。 要点:推論とは、学習済みモデルに未知のデータを与え、予測・分類・生成などの出力を得るプロセスである。データを用いてAIモデルのパラメータを決定または改善するのが学習である。
問4
機械学習と教師あり学習(分類・回帰・正解率)|教師あり学習教師あり学習では、入力と、それに対応する正解(ラベル)を組にした教師データを使って、入力から正解を予測できるように学ぶ。
答え:○(正しい)
解説
正しい。『Deep Learning』は、教師あり学習では各データにラベル(正解)が付いており、入力から正解を予測できるように学ぶとしている。入力と正解の組を教師データという。たとえば「メールの本文」と「迷惑メールかどうか」の組を大量に見せて、新しいメールの判定を覚えさせるのが教師あり学習である。 要点:教師あり学習は、それぞれのデータに正解(ラベル)が付いた教師データを使い、入力から正解を予測できるように学ぶ。
問5
機械学習と教師あり学習(分類・回帰・正解率)|正解のないデータ教師あり学習では、正解(ラベル)の付いていないデータだけを使い、データの中に隠れた構造を見つけ出す。
答え:×(誤り)
解説
誤り。正解のないデータから隠れた構造を見つけるのは教師なし学習で、教師あり学習と取り違えている。教師あり学習は、正解(ラベル)付きの教師データを使い、入力から正解を当てられるように学ぶ(『Deep Learning』)。答え付きの問題集で練習するのが教師あり学習、答えのない資料を眺めて共通点を見つけるのが教師なし学習、と考えると区別しやすい。 要点:教師あり学習は、正解(ラベル)付きの教師データを使って学ぶ。正解の付いていないデータから隠れた構造を見つけるのは教師なし学習である。
問6
機械学習と教師あり学習(分類・回帰・正解率)|「教師」の意味教師あり学習の「教師」は、AIに正解を示す役目を表し、正解(ラベル)が教師から与えられるという見方に由来する。
答え:○(正しい)
解説
正しい。『Deep Learning』は、教師あり学習という名前は、正解の値を、何をすべきかを示す指導者や教師が与えるという見方から来ているとしている。つまり「教師」とは、正解(ラベル)を与える役目のことである。答え合わせ付きのドリルで練習する子どもと、答えを示す先生の関係にたとえられる。教師なし学習には、この答えを示す役がいない。 要点:「教師あり」という名前は、正解(目標の値)を、機械学習のシステムに何をすべきかを示す指導者や教師が与えるという見方に由来する。
問7
機械学習と教師あり学習(分類・回帰・正解率)|分類入力がいくつかのカテゴリのどれに当たるかを答える課題を分類といい、画像に写った物体が何かを見分ける物体認識はその例である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、分類を、入力がいくつかのカテゴリのどれに当たるかを答える課題とし、画像に写った物体を見分ける物体認識を例に挙げている。答えが「どれか1つの種類」になるのが分類の特徴である。たとえば、届いた問い合わせのメールを「請求」「配送」「返品」のどれに当たるかに振り分ける仕事は分類に当たる。 要点:分類は、入力がいくつか(k個)のカテゴリのどれに当たるかを答える課題で、画像に写った物体を見分ける物体認識はその例である。
問8
機械学習と教師あり学習(分類・回帰・正解率)|回帰回帰は、入力をもとに数値を予測する課題で、保険で見込まれる請求額の予測などがその例である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、回帰を、入力から数値を予測する課題とし、保険の請求額の見込みや将来の株価の予測を例に挙げている。答えが金額や個数などの数値になるのが回帰の特徴で、種類を答える分類とは出力の形が違う。たとえば、天気や曜日から明日の来店客数を何人と予測するのは回帰に当たる。 要点:回帰は、入力から数値を予測する課題で、保険で見込まれる請求額の予測や将来の株価の予測はその例である。
問9
機械学習と教師あり学習(分類・回帰・正解率)|数値の予測は回帰将来の株価のように数値を予測する課題は、教師あり学習のうちの分類に当たる。
答え:×(誤り)
解説
誤り。誤りは「分類に当たる」の部分。数値を予測する課題は回帰で、『Deep Learning』は将来の証券の価格の予測を回帰の例に挙げている。分類は「どの種類か」を答える課題である。株価を「何円」と当てるなら回帰、と答えの形で見分けるとよい。来月の売上金額や明日の気温の予測も、答えが数値なので回帰である。 要点:数値を予測する課題は回帰で、入力がどのカテゴリに当たるかを答える課題が分類である。
問10
機械学習と教師あり学習(分類・回帰・正解率)|二値分類と多値分類アヤメの花を測った値から3つの品種のどれかを当てる課題は、答えのカテゴリが3つあるので多値分類に当たる。
答え:○(正しい)
解説
正しい。『Deep Learning』は、アヤメの花の測った値から3つの品種に分ける例を挙げている。答えの種類が3つ以上の分類を多値分類、2つの分類を二値分類という。たとえば、お客様の声を「満足」「普通」「不満」の3つに分けるのは多値分類、「対応が要る・要らない」の2つに分けるのは二値分類である。 要点:答えのカテゴリが2つの分類を二値分類(例:迷惑メールか通常のメールか)、3つ以上の分類を多値分類(例:アヤメを3つの品種に分ける)という。
問11
機械学習と教師あり学習(分類・回帰・正解率)|迷惑メールの判定メールを迷惑メールか通常のメールかに分ける課題は、答えのカテゴリが2つなので多値分類に当たる。
答え:×(誤り)
解説
誤り。誤りは「多値分類に当たる」の部分。答えの種類が2つの分類は二値分類である。『Deep Learning』は、通常のメールと迷惑メールを分けることを単純な機械学習の例に挙げている。多値分類は答えの種類が3つ以上の場合で、たとえば問い合わせを「請求・配送・返品」の3つに振り分けるような課題を指す。 要点:答えのカテゴリが2つの分類を二値分類、3つ以上の分類を多値分類という。迷惑メールか通常のメールかを分ける課題は二値分類である。
問12
機械学習と教師あり学習(分類・回帰・正解率)|正解率分類のモデルの正解率とは、モデルが正しい出力をした例の割合のことである。
答え:○(正しい)
解説
正しい。『Deep Learning』は、正解率(accuracy)を、モデルが正しい出力をした例の割合としている。逆に、誤った出力をした例の割合が誤り率である。たとえば、テスト用のメール100通のうち95通を正しく判定できれば、正解率は95%、誤り率は5%となる。 要点:正解率は、モデルが正しい出力をした例の割合である。誤った出力をした例の割合は誤り率という。
問13
機械学習と教師あり学習(分類・回帰・正解率)|テストデータで測る機械学習のモデルの性能は、学習に使ったデータと同じデータで正解率などを測って評価するのが基本である。
答え:×(誤り)
解説
誤り。誤りは「学習に使ったデータと同じデータで測る」の部分。『Deep Learning』は、知りたいのはまだ見ていないデータでの性能なので、学習に使ったものとは別のテストデータで評価するとしている。練習した過去問だけで実力を測っても答えを覚えているだけかもしれないのと同じで、初めて見る問題で試して初めて本当の力が分かる。 要点:モデルの性能は、現実で使ったときの働きを見るため、学習に使ったデータとは別のテストデータで測る。
問14
機械学習と教師あり学習(分類・回帰・正解率)|正解率と誤り率正解率は、モデルが誤った出力をした例の割合を表す指標である。
答え:×(誤り)
解説
誤り。誤りは「誤った出力をした例の割合」の部分。それは誤り率で、正解率は正しい出力をした例の割合である(『Deep Learning』)。たとえば100件中90件を正しく答えたなら、正解率は90%、誤り率は10%で、2つを足すと100%になる関係である。 要点:正解率は、モデルが正しい出力をした例の割合である。誤った出力をした例の割合は誤り率という。
機械学習と教師あり学習(分類・回帰・正解率)の問題を続けて解く
この論点に対応する14問を絞り込んで出題します。