AIの基礎と歴史
過学習と対策・転移学習
汎化は学習に使っていない未知のデータでもうまく働く能力で、過学習は学習データでの誤差とテストデータでの誤差の差が大きくなりすぎた状態です。対策のアーリーストッピング(検証データの誤差が最も小さい時点を使う)・正則化(汎化誤差を減らす工夫の総称。重みの罰則など)・ドロップアウト(学習中にユニットを無作為に外す)の違いと、ある課題で学んだことを別の課題に生かす転移学習、学習済みモデルを用途に合わせて追加で学習させるファインチューニングを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
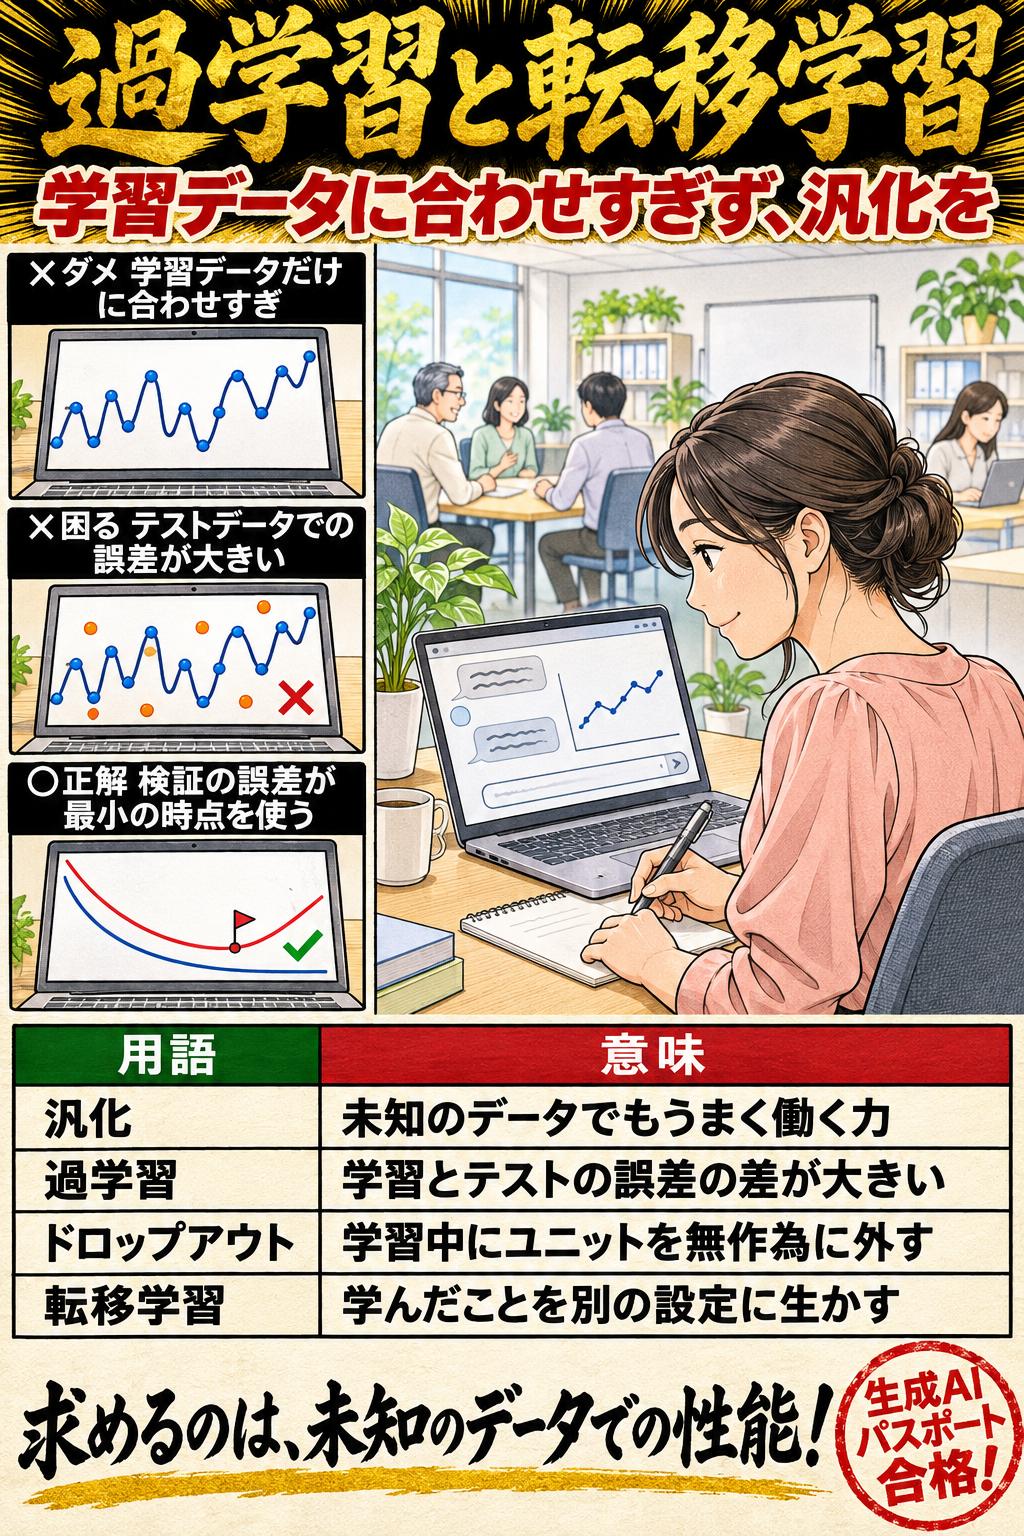
汎化は学習に使っていない未知のデータでもうまく働く能力で、過学習は学習データでの誤差とテストデータでの誤差の差が大きくなりすぎた状態です。対策のアーリーストッピング(検証データの誤差が最も小さい時点を使う)・正則化(汎化誤差を減らす工夫の総称。重みの罰則など)・ドロップアウト(学習中にユニットを無作為に外す)の違いと、ある課題で学んだことを別の課題に生かす転移学習、学習済みモデルを用途に合わせて追加で学習させるファインチューニングを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 15問
過学習と対策・転移学習|汎化
学習に使っていない、まだ見たことのない入力に対してもうまく働く能力を汎化という。機械学習で求めるのは、学習データだけでなく新しいデータでの性能である。
比較して覚える
過学習の対策:アーリーストッピング・重みの罰則・ドロップアウト
過学習を防ぐ3つの方法を、何をするか・どこに働くかで並べます。検証データを見て止める方法、重みに罰則を加える方法、学習中にユニットを外す方法を取り違える肢を切り分けられます。
| 事由 | アーリーストッピング | 重みの罰則(重み減衰など) | ドロップアウト |
|---|---|---|---|
| 何をするか | 検証データの誤差が最も小さかった時点のパラメータを使う | 損失関数に重みの大きさに応じた罰則の項を加える | 学習中、入力層・隠れ層のユニットを無作為に外す |
| 見るもの・働く所 | 学習データとは別の検証データの誤差 | 重みなどのパラメータの大きさ | ネットワークのユニット(例を読み込むたびに選び直す) |
| ねらい | 検証データの誤差が上がり始める(過学習が進む)前の時点を使う | 重みが大きくなりすぎないようにし、モデルの表現力を抑える | 多数のネットワークをまとめて学ぶ効果を安く近似する |
| 学習データ・推論との関係 | 学習データの誤差が下がっていても、検証データの誤差で判断する | 学習データの誤差だけでなく、罰則との合計を小さくする | 外すのは学習のときだけで、推論ではすべてのユニットを使う |
| 身近なたとえ | 模試の点が一番良かったところで詰め込みをやめる | 評価で一項目だけを極端に重く見ないよう上限を設ける | 日替わりで何人か休んでも回るようにチームで練習する |
何をするか
- アーリーストッピング
- 検証データの誤差が最も小さかった時点のパラメータを使う
- 重みの罰則(重み減衰など)
- 損失関数に重みの大きさに応じた罰則の項を加える
- ドロップアウト
- 学習中、入力層・隠れ層のユニットを無作為に外す
見るもの・働く所
- アーリーストッピング
- 学習データとは別の検証データの誤差
- 重みの罰則(重み減衰など)
- 重みなどのパラメータの大きさ
- ドロップアウト
- ネットワークのユニット(例を読み込むたびに選び直す)
ねらい
- アーリーストッピング
- 検証データの誤差が上がり始める(過学習が進む)前の時点を使う
- 重みの罰則(重み減衰など)
- 重みが大きくなりすぎないようにし、モデルの表現力を抑える
- ドロップアウト
- 多数のネットワークをまとめて学ぶ効果を安く近似する
学習データ・推論との関係
- アーリーストッピング
- 学習データの誤差が下がっていても、検証データの誤差で判断する
- 重みの罰則(重み減衰など)
- 学習データの誤差だけでなく、罰則との合計を小さくする
- ドロップアウト
- 外すのは学習のときだけで、推論ではすべてのユニットを使う
身近なたとえ
- アーリーストッピング
- 模試の点が一番良かったところで詰め込みをやめる
- 重みの罰則(重み減衰など)
- 評価で一項目だけを極端に重く見ないよう上限を設ける
- ドロップアウト
- 日替わりで何人か休んでも回るようにチームで練習する
この論点の用語
用語集をすべて見る →01過学習と対策・転移学習の重要暗記項目
過学習と対策・転移学習|汎化
学習に使っていない、まだ見たことのない入力に対してもうまく働く能力を汎化という。機械学習で求めるのは、学習データだけでなく新しいデータでの性能である。
過学習と対策・転移学習|過学習
過学習(オーバーフィッティング)は、学習データでの誤差とテストデータでの誤差の差が大きすぎる状態である。学習データでの誤差を十分に小さくできない状態は未学習(アンダーフィッティング)という。
過学習と対策・転移学習|未学習との取り違え
学習データでの誤差を十分に小さくできない状態は未学習(アンダーフィッティング)で、過学習は学習データとテストデータでの誤差の差が大きすぎる状態である。
ひっかけ注意「過学習とは、モデルが学習データに対しても誤差を十分に小さくできない状態のことである」は誤り。 説明しているのは過学習ではなく未学習である。学習データに対しても誤差を十分に小さくできないのは未学習(アンダーフィッティング)で、過学習は、学習データでは誤差が小さいのにテストデータとの差が大きすぎる状態である(『Deep Learning』)。練習問題すら解けないのが未学習、練習問題だけ解けて本番で解けないのが過学習である。
過学習と対策・転移学習|アーリーストッピング
アーリーストッピングは、表現力の大きいモデルでは、学習データの誤差が下がっていても検証データの誤差がやがて上がり始めることがよくあるため、検証データの誤差が最も小さかった時点のパラメータを使う方法で、正則化の一つである。
過学習と対策・転移学習|検証データの誤差で判断
アーリーストッピングで見るのは学習に使っていない検証データの誤差で、その誤差が最も小さかった時点のパラメータを使う。
ひっかけ注意「アーリーストッピングでは、学習データに対する誤差が最も小さくなった時点のパラメータを採用する」は誤り。 「学習データに対する誤差」の部分が違う。アーリーストッピングで見るのは、学習に使っていない検証データの誤差である(『Deep Learning』)。学習データの誤差が下がっていても、検証データの誤差は悪化していることがあるので、学習データの誤差だけでは止めどきが分からない。練習問題の点ではなく、初見の模試の点で仕上がりを判断するのと同じである。
過学習と対策・転移学習|正則化
正則化は、学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすことを目的として、学習のアルゴリズムに加える変更の総称である。
過学習と対策・転移学習|正則化の目的
正則化の目的は、学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすことである。
ひっかけ注意「正則化は、未知のデータでの誤差ではなく、学習データに対する誤差を小さくすることを目的とした工夫である」は誤り。 目的が逆になっている。『Deep Learning』の定義では、正則化は学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすための工夫である。学習データの誤差だけを下げようとすると、かえって丸暗記(過学習)が進む。正則化は、練習の点よりも本番の点を上げるためのものと覚えるとよい。
過学習と対策・転移学習|重みに罰則を加える
正則化の代表的な方法に、重みなどのパラメータの大きさに応じた罰則の項を損失関数に加え、重みが大きくなりすぎないようにする方法(重み減衰はその例)がある。
覚える数字と、狙われる引っかけ
- ひっかけ「過学習とは、モデルが学習データに対しても誤差を十分に小さくできない状態のことである」は誤り。説明しているのは過学習ではなく未学習である。学習データに対しても誤差を十分に小さくできないのは未学習(アンダーフィッティング)で、過学習は、学習データでは誤差が小さいのにテストデータとの差が大きすぎる状態である(『Deep Learning』)。練習問題すら解けないのが未学習、練習問題だけ解けて本番で解けないのが過学習である。
- ひっかけ「アーリーストッピングでは、学習データに対する誤差が最も小さくなった時点のパラメータを採用する」は誤り。「学習データに対する誤差」の部分が違う。アーリーストッピングで見るのは、学習に使っていない検証データの誤差である(『Deep Learning』)。学習データの誤差が下がっていても、検証データの誤差は悪化していることがあるので、学習データの誤差だけでは止めどきが分からない。練習問題の点ではなく、初見の模試の点で仕上がりを判断するのと同じである。
- ひっかけ「正則化は、未知のデータでの誤差ではなく、学習データに対する誤差を小さくすることを目的とした工夫である」は誤り。目的が逆になっている。『Deep Learning』の定義では、正則化は学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすための工夫である。学習データの誤差だけを下げようとすると、かえって丸暗記(過学習)が進む。正則化は、練習の点よりも本番の点を上げるためのものと覚えるとよい。
- ひっかけ「ドロップアウトは、学習データの一部を無作為に選んで取り除きながら学習する方法である」は誤り。「学習データを取り除く」の部分が違う。ドロップアウトで無作為に外すのは、学習データではなく、ネットワークの入力層や隠れ層のユニット(計算の単位)である(『Deep Learning』)。データは減らさず、毎回ネットワークの一部を休ませて学習させる。チームの何人かを日替わりで休ませて練習する、というイメージである。
- ひっかけ「転移学習は、新しい課題ごとに、それまでに学んだ内容を使わずに一から学習し直す方法である」は誤り。「一から学習し直す」の部分が違う。転移学習は、ある課題で学んだことを別の課題に生かす方法である。『Deep Learning』は、画像の縁や形のように多くの課題に共通する見方を共有できるため、前の課題で学んだことが役立つとしている。経験者が転職先で、前の職場で身につけた基本の力を使って早く仕事を覚えるのと同じ考え方である。
- ひっかけ「ファインチューニングは、追加の学習ではなく、AIモデルの汎化性能を形作る最初の事前学習のことを指す」は誤り。「事前学習のことを指す」の部分が違う。AI事業者ガイドライン(第1.2版)は、学習を、モデルの基本的な力(汎化性能)を作る事前学習と、そのあとの事後学習に分け、ファインチューニングを事後学習の主な手法としている。社員教育にたとえると、事前学習は入社時の幅広い基礎研修、ファインチューニングは配属先での仕事に合わせた追加研修である。
02試験で正誤を分けるチェック順
- 1学習に使っていない、まだ見たことのない入力に対してもうまく働く能力を汎化という。機械学習で求めるのは、学習データだけでなく新しいデータでの性能である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2過学習(オーバーフィッティング)は、学習データでの誤差とテストデータでの誤差の差が大きすぎる状態である。学習データでの誤差を十分に小さくできない状態は未学習(アンダーフィッティング)という。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3学習データでの誤差を十分に小さくできない状態は未学習(アンダーフィッティング)で、過学習は学習データとテストデータでの誤差の差が大きすぎる状態である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4アーリーストッピングは、表現力の大きいモデルでは、学習データの誤差が下がっていても検証データの誤差がやがて上がり始めることがよくあるため、検証データの誤差が最も小さかった時点のパラメータを使う方法で、正則化の一つである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5アーリーストッピングで見るのは学習に使っていない検証データの誤差で、その誤差が最も小さかった時点のパラメータを使う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6正則化は、学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすことを目的として、学習のアルゴリズムに加える変更の総称である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7正則化の目的は、学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすことである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8正則化の代表的な方法に、重みなどのパラメータの大きさに応じた罰則の項を損失関数に加え、重みが大きくなりすぎないようにする方法(重み減衰はその例)がある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9ドロップアウトは、学習中、例を読み込むたびに入力層と隠れ層のユニットを無作為に選んで外し(出力に0を掛け)、多数のネットワークをまとめて学ぶのに近い効果を安く得る正則化の方法である。推論のときはすべてのユニットを使う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10ドロップアウトで無作為に外すのは、学習データではなく、入力層や隠れ層のユニットである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11汎化をよくする最もよい方法は、より多くのデータで学習することで、データが限られるときは、学習データを変形した新しいデータを作って足す(データ拡張)こともある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12転移学習は、ある設定で学んだことを、別の設定での汎化をよくするために生かす方法で、最初の設定に多くのデータがあれば、次の設定のごく少ない例からでも素早く学べることがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13転移学習は、ある設定で学んだことを別の設定に生かす方法で、新しい課題ごとに一から学び直すのではない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14ファインチューニングは、事前学習済みのAIモデルを特定の用途に合わせるために行う追加の学習(事後学習)の主な手法である(AI事業者ガイドライン)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 15ファインチューニングは事前学習のあとに行う追加の学習(事後学習)の手法で、AIモデルの汎化性能を形作る事前学習そのものではない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
過学習と対策・転移学習の○×一問一答
1/8問解答 0・正解 0
AIの基礎と歴史
過学習と対策・転移学習|汎化
機械学習のモデルが、学習に使っていない未知のデータに対してもうまく働く能力を汎化という。
過学習と対策・転移学習の○×一問一答15問|問題と解説
この論点で収録している15問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
過学習と対策・転移学習|汎化機械学習のモデルが、学習に使っていない未知のデータに対してもうまく働く能力を汎化という。
答え:○(正しい)
解説
正しい。『Deep Learning』は、学習に使っていない未知の入力でもうまく働く能力を汎化と呼び、これが機械学習の中心の課題だとしている。汎化とは、いわば「応用が利く」ことである。練習した問題だけでなく、初めて見る問題でも正しく解ける受験生は、汎化の力が高いといえる。 要点:学習に使っていない、まだ見たことのない入力に対してもうまく働く能力を汎化という。機械学習で求めるのは、学習データだけでなく新しいデータでの性能である。
問2
過学習と対策・転移学習|過学習過学習とは、学習データに対する誤差は小さいのに、テストデータに対する誤差との差が大きくなりすぎた状態である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、学習データとテストデータでの誤差の差が大きすぎる状態を過学習(オーバーフィッティング)としている。学習データに合わせすぎて、新しいデータに当てはまらなくなる状態である。過去問の答えを丸暗記して練習では満点なのに、少し変えた本番の問題が解けないのが過学習のイメージである。 要点:過学習(オーバーフィッティング)は、学習データでの誤差とテストデータでの誤差の差が大きすぎる状態である。学習データでの誤差を十分に小さくできない状態は未学習(アンダーフィッティング)という。
問3
過学習と対策・転移学習|未学習との取り違え過学習とは、モデルが学習データに対しても誤差を十分に小さくできない状態のことである。
答え:×(誤り)
解説
誤り。説明しているのは過学習ではなく未学習である。学習データに対しても誤差を十分に小さくできないのは未学習(アンダーフィッティング)で、過学習は、学習データでは誤差が小さいのにテストデータとの差が大きすぎる状態である(『Deep Learning』)。練習問題すら解けないのが未学習、練習問題だけ解けて本番で解けないのが過学習である。 要点:学習データでの誤差を十分に小さくできない状態は未学習(アンダーフィッティング)で、過学習は学習データとテストデータでの誤差の差が大きすぎる状態である。
問4
過学習と対策・転移学習|アーリーストッピングアーリーストッピングは、学習中に検証データの誤差が最も小さかった時点のパラメータを使う方法で、過学習を防ぐ正則化の一つである。
答え:○(正しい)
解説
正しい。『Deep Learning』は、表現力の大きいモデルでは、学習データの誤差が下がり続けていても、検証データ(学習に使わず、途中の出来を確かめるデータ)の誤差がやがて上がり始めることがよくあるため、その誤差が最も小さかった時点に戻すとし、これをアーリーストッピングと呼んでいる。模試の点が一番良かったところで詰め込みをやめる、という考え方である。 要点:アーリーストッピングは、表現力の大きいモデルでは、学習データの誤差が下がっていても検証データの誤差がやがて上がり始めることがよくあるため、検証データの誤差が最も小さかった時点のパラメータを使う方法で、正則化の一つである。
問5
過学習と対策・転移学習|検証データの誤差で判断アーリーストッピングでは、学習データに対する誤差が最も小さくなった時点のパラメータを採用する。
答え:×(誤り)
解説
誤り。誤りは「学習データに対する誤差」の部分。アーリーストッピングで見るのは、学習に使っていない検証データの誤差である(『Deep Learning』)。学習データの誤差が下がっていても、検証データの誤差は悪化していることがあるので、学習データの誤差だけでは止めどきが分からない。練習問題の点ではなく、初見の模試の点で仕上がりを判断するのと同じである。 要点:アーリーストッピングで見るのは学習に使っていない検証データの誤差で、その誤差が最も小さかった時点のパラメータを使う。
問6
過学習と対策・転移学習|正則化正則化とは、学習データでの誤差ではなく、未知のデータでの誤差を減らすことを目的として学習の方法に加える工夫の総称である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、正則化を、学習データでの誤差ではなく汎化誤差(未知のデータでの誤差)を減らすために学習の方法に加える変更、と定義している。学習データに合わせすぎないよう、あえてブレーキをかける工夫の総称である。丸暗記を防ぐために、答えを書き写すのを禁止して勉強させるようなものである。 要点:正則化は、学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすことを目的として、学習のアルゴリズムに加える変更の総称である。
問7
過学習と対策・転移学習|正則化の目的正則化は、未知のデータでの誤差ではなく、学習データに対する誤差を小さくすることを目的とした工夫である。
答え:×(誤り)
解説
誤り。目的が逆になっている。『Deep Learning』の定義では、正則化は学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすための工夫である。学習データの誤差だけを下げようとすると、かえって丸暗記(過学習)が進む。正則化は、練習の点よりも本番の点を上げるためのものと覚えるとよい。 要点:正則化の目的は、学習データでの誤差ではなく、汎化誤差(未知のデータでの誤差)を減らすことである。
問8
過学習と対策・転移学習|重みに罰則を加える損失関数に重みの大きさに応じた罰則の項を加えて、重みが大きくなりすぎないようにする方法は、正則化の一つである。
答え:○(正しい)
解説
正しい。『Deep Learning』は、損失関数に重みの大きさによる罰則を加えてモデルの表現力を抑える方法を正則化の代表とし、小さい重みを好む重み減衰を例に挙げている。重み(入力ごとの重要度)が極端に大きいと、細かな偶然まで覚え込みやすい。評価で、特定の一項目だけを極端に重く見ないよう上限を設けるのに似ている。 要点:正則化の代表的な方法に、重みなどのパラメータの大きさに応じた罰則の項を損失関数に加え、重みが大きくなりすぎないようにする方法(重み減衰はその例)がある。
問9
過学習と対策・転移学習|ドロップアウトドロップアウトは、学習中にネットワークの一部のユニットを無作為に外しながら学習させる、正則化の方法である。
答え:○(正しい)
解説
正しい。『Deep Learning』は、ドロップアウトでは、データを読み込むたびに入力層や隠れ層のユニット(計算の単位)を無作為に選んで外すとし、多数のネットワークをまとめて学ぶのに近い効果を安く得る正則化だとしている。毎回ランダムに何人かが休んでも仕事が回るように練習しておくと、特定の人に頼りすぎないチームになるのに似ている。 要点:ドロップアウトは、学習中、例を読み込むたびに入力層と隠れ層のユニットを無作為に選んで外し(出力に0を掛け)、多数のネットワークをまとめて学ぶのに近い効果を安く得る正則化の方法である。推論のときはすべてのユニットを使う。
問10
過学習と対策・転移学習|外すのはデータではないドロップアウトは、学習データの一部を無作為に選んで取り除きながら学習する方法である。
答え:×(誤り)
解説
誤り。誤りは「学習データを取り除く」の部分。ドロップアウトで無作為に外すのは、学習データではなく、ネットワークの入力層や隠れ層のユニット(計算の単位)である(『Deep Learning』)。データは減らさず、毎回ネットワークの一部を休ませて学習させる。チームの何人かを日替わりで休ませて練習する、というイメージである。 要点:ドロップアウトで無作為に外すのは、学習データではなく、入力層や隠れ層のユニットである。
問11
過学習と対策・転移学習|データを増やすモデルの汎化をよくする方法として、より多くのデータで学習させることや、手元のデータを変形した新しいデータを作って学習データに足すことがある。
答え:○(正しい)
解説
正しい。『Deep Learning』は、汎化をよくする最もよい方法はより多くのデータで学習することだとし、データが限られるときは手元のデータを変形した新しいデータを作って足す方法(データ拡張)を説明している。たとえば商品の写真が少ないとき、少しずらしたり向きを変えたりした写真を作って学習用に足すのがデータ拡張である。 要点:汎化をよくする最もよい方法は、より多くのデータで学習することで、データが限られるときは、学習データを変形した新しいデータを作って足す(データ拡張)こともある。
問12
過学習と対策・転移学習|転移学習転移学習は、ある課題で学んだことを別の課題に生かす方法で、新しい課題のデータが少なくても学びやすくなることがある。
答え:○(正しい)
解説
正しい。『Deep Learning』は、転移学習を、ある設定で学んだことを別の設定での汎化をよくするために使うこととし、猫と犬を学んだあとにアリとハチを学ぶ例を挙げている。縁や形などの共通の見方を使い回せるので、新しい課題のデータが少なくても学びやすい。英語を学んだ人が、文法の考え方を生かしてフランス語を学ぶのに似ている。 要点:転移学習は、ある設定で学んだことを、別の設定での汎化をよくするために生かす方法で、最初の設定に多くのデータがあれば、次の設定のごく少ない例からでも素早く学べることがある。
問13
過学習と対策・転移学習|一から学び直さない転移学習は、新しい課題ごとに、それまでに学んだ内容を使わずに一から学習し直す方法である。
答え:×(誤り)
解説
誤り。誤りは「一から学習し直す」の部分。転移学習は、ある課題で学んだことを別の課題に生かす方法である。『Deep Learning』は、画像の縁や形のように多くの課題に共通する見方を共有できるため、前の課題で学んだことが役立つとしている。経験者が転職先で、前の職場で身につけた基本の力を使って早く仕事を覚えるのと同じ考え方である。 要点:転移学習は、ある設定で学んだことを別の設定に生かす方法で、新しい課題ごとに一から学び直すのではない。
問14
過学習と対策・転移学習|ファインチューニングファインチューニングは、事前学習を済ませたAIモデルに追加の学習を行い、特定の用途に合わせる手法である。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(第1.2版)は、事後学習(事前学習を終えたモデルへの追加の学習)の主な手法としてファインチューニングを挙げている。ファインチューニングは、作り終えたモデルに用途に合わせた追加の学習をさせることである。一般的な文章を学んだモデルに、自社の問い合わせ対応の記録を追加で学ばせて自社向けに仕上げるのがこれに当たる。 要点:ファインチューニングは、事前学習済みのAIモデルを特定の用途に合わせるために行う追加の学習(事後学習)の主な手法である(AI事業者ガイドライン)。
問15
過学習と対策・転移学習|事前学習との取り違えファインチューニングは、追加の学習ではなく、AIモデルの汎化性能を形作る最初の事前学習のことを指す。
答え:×(誤り)
解説
誤り。誤りは「事前学習のことを指す」の部分。AI事業者ガイドライン(第1.2版)は、学習を、モデルの基本的な力(汎化性能)を作る事前学習と、そのあとの事後学習に分け、ファインチューニングを事後学習の主な手法としている。社員教育にたとえると、事前学習は入社時の幅広い基礎研修、ファインチューニングは配属先での仕事に合わせた追加研修である。 要点:ファインチューニングは事前学習のあとに行う追加の学習(事後学習)の手法で、AIモデルの汎化性能を形作る事前学習そのものではない。
過学習と対策・転移学習の問題を続けて解く
この論点に対応する15問を絞り込んで出題します。