生成AIの実践と活用事例
データ分析・ディープリサーチ・定例レポート
データの整形・分類、集計・可視化、大量の文書からの抽出、複数の情報源の横断調査(ディープリサーチ)、定例レポートの自動化に生成AIを使う場面で、個人データを入れる前の確認、入力データの正確さと集計の検算、RAG の仕組みと検索範囲の制限、参照元の確認、ディープリサーチのレポートにも事実の誤りがありうることと出典の範囲、人の確認を挟む自動化(ワークフロー型エージェント)を押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
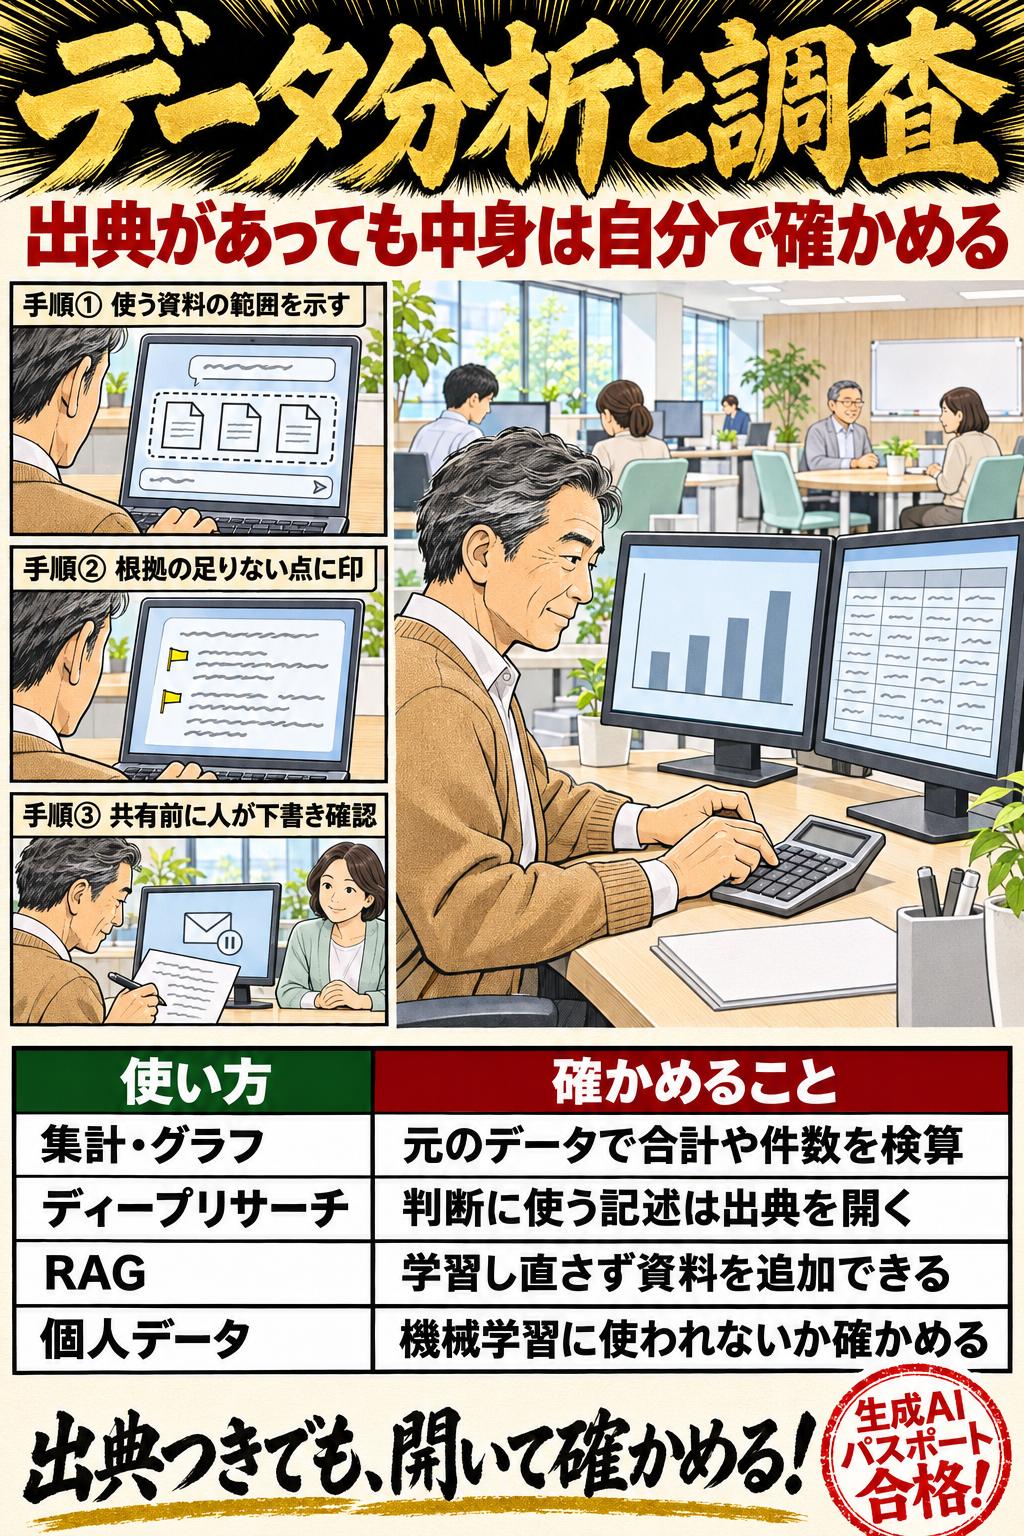
データの整形・分類、集計・可視化、大量の文書からの抽出、複数の情報源の横断調査(ディープリサーチ)、定例レポートの自動化に生成AIを使う場面で、個人データを入れる前の確認、入力データの正確さと集計の検算、RAG の仕組みと検索範囲の制限、参照元の確認、ディープリサーチのレポートにも事実の誤りがありうることと出典の範囲、人の確認を挟む自動化(ワークフロー型エージェント)を押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 15問
データ分析・ディープリサーチ・定例レポート|個人データと機械学習
会社が本人の同意なく個人データを含むプロンプトを生成AIサービスに入れ、そのデータが答えを出す以外の目的に使われると、個人情報保護法に違反するおそれがある。そのような入力をするなら、提供事業者がそのデータを機械学習に使わないことなどを十分に確かめる(個人情報保護委員会の注意喚起)。
この論点の用語
用語集をすべて見る →01データ分析・ディープリサーチ・定例レポートの重要暗記項目
データ分析・ディープリサーチ・定例レポート|個人データと機械学習
会社が本人の同意なく個人データを含むプロンプトを生成AIサービスに入れ、そのデータが答えを出す以外の目的に使われると、個人情報保護法に違反するおそれがある。そのような入力をするなら、提供事業者がそのデータを機械学習に使わないことなどを十分に確かめる(個人情報保護委員会の注意喚起)。
ひっかけ注意「顧客名簿を生成AIで整形・分類させるため、あらかじめ本人の同意を得ずに個人データを入力し、それが応答の出力以外の目的で扱われても、個人情報保護法の問題になることはない」は誤り。 誤り。個人情報保護委員会の注意喚起は、事業者が本人の同意なく個人データを含むプロンプトを入力し、それが応答結果の出力以外の目的で取り扱われる場合、個人情報保護法の規定に違反することとなる可能性があるとしている。整形はデータの書式をそろえること。名簿の表記をそろえてもらうつもりが、入れた名簿がAIの学習に使われていた、ということになりかねない。
データ分析・ディープリサーチ・定例レポート|機械学習に使われないか
会社が、あらかじめ本人の同意を得ずに個人データを含む情報を生成AIサービスに入力する場合は、その前に、提供事業者が入力された個人データを機械学習に使わないことなどを十分に確かめる(個人情報保護委員会の注意喚起)。
データ分析・ディープリサーチ・定例レポート|入力データの正確さ
正確さが求められる場面では、正確で最新のデータを入力する。入れる前に、前提の誤りなど不正確な情報が混じっていないかを利用者自身で確かめる(デジタル庁のガイドライン)。
ひっかけ注意「集計を生成AIに任せる場合は、元のデータに誤りや古い値が混じっていても生成AIが正しい値に補ってくれるので、入力の前にデータを確かめる必要はない」は誤り。 誤り。デジタル庁のガイドラインは、正確性が求められる場面では特に正確かつ最新のデータを入力することとし、不正確な回答につながるため、入力前に不正確な情報がないかを利用者自身でチェックするとしている。AIが誤りを正しい値に直す保証はない。先月の売上の欄に先々月の数字が入ったままなら、集計の計算が正しくても結果は誤りになる。
データ分析・ディープリサーチ・定例レポート|集計結果の検算
生成AIの答えは確率に基づいて作られるため、不正確な内容が混じりうる。集計やグラフの結果は、元のデータで合計や件数を検算するなど、リスクに応じて正確さを確かめてから使う。
データ分析・ディープリサーチ・定例レポート|RAG の仕組み
RAG(検索拡張生成)は、学習済みのAIに、検索で取り出した外部の知識を組み合わせて文章を作る仕組みである(Lewis ほかの論文)。企業では社内文書を検索して答えの精度を高めるのに使われている。
データ分析・ディープリサーチ・定例レポート|再学習なしで追加
RAG は、ファインチューニング(作り終えたAIに追加で学習させること)と違い、AIを学習させ直さずに、参照する資料を追加できる(AI事業者ガイドライン別添)。
ひっかけ注意「RAG で新しい社内文書を参照できるようにするには、文書を足すたびに、その文書でモデルを再学習(ファインチューニング)させる必要がある」は誤り。 誤り。AI事業者ガイドライン(第1.2版)別添は、RAG は通常のファインチューニングと異なり、モデルの再トレーニングを行わずに参照するデータソースを追加できるため、コストの低減も期待されるとしている。規程集に新しい規程を1枚差し込めば、新人を研修し直さなくても新しい規程で答えられるのと同じ。資料の追加と学習のし直しは別のもの。
データ分析・ディープリサーチ・定例レポート|RAG は混ぜるな危険
社外から届いたメールのような外部のデータを RAG の検索対象に入れると、不正な指示(プロンプト)を仕込んだ攻撃メールも取り込まれ、社内情報が外へ漏れるおそれがある。検索の範囲を適切に限ることも検討する(IPA の豆知識)。
データ分析・ディープリサーチ・定例レポート|調べる範囲を示す
複数の資料や手順を使う調査を任せるときは、「これらの資料だけを使う」のように範囲を示し、根拠が足りない点や足りない情報に印を付けさせると、確かめやすい成果物になる(OpenAI の ChatGPT Work の案内)。
覚える数字と、狙われる引っかけ
- ひっかけ「顧客名簿を生成AIで整形・分類させるため、あらかじめ本人の同意を得ずに個人データを入力し、それが応答の出力以外の目的で扱われても、個人情報保護法の問題になることはない」は誤り。誤り。個人情報保護委員会の注意喚起は、事業者が本人の同意なく個人データを含むプロンプトを入力し、それが応答結果の出力以外の目的で取り扱われる場合、個人情報保護法の規定に違反することとなる可能性があるとしている。整形はデータの書式をそろえること。名簿の表記をそろえてもらうつもりが、入れた名簿がAIの学習に使われていた、ということになりかねない。
- ひっかけ「集計を生成AIに任せる場合は、元のデータに誤りや古い値が混じっていても生成AIが正しい値に補ってくれるので、入力の前にデータを確かめる必要はない」は誤り。誤り。デジタル庁のガイドラインは、正確性が求められる場面では特に正確かつ最新のデータを入力することとし、不正確な回答につながるため、入力前に不正確な情報がないかを利用者自身でチェックするとしている。AIが誤りを正しい値に直す保証はない。先月の売上の欄に先々月の数字が入ったままなら、集計の計算が正しくても結果は誤りになる。
- ひっかけ「RAG で新しい社内文書を参照できるようにするには、文書を足すたびに、その文書でモデルを再学習(ファインチューニング)させる必要がある」は誤り。誤り。AI事業者ガイドライン(第1.2版)別添は、RAG は通常のファインチューニングと異なり、モデルの再トレーニングを行わずに参照するデータソースを追加できるため、コストの低減も期待されるとしている。規程集に新しい規程を1枚差し込めば、新人を研修し直さなくても新しい規程で答えられるのと同じ。資料の追加と学習のし直しは別のもの。
- ひっかけ「複数の情報源を横断してまとめたAIの調査レポートは、参照元が示されていれば、その参照元の内容と記述が合っているかを確かめなくてもよい」は誤り。誤り。デジタル庁のガイドラインは、AI生成物の正確性や根拠・事実関係を必要な範囲内でリスクに応じて確認するとし、IPA の10大脅威 2026 も、生成AIは架空の情報を事実のように作ることがあるとして生成結果の精査を求めている。ディープリサーチ(多くの情報源を横断して調べ、まとめさせる使い方)でも同じ。参考文献の欄があっても、開くと別のことが書いてある、ということが起こりうる。
- ひっかけ「定例レポートを自動で作る仕組みを組んだら、出力の適切さを人が判断せずに、そのまま社外へ配信する業務設計にしても、リスクは低い」は誤り。誤り。デジタル庁のガイドラインは、生成AIの出力は必ずしも正しいとは限らないため、出力を人が判断せずにそのまま使う業務設計はリスクが高くなるとしている。AI事業者ガイドラインも、人間の判断を介在させることで予期せぬ事故を防げるとする。自動の仕組みは、誤りも自動でくり返す。取引先向けの月報なら、一度の誤った数字が毎月そのまま届いてしまう。
- ひっかけ「OpenAI は、ディープリサーチは数百の情報源を分析して出典を付けるため、レポートで事実を誤ったり誤った推論をしたりすることはないとしている」は誤り。誤り。OpenAI の発表は、ディープリサーチの限界として、応答の中で事実を誤ること(ハルシネーション)や誤った推論をすることがあると書いている。情報源が多く出典が付いていても、誤りがなくなるわけではない。ハルシネーションは「もっともらしい作り話」のこと。分厚い調査報告書でも、肝心の数字の出典を開いたら別の年の数字だった、ということがある。判断に使う記述は元の情報で確かめる。
- ひっかけ「2026年11月時点の OpenAI の API ガイドによると、Web 検索を使った回答の中に示される出典(引用)は、モデルが検索で参照したURLをすべて並べたものである」は誤り。誤り。OpenAI の Web 検索のガイド(2026年11月時点)は、回答の中の出典は最も関係の深い参照だけを示し、モデルが参照したURLの全体は別の一覧(sources)で返るとし、参照した情報源の数は出典の数より多いことがよくあるとしている。出典は、根拠として名前を挙げた資料のこと。報告書の参考文献欄に載るのは、担当者が目を通した資料の一部だけ、というのと同じ。
02試験で正誤を分けるチェック順
- 1会社が本人の同意なく個人データを含むプロンプトを生成AIサービスに入れ、そのデータが答えを出す以外の目的に使われると、個人情報保護法に違反するおそれがある。そのような入力をするなら、提供事業者がそのデータを機械学習に使わないことなどを十分に確かめる(個人情報保護委員会の注意喚起)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2会社が、あらかじめ本人の同意を得ずに個人データを含む情報を生成AIサービスに入力する場合は、その前に、提供事業者が入力された個人データを機械学習に使わないことなどを十分に確かめる(個人情報保護委員会の注意喚起)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3正確さが求められる場面では、正確で最新のデータを入力する。入れる前に、前提の誤りなど不正確な情報が混じっていないかを利用者自身で確かめる(デジタル庁のガイドライン)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4生成AIの答えは確率に基づいて作られるため、不正確な内容が混じりうる。集計やグラフの結果は、元のデータで合計や件数を検算するなど、リスクに応じて正確さを確かめてから使う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5RAG(検索拡張生成)は、学習済みのAIに、検索で取り出した外部の知識を組み合わせて文章を作る仕組みである(Lewis ほかの論文)。企業では社内文書を検索して答えの精度を高めるのに使われている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6RAG は、ファインチューニング(作り終えたAIに追加で学習させること)と違い、AIを学習させ直さずに、参照する資料を追加できる(AI事業者ガイドライン別添)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7社外から届いたメールのような外部のデータを RAG の検索対象に入れると、不正な指示(プロンプト)を仕込んだ攻撃メールも取り込まれ、社内情報が外へ漏れるおそれがある。検索の範囲を適切に限ることも検討する(IPA の豆知識)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8複数の資料や手順を使う調査を任せるときは、「これらの資料だけを使う」のように範囲を示し、根拠が足りない点や足りない情報に印を付けさせると、確かめやすい成果物になる(OpenAI の ChatGPT Work の案内)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9生成AIが参照元を示していても、その参照元の中身と記述が合っているかは、リスクに応じて利用者が確かめる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10定期的な更新を生成AIに任せるときも、共有する前に下書きを人が確かめる段取りを組み込む(OpenAI の ChatGPT Work の案内の例)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11AI事業者ガイドライン(別添)は、利用者が業務の手順に沿った流れ(ワークフロー)を自分で組み、その流れに従って自律的に動くAIエージェントを作れるサービスを、AIシステム・サービスの例に挙げている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12生成AIの出力が適切かを人が判断せずにそのまま使う業務の組み立ては、リスクが高くなると考えられる。人の判断を挟むことで、予期しない事故を防げる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13ディープリサーチは、指示を受けたAIが多数のオンラインの情報源を自ら探し、分析・統合して、出典つきのレポートを作る使い方である。OpenAI は2025年2月に ChatGPT の機能(エージェント)として発表した。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14ディープリサーチのレポートにも、事実の誤り(ハルシネーション)や誤った推論が含まれることがある。OpenAI 自身が限界としてこれを挙げている。判断に使う記述は出典を開いて確かめる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 152026年11月時点の OpenAI の API の Web 検索では、回答の中に示す出典(引用)は最も関係の深いものに絞られ、検索で実際に参照したURLの一覧(sources)は別に返る。参照した情報源の数は、出典の数より多いことがよくある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
データ分析・ディープリサーチ・定例レポートの○×一問一答
1/8問解答 0・正解 0
生成AIの実践と活用事例
データ分析・ディープリサーチ・定例レポート|個人データと機械学習
顧客名簿を生成AIで整形・分類させるため、あらかじめ本人の同意を得ずに個人データを入力し、それが応答の出力以外の目的で扱われても、個人情報保護法の問題になることはない。
データ分析・ディープリサーチ・定例レポートの○×一問一答15問|問題と解説
この論点で収録している15問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
データ分析・ディープリサーチ・定例レポート|個人データと機械学習顧客名簿を生成AIで整形・分類させるため、あらかじめ本人の同意を得ずに個人データを入力し、それが応答の出力以外の目的で扱われても、個人情報保護法の問題になることはない。
答え:×(誤り)
解説
誤り。誤り。個人情報保護委員会の注意喚起は、事業者が本人の同意なく個人データを含むプロンプトを入力し、それが応答結果の出力以外の目的で取り扱われる場合、個人情報保護法の規定に違反することとなる可能性があるとしている。整形はデータの書式をそろえること。名簿の表記をそろえてもらうつもりが、入れた名簿がAIの学習に使われていた、ということになりかねない。 要点:会社が本人の同意なく個人データを含むプロンプトを生成AIサービスに入れ、そのデータが答えを出す以外の目的に使われると、個人情報保護法に違反するおそれがある。そのような入力をするなら、提供事業者がそのデータを機械学習に使わないことなどを十分に確かめる(個人情報保護委員会の注意喚起)。
問2
データ分析・ディープリサーチ・定例レポート|機械学習に使われないかあらかじめ本人の同意を得ずに、個人データを含む表を生成AIサービスに入力して整形する場合は、そのサービスを提供する事業者が、入力した個人データを機械学習に利用しないことなどを十分に確かめる。
答え:○(正しい)
解説
正しい。個人情報保護委員会の注意喚起は、事業者があらかじめ本人の同意を得ずに個人データを含むプロンプトを入力する場合には、提供事業者がその個人データを機械学習に利用しないこと等を十分に確認するよう求めている。機械学習は、データからAIが規則を学ぶこと。入れたデータが学習に使われると、別の人への答えに混ざって出てくるおそれもある。入力の前に、契約や設定で「入力は学習に使わない」とされているかを確かめる。 要点:会社が、あらかじめ本人の同意を得ずに個人データを含む情報を生成AIサービスに入力する場合は、その前に、提供事業者が入力された個人データを機械学習に使わないことなどを十分に確かめる(個人情報保護委員会の注意喚起)。
問3
データ分析・ディープリサーチ・定例レポート|入力データの正確さ集計を生成AIに任せる場合は、元のデータに誤りや古い値が混じっていても生成AIが正しい値に補ってくれるので、入力の前にデータを確かめる必要はない。
答え:×(誤り)
解説
誤り。誤り。デジタル庁のガイドラインは、正確性が求められる場面では特に正確かつ最新のデータを入力することとし、不正確な回答につながるため、入力前に不正確な情報がないかを利用者自身でチェックするとしている。AIが誤りを正しい値に直す保証はない。先月の売上の欄に先々月の数字が入ったままなら、集計の計算が正しくても結果は誤りになる。 要点:正確さが求められる場面では、正確で最新のデータを入力する。入れる前に、前提の誤りなど不正確な情報が混じっていないかを利用者自身で確かめる(デジタル庁のガイドライン)。
問4
データ分析・ディープリサーチ・定例レポート|集計結果の検算生成AIに表データを集計させてグラフにした結果を報告に使うときは、元のデータで合計や件数を検算するなど、正確性を確かめてから使う。
答え:○(正しい)
解説
正しい。デジタル庁のガイドラインは、正確性や根拠・事実関係を必要な範囲内でリスクに応じて確認するとし、個人情報保護委員会の注意喚起も、生成AIの応答は確率的な相関関係に基づいて作られるため不正確な内容が含まれうるとしている。検算は、別のやり方で計算し直して合っているか確かめること。グラフの合計が元の表の合計と一致するかを電卓で一度見るだけでも、取り違えに気づける。 要点:生成AIの答えは確率に基づいて作られるため、不正確な内容が混じりうる。集計やグラフの結果は、元のデータで合計や件数を検算するなど、リスクに応じて正確さを確かめてから使う。
問5
データ分析・ディープリサーチ・定例レポート|RAG の仕組みRAG(検索拡張生成)は、学習済みのモデルに、検索で取り出した外部の知識を組み合わせて文章を生成する仕組みである。
答え:○(正しい)
解説
正しい。RAG を提案した論文は、RAG を事前学習済みのモデル(パラメトリックなメモリ)と、検索で使う外部の知識(非パラメトリックなメモリ)を組み合わせて文章を生成するモデルとしている。AI事業者ガイドラインの別添も、企業で社内文書などを検索して回答の精度を高めるのに使われているとする。社内の規程集を開いて該当ページを確かめてから答える新人のようなもの。 要点:RAG(検索拡張生成)は、学習済みのAIに、検索で取り出した外部の知識を組み合わせて文章を作る仕組みである(Lewis ほかの論文)。企業では社内文書を検索して答えの精度を高めるのに使われている。
問6
データ分析・ディープリサーチ・定例レポート|再学習なしで追加RAG で新しい社内文書を参照できるようにするには、文書を足すたびに、その文書でモデルを再学習(ファインチューニング)させる必要がある。
答え:×(誤り)
解説
誤り。誤り。AI事業者ガイドライン(第1.2版)別添は、RAG は通常のファインチューニングと異なり、モデルの再トレーニングを行わずに参照するデータソースを追加できるため、コストの低減も期待されるとしている。規程集に新しい規程を1枚差し込めば、新人を研修し直さなくても新しい規程で答えられるのと同じ。資料の追加と学習のし直しは別のもの。 要点:RAG は、ファインチューニング(作り終えたAIに追加で学習させること)と違い、AIを学習させ直さずに、参照する資料を追加できる(AI事業者ガイドライン別添)。
問7
データ分析・ディープリサーチ・定例レポート|RAG は混ぜるな危険社内文書とあわせて社外から届いたメールも RAG の検索の対象にすると、メールに仕込まれた不正なプロンプトを取り込んで社内情報が外へ漏れるおそれがあるため、検索の範囲を適切に制限することも検討する。
答え:○(正しい)
解説
正しい。IPA の「AI利用者のためのセキュリティ豆知識」は、外部由来のメールが RAG で検索されると不正プロンプトを含む攻撃メールも取り込まれ、社内文書と同時に読み込まれると社内情報が社外に流出する可能性があるとして、検索範囲の制限も検討するよう勧めている。社内資料の棚に、差出人不明の手紙を一緒に並べておき、新人がそこに書かれた「この資料を外へ送れ」に従ってしまうようなもの。 要点:社外から届いたメールのような外部のデータを RAG の検索対象に入れると、不正な指示(プロンプト)を仕込んだ攻撃メールも取り込まれ、社内情報が外へ漏れるおそれがある。検索の範囲を適切に限ることも検討する(IPA の豆知識)。
問8
データ分析・ディープリサーチ・定例レポート|調べる範囲を示す生成AIに複数の資料を横断して調べさせるときは、「この資料だけを使う」のように使う情報源の範囲を示し、根拠が足りない点や不足している情報に印を付けさせると、確かめやすい成果物になる。
答え:○(正しい)
解説
正しい。OpenAI の ChatGPT Work の案内(2026年11月時点)は、作業の範囲を絞る境界の例に「これらの情報源だけを使う」を挙げ、比較表を作らせる例でも、リスクや足りない情報に印を付けさせている。調査を外部に頼むときに「この3社の公開資料だけで」「分からない所は空欄にして印を」と伝えると、どこまでが確かな情報か一目で分かるのと同じ。 要点:複数の資料や手順を使う調査を任せるときは、「これらの資料だけを使う」のように範囲を示し、根拠が足りない点や足りない情報に印を付けさせると、確かめやすい成果物になる(OpenAI の ChatGPT Work の案内)。
問9
データ分析・ディープリサーチ・定例レポート|参照元があっても確認複数の情報源を横断してまとめたAIの調査レポートは、参照元が示されていれば、その参照元の内容と記述が合っているかを確かめなくてもよい。
答え:×(誤り)
解説
誤り。誤り。デジタル庁のガイドラインは、AI生成物の正確性や根拠・事実関係を必要な範囲内でリスクに応じて確認するとし、IPA の10大脅威 2026 も、生成AIは架空の情報を事実のように作ることがあるとして生成結果の精査を求めている。ディープリサーチ(多くの情報源を横断して調べ、まとめさせる使い方)でも同じ。参考文献の欄があっても、開くと別のことが書いてある、ということが起こりうる。 要点:生成AIが参照元を示していても、その参照元の中身と記述が合っているかは、リスクに応じて利用者が確かめる。
問10
データ分析・ディープリサーチ・定例レポート|定例は下書きで確認毎週の定例レポートを生成AIに自動で作らせる場合も、関係者に共有する前に下書きを人が確かめる段取りを組み込むとよい。
答え:○(正しい)
解説
正しい。OpenAI の ChatGPT Work の案内(2026年11月時点)は、定期的な更新を任せる例のプロンプトで、会議のアジェンダを更新したうえで「共有する前に下書きを送って」と指示し、重要な操作は承認でき、途中で方向も変えられるとしている。毎週の売上報告をAIがまとめても、部長に送る前に担当者がひと目通す。間違いが毎週くり返し配られるのを防げる。 要点:定期的な更新を生成AIに任せるときも、共有する前に下書きを人が確かめる段取りを組み込む(OpenAI の ChatGPT Work の案内の例)。
問11
データ分析・ディープリサーチ・定例レポート|ワークフロー型エージェントAI事業者ガイドライン(別添)は、利用者が業務の手順に沿ったワークフローを独自に組み、その流れに従って自律的に動作するAIエージェントを作成できるサービスを、AIシステム・サービスの例に挙げている。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(第1.2版)別添の例に、利用者が業務プロセスに沿ったワークフローを独自に構築し、それに従って自律的に動作するAIエージェントを作れる「AIエージェント(ワークフロー)作成サービス」がある。AIエージェントは、目的に向けて自分で手順を進めるAIのこと。「データを集める→集計する→報告文を書く」という流れ図を決めておき、その順にAIに進めさせるイメージ。 要点:AI事業者ガイドライン(別添)は、利用者が業務の手順に沿った流れ(ワークフロー)を自分で組み、その流れに従って自律的に動くAIエージェントを作れるサービスを、AIシステム・サービスの例に挙げている。
問12
データ分析・ディープリサーチ・定例レポート|判断せずに使う設計定例レポートを自動で作る仕組みを組んだら、出力の適切さを人が判断せずに、そのまま社外へ配信する業務設計にしても、リスクは低い。
答え:×(誤り)
解説
誤り。誤り。デジタル庁のガイドラインは、生成AIの出力は必ずしも正しいとは限らないため、出力を人が判断せずにそのまま使う業務設計はリスクが高くなるとしている。AI事業者ガイドラインも、人間の判断を介在させることで予期せぬ事故を防げるとする。自動の仕組みは、誤りも自動でくり返す。取引先向けの月報なら、一度の誤った数字が毎月そのまま届いてしまう。 要点:生成AIの出力が適切かを人が判断せずにそのまま使う業務の組み立ては、リスクが高くなると考えられる。人の判断を挟むことで、予期しない事故を防げる。
問13
データ分析・ディープリサーチ・定例レポート|ディープリサーチとはOpenAI は2025年2月、ChatGPT のディープリサーチを、指示を受けて多数のオンラインの情報源を自ら探し、分析・統合して、出典を付けたレポートを作るエージェントとして発表した。
答え:○(正しい)
解説
正しい。OpenAI の発表(2025年2月)は、ディープリサーチを、プロンプトを受けて数百のオンラインの情報源を探し、分析・統合して包括的なレポートを作る、独立して作業するエージェントとし、レポートには出典が付くとしている。エージェントは、目的に向けて自分で手順を進めるAIのこと。調べものを頼まれた部下が、資料を集めて読み比べ、参考文献つきの報告書にまとめて持ってくるイメージ。 要点:ディープリサーチは、指示を受けたAIが多数のオンラインの情報源を自ら探し、分析・統合して、出典つきのレポートを作る使い方である。OpenAI は2025年2月に ChatGPT の機能(エージェント)として発表した。
問14
データ分析・ディープリサーチ・定例レポート|レポートにも誤りはありうるOpenAI は、ディープリサーチは数百の情報源を分析して出典を付けるため、レポートで事実を誤ったり誤った推論をしたりすることはないとしている。
答え:×(誤り)
解説
誤り。誤り。OpenAI の発表は、ディープリサーチの限界として、応答の中で事実を誤ること(ハルシネーション)や誤った推論をすることがあると書いている。情報源が多く出典が付いていても、誤りがなくなるわけではない。ハルシネーションは「もっともらしい作り話」のこと。分厚い調査報告書でも、肝心の数字の出典を開いたら別の年の数字だった、ということがある。判断に使う記述は元の情報で確かめる。 要点:ディープリサーチのレポートにも、事実の誤り(ハルシネーション)や誤った推論が含まれることがある。OpenAI 自身が限界としてこれを挙げている。判断に使う記述は出典を開いて確かめる。
問15
データ分析・ディープリサーチ・定例レポート|出典と参照した情報源2026年11月時点の OpenAI の API ガイドによると、Web 検索を使った回答の中に示される出典(引用)は、モデルが検索で参照したURLをすべて並べたものである。
答え:×(誤り)
解説
誤り。誤り。OpenAI の Web 検索のガイド(2026年11月時点)は、回答の中の出典は最も関係の深い参照だけを示し、モデルが参照したURLの全体は別の一覧(sources)で返るとし、参照した情報源の数は出典の数より多いことがよくあるとしている。出典は、根拠として名前を挙げた資料のこと。報告書の参考文献欄に載るのは、担当者が目を通した資料の一部だけ、というのと同じ。 要点:2026年11月時点の OpenAI の API の Web 検索では、回答の中に示す出典(引用)は最も関係の深いものに絞られ、検索で実際に参照したURLの一覧(sources)は別に返る。参照した情報源の数は、出典の数より多いことがよくある。
データ分析・ディープリサーチ・定例レポートの問題を続けて解く
この論点に対応する15問を絞り込んで出題します。