生成AI
拡散モデル・基盤モデル・マルチモーダルモデル
拡散モデルは、データに少しずつノイズを加える拡散過程と、その逆をたどってノイズから画像を作る逆拡散過程からなり、潜在拡散モデルは画像を圧縮した潜在空間で計算を軽くしました。基盤モデルは多くの個別のモデルを生み出す土台で、マルチモーダルモデルは2つ以上のデータの種類(モダリティ)を統合して扱う、と押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
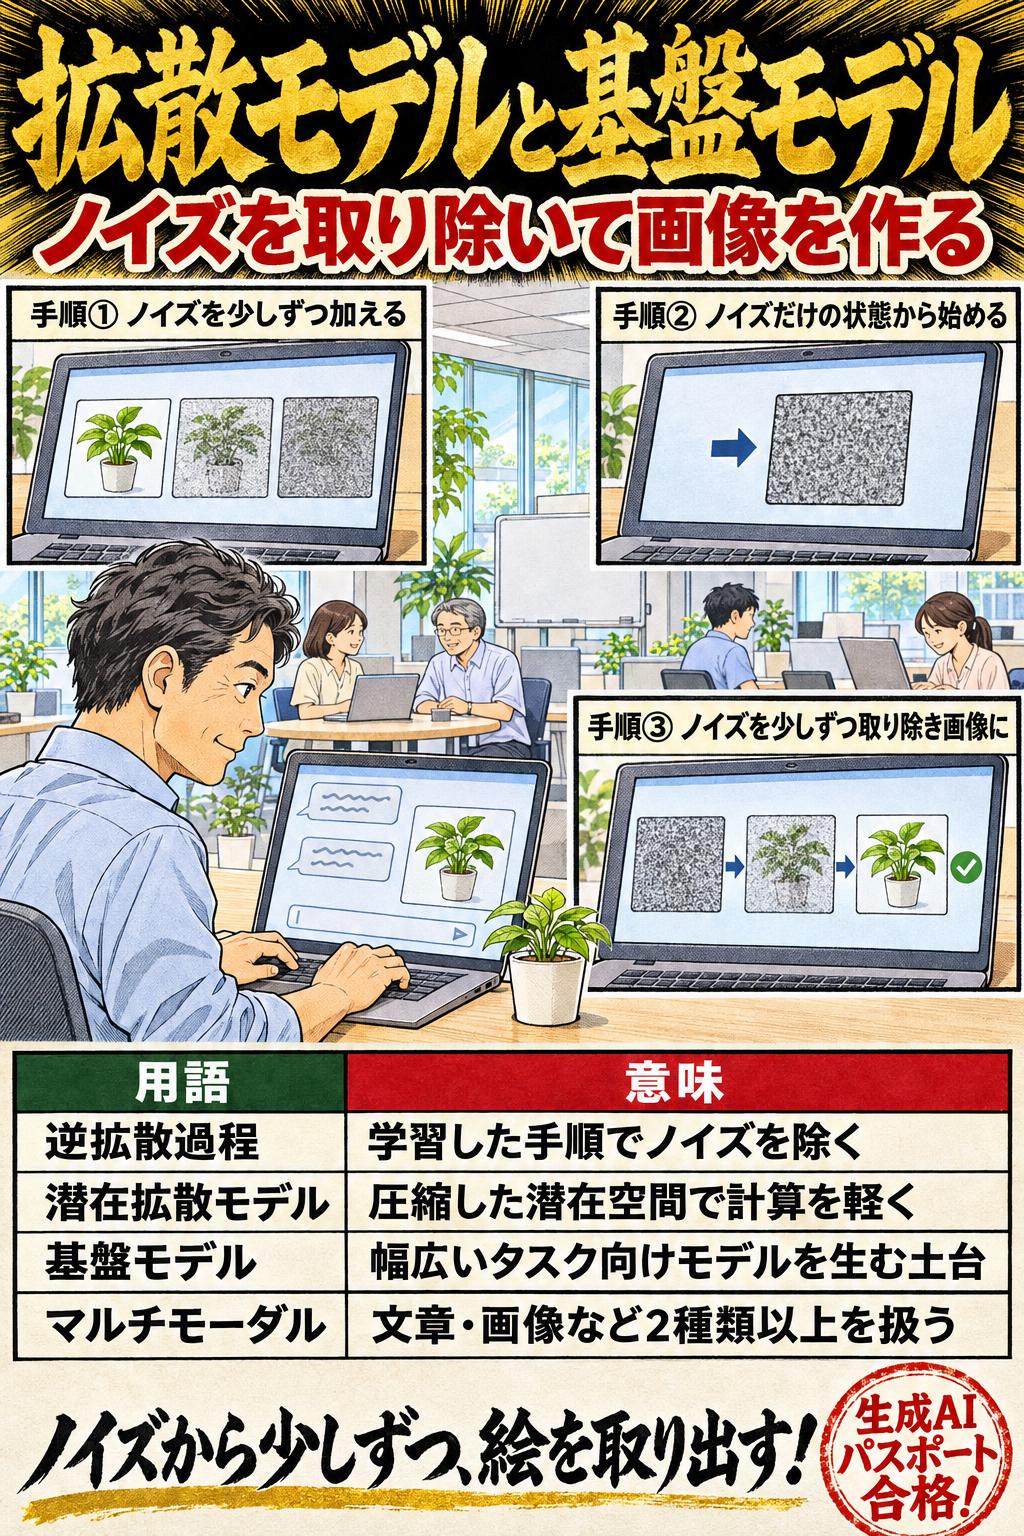
拡散モデルは、データに少しずつノイズを加える拡散過程と、その逆をたどってノイズから画像を作る逆拡散過程からなり、潜在拡散モデルは画像を圧縮した潜在空間で計算を軽くしました。基盤モデルは多くの個別のモデルを生み出す土台で、マルチモーダルモデルは2つ以上のデータの種類(モダリティ)を統合して扱う、と押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 13問
拡散モデル・基盤モデル・マルチモーダルモデル|拡散過程
拡散モデルの拡散過程(前向きの過程)は、データにノイズを少しずつ加えていき、最後には元の信号が分からなくなるまで進める。
比較して覚える
拡散モデルの拡散過程と逆拡散過程(DDPM の論文の場合)
DDPM の論文の拡散モデルの2つの過程を並べます。ノイズを加えるのはどちらか、学習するのはどちらか、画像を生成するときに使うのはどちらか、潜在拡散モデルはどこで動かすかの取り違えをこの表で切り分けます。
| 事由 | 拡散過程(前向き) | 逆拡散過程 |
|---|---|---|
| 何をするか | データにノイズを少しずつ加え、元の信号が分からなくなるまで進める | ノイズを少しずつ取り除き、データ(画像など)を作る |
| 学習するか | しない(DDPM の論文の実装では決まった手順で固定) | する(拡散過程を逆にたどるよう学習する) |
| 生成のときの出発点 | —(生成には使わない向き) | ノイズだけの状態から始める |
| 潜在拡散モデル(LDM)での場所 | 画像をエンコーダで圧縮した潜在空間で行う | 潜在空間で行い、最後にデコーダで画像に戻す |
| 身近なたとえ | 写真に砂嵐を少しずつ重ねていく | 砂嵐の画面から少しずつ乱れを拭き取って絵を浮かび上がらせる |
何をするか
- 拡散過程(前向き)
- データにノイズを少しずつ加え、元の信号が分からなくなるまで進める
- 逆拡散過程
- ノイズを少しずつ取り除き、データ(画像など)を作る
学習するか
- 拡散過程(前向き)
- しない(DDPM の論文の実装では決まった手順で固定)
- 逆拡散過程
- する(拡散過程を逆にたどるよう学習する)
生成のときの出発点
- 拡散過程(前向き)
- —(生成には使わない向き)
- 逆拡散過程
- ノイズだけの状態から始める
潜在拡散モデル(LDM)での場所
- 拡散過程(前向き)
- 画像をエンコーダで圧縮した潜在空間で行う
- 逆拡散過程
- 潜在空間で行い、最後にデコーダで画像に戻す
身近なたとえ
- 拡散過程(前向き)
- 写真に砂嵐を少しずつ重ねていく
- 逆拡散過程
- 砂嵐の画面から少しずつ乱れを拭き取って絵を浮かび上がらせる
この論点の用語
用語集をすべて見る →01拡散モデル・基盤モデル・マルチモーダルモデルの重要暗記項目
拡散モデル・基盤モデル・マルチモーダルモデル|拡散過程
拡散モデルの拡散過程(前向きの過程)は、データにノイズを少しずつ加えていき、最後には元の信号が分からなくなるまで進める。
拡散モデル・基盤モデル・マルチモーダルモデル|逆拡散過程で生成
画像の生成は、ノイズだけの状態から始め、学習した逆拡散過程でノイズを少しずつ取り除いて行う。
拡散モデル・基盤モデル・マルチモーダルモデル|学習するのはどちら
DDPM では、ノイズを加える拡散過程は決まった手順(固定)で、ノイズを取り除く逆拡散過程のほうを学習する。
ひっかけ注意「拡散モデルで学習するのは、データにノイズを加えていく拡散過程のほうであり、ノイズを取り除く逆拡散過程は学習しない固定の手順である」は誤り。 学習するものと固定のものが逆である。DDPM では、ノイズを加える拡散過程は決まった手順で固定され、ノイズを取り除く逆拡散過程の手順を学習する。ノイズを足すのは誰でもできる簡単な作業だが、乱れた画像から元の絵を取り戻すのは難しいので、そちらをモデルに練習させる、と考えると覚えやすい。
拡散モデル・基盤モデル・マルチモーダルモデル|潜在拡散モデル
ピクセル(画素)の空間で直接動く拡散モデルは計算が重い。潜在拡散モデル(LDM)は、オートエンコーダで画像を圧縮した潜在空間で拡散モデルを動かし、品質を保ちながら計算量を大きく減らした。
拡散モデル・基盤モデル・マルチモーダルモデル|どこで動かすか
潜在拡散モデルは、ピクセルの空間ではなく、学習済みのオートエンコーダが作る潜在空間で拡散モデルを動かす。
ひっかけ注意「潜在拡散モデルは、画像を圧縮せずにピクセルの空間で直接ノイズの除去を繰り返すことで、計算量を減らしながら高い解像度を実現した」は誤り。 潜在拡散モデルは、ピクセルの空間で直接ではなく、画像を圧縮した潜在空間で拡散モデルを動かす。論文は、ピクセルの空間で動く拡散モデルは学習・生成の計算が重いことを、この工夫の理由に挙げている。潜在空間とは、画像の特徴を少ない数値に詰め込んだ「要約版の空間」のことで、写真をそのまま扱うより、要点メモを扱うほうが軽いのと同じである。
拡散モデル・基盤モデル・マルチモーダルモデル|エンコーダとデコーダ
潜在拡散モデルでは、エンコーダが画像を潜在表現(圧縮した数値の並び)に変え、デコーダが潜在表現から画像を復元する。
拡散モデル・基盤モデル・マルチモーダルモデル|基盤モデルとは
大規模言語モデルに代表される基盤モデル(Foundation Model)は、様々なサービスを支える個別のモデルを生み出す中核の技術基盤で、下流の幅広いタスクに合わせたモデルを派生させられる。
拡散モデル・基盤モデル・マルチモーダルモデル|1つのタスク専用ではない
基盤モデルは、1つのタスク専用ではなく、幅広い下流のタスクに合わせた個別のモデルを生み出す土台である。
ひっかけ注意「基盤モデルは、1つの決まったタスクだけを高い精度でこなすように作られた専用のモデルであり、ほかのタスクに合わせて派生させることは想定されていない」は誤り。 AI事業者ガイドラインは、基盤モデルを、下流の幅広いタスクに適応させた個別のモデルを生み出すコアの技術基盤としている。1つのタスク専用のモデルではない。たとえば同じ大規模言語モデルをもとに、問い合わせ対応のチャットボットにも、議事録の要約の仕組みにも仕立てられる。この「使い回せる土台」であることが基盤モデルの特徴である。
覚える数字と、狙われる引っかけ
- ひっかけ「拡散モデルで学習するのは、データにノイズを加えていく拡散過程のほうであり、ノイズを取り除く逆拡散過程は学習しない固定の手順である」は誤り。学習するものと固定のものが逆である。DDPM では、ノイズを加える拡散過程は決まった手順で固定され、ノイズを取り除く逆拡散過程の手順を学習する。ノイズを足すのは誰でもできる簡単な作業だが、乱れた画像から元の絵を取り戻すのは難しいので、そちらをモデルに練習させる、と考えると覚えやすい。
- ひっかけ「潜在拡散モデルは、画像を圧縮せずにピクセルの空間で直接ノイズの除去を繰り返すことで、計算量を減らしながら高い解像度を実現した」は誤り。潜在拡散モデルは、ピクセルの空間で直接ではなく、画像を圧縮した潜在空間で拡散モデルを動かす。論文は、ピクセルの空間で動く拡散モデルは学習・生成の計算が重いことを、この工夫の理由に挙げている。潜在空間とは、画像の特徴を少ない数値に詰め込んだ「要約版の空間」のことで、写真をそのまま扱うより、要点メモを扱うほうが軽いのと同じである。
- ひっかけ「基盤モデルは、1つの決まったタスクだけを高い精度でこなすように作られた専用のモデルであり、ほかのタスクに合わせて派生させることは想定されていない」は誤り。AI事業者ガイドラインは、基盤モデルを、下流の幅広いタスクに適応させた個別のモデルを生み出すコアの技術基盤としている。1つのタスク専用のモデルではない。たとえば同じ大規模言語モデルをもとに、問い合わせ対応のチャットボットにも、議事録の要約の仕組みにも仕立てられる。この「使い回せる土台」であることが基盤モデルの特徴である。
- ひっかけ「モダリティとは、生成AIのモデルの大きさ(パラメータの数)を表す言葉で、マルチモーダルモデルとはパラメータの数が非常に多いモデルを指す」は誤り。モダリティはモデルの大きさではなく、データの種類(テキスト・音声・画像・動画・センサ情報など)を指す。マルチモーダルモデルは、2つ以上の異なるモダリティの情報を統合して扱えるモデルである。人にたとえると、目で見て耳で聞いて文字も読める、という「感覚の種類の多さ」の話で、頭の大きさの話ではない。
- ひっかけ「AI事業者ガイドラインが引用する広島AIプロセスの定義では、「高度なAIシステム」に基盤モデルは含まれず、生成AIシステムだけを指す」は誤り。定義は「最先端の基盤モデル及び生成AIシステムを含む、最も高度なAIシステム」であり、基盤モデルも含まれる。広島AIプロセスは、G7 が始めた高度な AI のルールづくりの枠組みのこと。土台の基盤モデルと、それを組み込んだ生成AIのサービスの両方が、ルールの対象として意識されている、と覚えるとよい。
02試験で正誤を分けるチェック順
- 1拡散モデルの拡散過程(前向きの過程)は、データにノイズを少しずつ加えていき、最後には元の信号が分からなくなるまで進める。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2画像の生成は、ノイズだけの状態から始め、学習した逆拡散過程でノイズを少しずつ取り除いて行う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3DDPM では、ノイズを加える拡散過程は決まった手順(固定)で、ノイズを取り除く逆拡散過程のほうを学習する。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4ピクセル(画素)の空間で直接動く拡散モデルは計算が重い。潜在拡散モデル(LDM)は、オートエンコーダで画像を圧縮した潜在空間で拡散モデルを動かし、品質を保ちながら計算量を大きく減らした。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5潜在拡散モデルは、ピクセルの空間ではなく、学習済みのオートエンコーダが作る潜在空間で拡散モデルを動かす。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6潜在拡散モデルでは、エンコーダが画像を潜在表現(圧縮した数値の並び)に変え、デコーダが潜在表現から画像を復元する。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7大規模言語モデルに代表される基盤モデル(Foundation Model)は、様々なサービスを支える個別のモデルを生み出す中核の技術基盤で、下流の幅広いタスクに合わせたモデルを派生させられる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8基盤モデルは、1つのタスク専用ではなく、幅広い下流のタスクに合わせた個別のモデルを生み出す土台である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 92021年以降、基盤モデルの台頭で、特定の分野だけに特化しない汎用的な AI の開発が進み、画像や文章を生成する生成AIも普及しつつある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10マルチモーダルな生成AIは、テキスト・音声・画像・動画・センサ情報など、2つ以上の異なるモダリティ(データの種類)から情報を集め、統合して処理できる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11モダリティとは、テキスト・音声・画像・動画などのデータの種類のことである。モデルの大きさを表す言葉ではない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12マルチモーダルな生成AIは比較的容易に精巧な生成物を作れるため、誤解や偏見を助長するおそれや他者の知的財産権を侵害するおそれに留意し、人間の判断を介在させる等の対策をとる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13「高度なAIシステム」は、最先端の基盤モデルと生成AIシステムを含む、最も高度な AI システムを指す(広島AIプロセスの定義をAI事業者ガイドラインが引用)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
拡散モデル・基盤モデル・マルチモーダルモデルの○×一問一答
1/8問解答 0・正解 0
生成AI
拡散モデル・基盤モデル・マルチモーダルモデル|拡散過程
拡散モデルの拡散過程では、元の画像などのデータにノイズを少しずつ加えていき、最後には元の信号が分からない状態にする。
拡散モデル・基盤モデル・マルチモーダルモデルの○×一問一答13問|問題と解説
この論点で収録している13問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
拡散モデル・基盤モデル・マルチモーダルモデル|拡散過程拡散モデルの拡散過程では、元の画像などのデータにノイズを少しずつ加えていき、最後には元の信号が分からない状態にする。
答え:○(正しい)
解説
正しい。DDPM の論文は、拡散過程を、決めた手順(分散のスケジュール)に従ってデータにガウスノイズ(ランダムな細かい乱れ)を少しずつ加えていく過程とし、信号が失われるまで続けると説明している。写真の上に砂嵐を少しずつ重ねていき、最後は何が写っていたか分からない砂嵐だけの画面になる様子にあたる。 要点:拡散モデルの拡散過程(前向きの過程)は、データにノイズを少しずつ加えていき、最後には元の信号が分からなくなるまで進める。
問2
拡散モデル・基盤モデル・マルチモーダルモデル|逆拡散過程で生成拡散モデルで画像を生成するときは、ノイズだけの状態から始め、学習した逆拡散過程によってノイズを少しずつ取り除いていく。
答え:○(正しい)
解説
正しい。DDPM の論文は、逆過程を拡散過程を逆向きにたどるよう学習したものとし、生成はランダムなノイズから始めると説明している。逆拡散過程とは、砂嵐の画面から少しずつ乱れを取り除いて絵を浮かび上がらせる手順のこと。曇ったガラスを少しずつ拭いていくと景色が見えてくるように、何度も手直しを重ねて画像を仕上げる。 要点:画像の生成は、ノイズだけの状態から始め、学習した逆拡散過程でノイズを少しずつ取り除いて行う。
問3
拡散モデル・基盤モデル・マルチモーダルモデル|学習するのはどちら拡散モデルで学習するのは、データにノイズを加えていく拡散過程のほうであり、ノイズを取り除く逆拡散過程は学習しない固定の手順である。
答え:×(誤り)
解説
誤り。学習するものと固定のものが逆である。DDPM では、ノイズを加える拡散過程は決まった手順で固定され、ノイズを取り除く逆拡散過程の手順を学習する。ノイズを足すのは誰でもできる簡単な作業だが、乱れた画像から元の絵を取り戻すのは難しいので、そちらをモデルに練習させる、と考えると覚えやすい。 要点:DDPM では、ノイズを加える拡散過程は決まった手順(固定)で、ノイズを取り除く逆拡散過程のほうを学習する。
問4
拡散モデル・基盤モデル・マルチモーダルモデル|潜在拡散モデル潜在拡散モデル(Latent Diffusion Model)は、画像をオートエンコーダで圧縮した潜在空間で拡散モデルを動かすことで、ピクセルの空間で直接動かす場合より計算量を減らした。
答え:○(正しい)
解説
正しい。LDM の論文は、ピクセルの空間で動く拡散モデルは学習にも生成にも多くの計算を要するとし、学習済みのオートエンコーダ(画像を圧縮・復元するモデル)の潜在空間で動かすことで、品質を保ちつつ計算量を大きく減らしたと述べている。大きな図面をそのまま描き直すより、要点を縮小したラフで構図を決めてから清書するほうが早い、という工夫にあたる。 要点:ピクセル(画素)の空間で直接動く拡散モデルは計算が重い。潜在拡散モデル(LDM)は、オートエンコーダで画像を圧縮した潜在空間で拡散モデルを動かし、品質を保ちながら計算量を大きく減らした。
問5
拡散モデル・基盤モデル・マルチモーダルモデル|どこで動かすか潜在拡散モデルは、画像を圧縮せずにピクセルの空間で直接ノイズの除去を繰り返すことで、計算量を減らしながら高い解像度を実現した。
答え:×(誤り)
解説
誤り。潜在拡散モデルは、ピクセルの空間で直接ではなく、画像を圧縮した潜在空間で拡散モデルを動かす。論文は、ピクセルの空間で動く拡散モデルは学習・生成の計算が重いことを、この工夫の理由に挙げている。潜在空間とは、画像の特徴を少ない数値に詰め込んだ「要約版の空間」のことで、写真をそのまま扱うより、要点メモを扱うほうが軽いのと同じである。 要点:潜在拡散モデルは、ピクセルの空間ではなく、学習済みのオートエンコーダが作る潜在空間で拡散モデルを動かす。
問6
拡散モデル・基盤モデル・マルチモーダルモデル|エンコーダとデコーダ潜在拡散モデルでは、エンコーダが画像を潜在表現に変換し、生成した潜在表現をデコーダが画像に戻す。
答え:○(正しい)
解説
正しい。LDM の論文は、エンコーダが画像を潜在表現に符号化し、デコーダが潜在表現から画像を再構成すると説明している。この潜在空間は、見た目のうえでは画像と同じ情報を保ちながら、計算量が大きく少ない。荷物を圧縮袋に入れて運び(エンコーダ)、着いた先で袋から出して元に戻す(デコーダ)流れにたとえられる。 要点:潜在拡散モデルでは、エンコーダが画像を潜在表現(圧縮した数値の並び)に変え、デコーダが潜在表現から画像を復元する。
問7
拡散モデル・基盤モデル・マルチモーダルモデル|基盤モデルとは基盤モデル(Foundation Model)は、大規模言語モデルに代表され、そこから下流の幅広いタスクに合わせた個別のモデルを生み出す中核の技術基盤とされる。
答え:○(正しい)
解説
正しい。AI事業者ガイドラインは、大規模言語モデルに代表される基盤モデルを、様々なサービスを支える個別モデルを生み出すコアの技術基盤とし、下流の幅広いタスクに適応させたモデルの開発などの点で従来の AI と違う性質を持つと説明している。料理でいえば、いろいろな料理に使い回せる「だし」のようなもので、そこから和え物にも汁物にも仕立てられる。 要点:大規模言語モデルに代表される基盤モデル(Foundation Model)は、様々なサービスを支える個別のモデルを生み出す中核の技術基盤で、下流の幅広いタスクに合わせたモデルを派生させられる。
問8
拡散モデル・基盤モデル・マルチモーダルモデル|1つのタスク専用ではない基盤モデルは、1つの決まったタスクだけを高い精度でこなすように作られた専用のモデルであり、ほかのタスクに合わせて派生させることは想定されていない。
答え:×(誤り)
解説
誤り。AI事業者ガイドラインは、基盤モデルを、下流の幅広いタスクに適応させた個別のモデルを生み出すコアの技術基盤としている。1つのタスク専用のモデルではない。たとえば同じ大規模言語モデルをもとに、問い合わせ対応のチャットボットにも、議事録の要約の仕組みにも仕立てられる。この「使い回せる土台」であることが基盤モデルの特徴である。 要点:基盤モデルは、1つのタスク専用ではなく、幅広い下流のタスクに合わせた個別のモデルを生み出す土台である。
問9
拡散モデル・基盤モデル・マルチモーダルモデル|汎用的なAIへAI事業者ガイドラインは、2021年以降、基盤モデルの台頭によって、特定の分野だけに特化しない汎用的な AI の開発が進んでいると述べている。
答え:○(正しい)
解説
正しい。AI事業者ガイドラインは、2000年代以降は特定の分野に特化した AI(画像認識・翻訳・音声認識など)が使われてきたが、2021年以降は基盤モデルの台頭で汎用的な AI の開発が進み、画像や文章を生成する生成AIも普及しつつあると説明している。用途ごとに専用の機械を買っていた時代から、1台で何役もこなす多機能な機械が出てきた変化にたとえられる。 要点:2021年以降、基盤モデルの台頭で、特定の分野だけに特化しない汎用的な AI の開発が進み、画像や文章を生成する生成AIも普及しつつある。
問10
拡散モデル・基盤モデル・マルチモーダルモデル|マルチモーダルとはマルチモーダルな生成AIは、テキスト・音声・画像など2つ以上の異なるモダリティ(データの種類)の情報を集め、統合して処理できる。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(別添)は、マルチモーダルな生成AIにより、テキスト・音声・画像・動画・センサ情報など2つ以上の異なるモダリティ(データの種類)から情報を収集し、統合して処理できると説明している。たとえば、ホワイトボードの写真と会議の録音をまとめて渡し、「決まったことを表にして」と頼めるのがマルチモーダルな使い方である。 要点:マルチモーダルな生成AIは、テキスト・音声・画像・動画・センサ情報など、2つ以上の異なるモダリティ(データの種類)から情報を集め、統合して処理できる。
問11
拡散モデル・基盤モデル・マルチモーダルモデル|モダリティの意味モダリティとは、生成AIのモデルの大きさ(パラメータの数)を表す言葉で、マルチモーダルモデルとはパラメータの数が非常に多いモデルを指す。
答え:×(誤り)
解説
誤り。モダリティはモデルの大きさではなく、データの種類(テキスト・音声・画像・動画・センサ情報など)を指す。マルチモーダルモデルは、2つ以上の異なるモダリティの情報を統合して扱えるモデルである。人にたとえると、目で見て耳で聞いて文字も読める、という「感覚の種類の多さ」の話で、頭の大きさの話ではない。 要点:モダリティとは、テキスト・音声・画像・動画などのデータの種類のことである。モデルの大きさを表す言葉ではない。
問12
拡散モデル・基盤モデル・マルチモーダルモデル|精巧な生成物への対策AI事業者ガイドラインは、マルチモーダルな生成AIでは比較的容易に精巧な生成物を作れることから、誤解や偏見の助長などに留意し、利用に人間の判断を介在させる等の対策を求めている。
答え:○(正しい)
解説
正しい。AI事業者ガイドラインの「適正利用」の項は、マルチモーダルな生成AIの生成物は、その精巧さにより誤解や偏見等を助長する可能性や、他者の知的財産権等を侵害する可能性があることにも留意し、人間の判断を介在させる等の対策を講じるとしている。本物そっくりの商品写真を作れても、広告に出す前には担当者が中身と権利を確かめる、という運用にあたる。 要点:マルチモーダルな生成AIは比較的容易に精巧な生成物を作れるため、誤解や偏見を助長するおそれや他者の知的財産権を侵害するおそれに留意し、人間の判断を介在させる等の対策をとる。
問13
拡散モデル・基盤モデル・マルチモーダルモデル|高度なAIシステムAI事業者ガイドラインが引用する広島AIプロセスの定義では、「高度なAIシステム」に基盤モデルは含まれず、生成AIシステムだけを指す。
答え:×(誤り)
解説
誤り。定義は「最先端の基盤モデル及び生成AIシステムを含む、最も高度なAIシステム」であり、基盤モデルも含まれる。広島AIプロセスは、G7 が始めた高度な AI のルールづくりの枠組みのこと。土台の基盤モデルと、それを組み込んだ生成AIのサービスの両方が、ルールの対象として意識されている、と覚えるとよい。 要点:「高度なAIシステム」は、最先端の基盤モデルと生成AIシステムを含む、最も高度な AI システムを指す(広島AIプロセスの定義をAI事業者ガイドラインが引用)。
拡散モデル・基盤モデル・マルチモーダルモデルの問題を続けて解く
この論点に対応する13問を絞り込んで出題します。