生成AI
事前学習とファインチューニング(指示チューニング)
大規模言語モデルは、まず大量の文章で次に来るトークン(語のかけら)を予測する事前学習を行い、そのあと追加の学習で重みを調整するファインチューニング(正解付きの手本のデータで学ぶ方法や、人のフィードバックを使う方法など)で用途や指示に合わせます。ファインチューニング(モデルの重みを更新する)と、プロンプトに例や指示を書くだけのコンテキスト内学習(重みを更新しない)を区別すると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
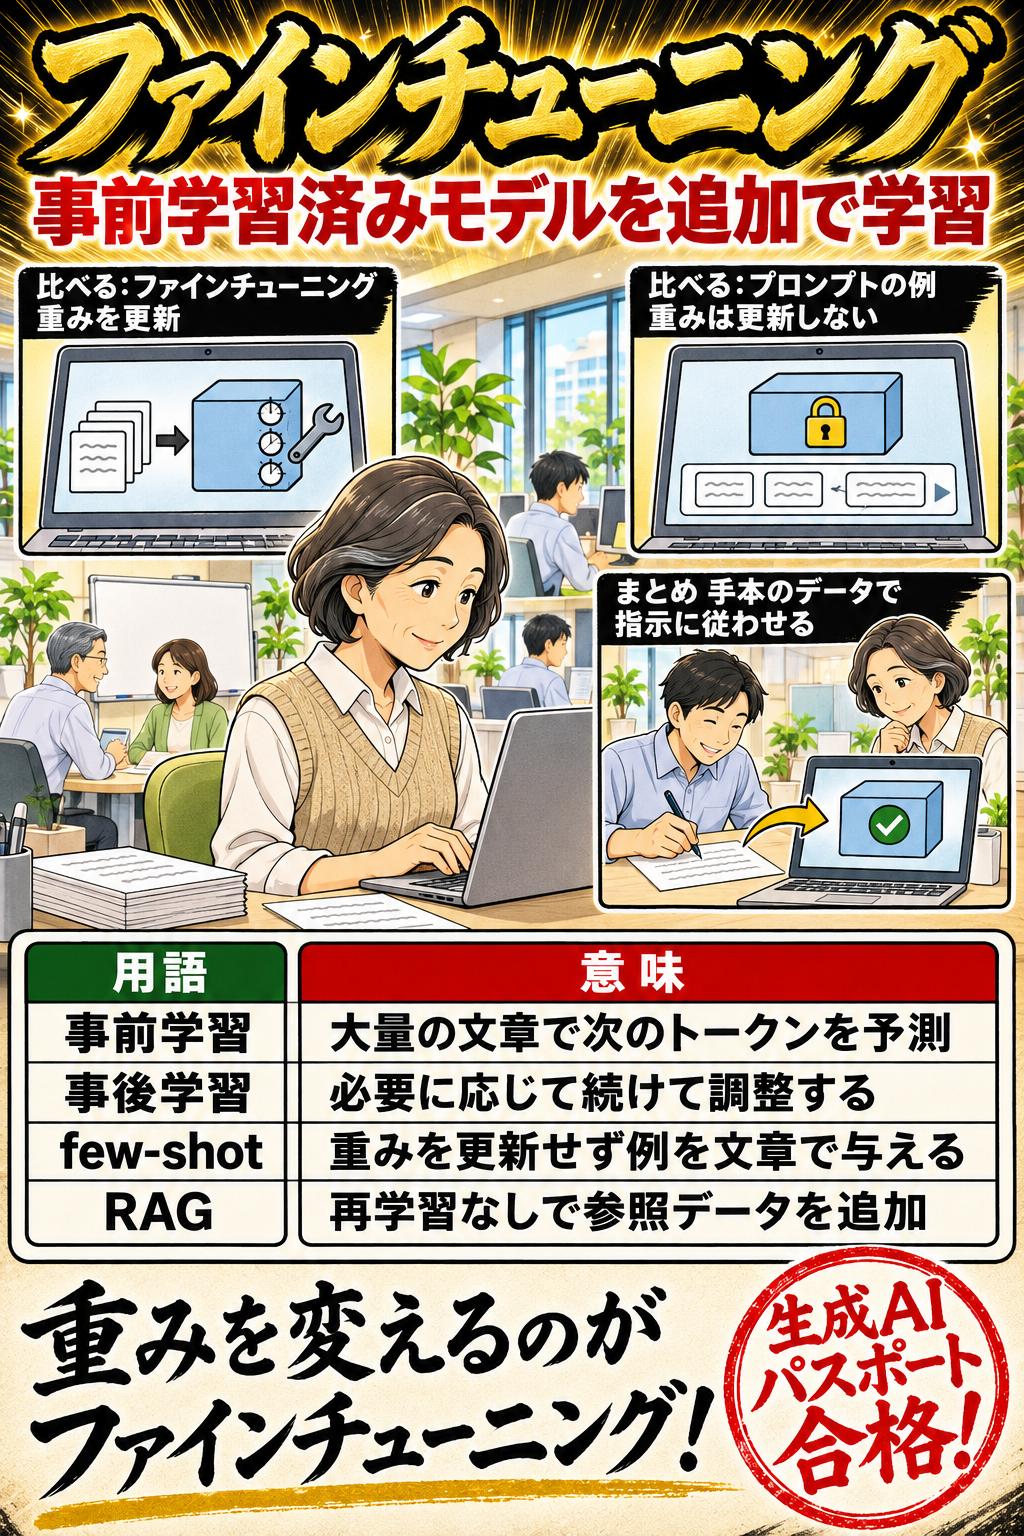
大規模言語モデルは、まず大量の文章で次に来るトークン(語のかけら)を予測する事前学習を行い、そのあと追加の学習で重みを調整するファインチューニング(正解付きの手本のデータで学ぶ方法や、人のフィードバックを使う方法など)で用途や指示に合わせます。ファインチューニング(モデルの重みを更新する)と、プロンプトに例や指示を書くだけのコンテキスト内学習(重みを更新しない)を区別すると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 14問
事前学習とファインチューニング(指示チューニング)|事前学習と事後学習
学習は、データを使ってモデルのパラメータ(中の数値)を決めたり改善したりする過程で、汎化性能を形作る事前学習と、必要に応じて続けて調整する事後学習の2つからなる場合がある。
比較して覚える
事前学習・ファインチューニング・コンテキスト内学習・RAG
モデルに知識や用途を身につけさせる4つの方法を並べます。モデルの重み(中の数値)を更新するのはどれか、何のデータを使うか、主な注意点は何かを取り違える肢を、この表で切り分けます。
| 事由 | 事前学習 | ファインチューニング | コンテキスト内学習(few-shot など) | RAG(検索拡張生成) |
|---|---|---|---|---|
| 何をするか | 大量の文章で次のトークンを予測して学ぶ | 事前学習済みのモデルを目的のタスクのデータで追加で学習させる | プロンプトに指示や例を書いてタスクを行わせる | 答える前に外部のデータを検索して、その情報をもとに答えを作る |
| 重み(パラメータ)の更新 | する | する | しない | しない(モデルを再学習せずにデータソースを足せる) |
| 使うデータ | インターネット上の文章など大量のデータ | タスク向けのデータ(正解付きの手本など。人のフィードバックで調整する方法もある) | プロンプトに書いた指示と少数の例 | 社内文書やデータベースなど参照するデータソース |
| 主な注意点 | それだけでは指示に従うこととずれている | 従来の方法ではタスクごとに新しい大きなデータセットが要る(GPT-3 の論文) | 一度に渡せる量はコンテキストウィンドウまで | ハルシネーションを抑えられるが、完全には防げない |
| 身近なたとえ | 新入社員の共通研修で一般教養を身につける | 配属先で追加の研修を受ける | 仕事を頼むときに見本を2〜3件見せる | 社内の規程集を開いて確かめてから答える |
何をするか
- 事前学習
- 大量の文章で次のトークンを予測して学ぶ
- ファインチューニング
- 事前学習済みのモデルを目的のタスクのデータで追加で学習させる
- コンテキスト内学習(few-shot など)
- プロンプトに指示や例を書いてタスクを行わせる
- RAG(検索拡張生成)
- 答える前に外部のデータを検索して、その情報をもとに答えを作る
重み(パラメータ)の更新
- 事前学習
- する
- ファインチューニング
- する
- コンテキスト内学習(few-shot など)
- しない
- RAG(検索拡張生成)
- しない(モデルを再学習せずにデータソースを足せる)
使うデータ
- 事前学習
- インターネット上の文章など大量のデータ
- ファインチューニング
- タスク向けのデータ(正解付きの手本など。人のフィードバックで調整する方法もある)
- コンテキスト内学習(few-shot など)
- プロンプトに書いた指示と少数の例
- RAG(検索拡張生成)
- 社内文書やデータベースなど参照するデータソース
主な注意点
- 事前学習
- それだけでは指示に従うこととずれている
- ファインチューニング
- 従来の方法ではタスクごとに新しい大きなデータセットが要る(GPT-3 の論文)
- コンテキスト内学習(few-shot など)
- 一度に渡せる量はコンテキストウィンドウまで
- RAG(検索拡張生成)
- ハルシネーションを抑えられるが、完全には防げない
身近なたとえ
- 事前学習
- 新入社員の共通研修で一般教養を身につける
- ファインチューニング
- 配属先で追加の研修を受ける
- コンテキスト内学習(few-shot など)
- 仕事を頼むときに見本を2〜3件見せる
- RAG(検索拡張生成)
- 社内の規程集を開いて確かめてから答える
この論点の用語
用語集をすべて見る →01事前学習とファインチューニング(指示チューニング)の重要暗記項目
事前学習とファインチューニング(指示チューニング)|事前学習と事後学習
学習は、データを使ってモデルのパラメータ(中の数値)を決めたり改善したりする過程で、汎化性能を形作る事前学習と、必要に応じて続けて調整する事後学習の2つからなる場合がある。
事前学習とファインチューニング(指示チューニング)|どちらが先か
汎化性能を形作り、パラメータを最適化するのが事前学習。必要に応じて続けてパラメータを調整するのが事後学習(ファインチューニングなど)である。
ひっかけ注意「AI事業者ガイドラインの用語の定義では、必要に応じて継続的にパラメータを調整するのが事前学習で、汎化性能を形作ってパラメータを最適化するのが事後学習とされる」は誤り。 事前学習と事後学習の説明が逆である。汎化性能を形作りパラメータを最適化するのが事前学習、必要に応じた継続的なパラメータの調整を行うのが事後学習である。研修のたとえなら、まず全員が受ける共通研修で幅広い基礎を作り(事前学習)、その後に部署ごとの追加の指導で調整する(事後学習)順番である。
事前学習とファインチューニング(指示チューニング)|事前学習の目的
多くの大規模言語モデルの事前学習の目的は、インターネット上の文章で次のトークン(語のかけら)を予測することである。
事前学習とファインチューニング(指示チューニング)|事前学習だけでは足りない
次のトークンの予測(事前学習の目的)は「指示に役立つ形で安全に従う」こととは異なる(ずれている)ため、指示に合わせる追加の学習が行われる。
ひっかけ注意「大規模言語モデルの事前学習の目的は、もともと「利用者の指示に役立つ形で安全に従うこと」そのものであるため、事前学習だけで指示に沿った応答が得られる」は誤り。 InstructGPT の論文は、次のトークンを予測する目的は「利用者の指示に役立つ形で安全に従う」という目的とは異なり、ずれている(misaligned)と述べている。そこで、人が書いた手本でファインチューニングするなどして指示に合わせる。文章の続きを当てるのが得意な人でも、「この報告を3行でまとめて」という頼みに素直に応じる練習は別に要る、ということである。
事前学習とファインチューニング(指示チューニング)|事前学習→ファインチューニング
大量の文章で事前学習し、そのあと特定のタスク用にファインチューニングする方法で、多くの自然言語処理のタスクの性能が大きく上がった。
事前学習とファインチューニング(指示チューニング)|ファインチューニングとは
ファインチューニングは、事前学習済みのモデルを追加で学習させ、重み(中の数値)を更新する方法である。GPT-3 の論文は、目的のタスク向けの教師ありのデータセット(正解付きのデータ)で学習する形を挙げている。
事前学習とファインチューニング(指示チューニング)|ファインチューニングの欠点
GPT-3 の論文は、それまで主流だったファインチューニングの主な欠点として、タスクごとに新しい大きなデータセットが必要になることを挙げた。
ひっかけ注意「GPT-3 の論文は、タスクごとに大きなデータセットを新たに用意する必要がない点を、ファインチューニングの主な利点として挙げている」は誤り。 GPT-3 の論文は、それまで主流だったファインチューニングでは数千〜数十万件の正解付きの例を使うのが一般的だとし、主な欠点として、タスクごとに新しい大きなデータセットが必要になることを挙げている。データセットが要らないのではなく、要ることが欠点である。たとえば社内の問い合わせ振り分けに使うなら、過去の問い合わせと正しい振り分け先の組を大量に用意しなければならない。
事前学習とファインチューニング(指示チューニング)|BERT の事前学習
BERT の事前学習は、正解のない文章を使い、入力の語の一部を隠して前後の文脈から元の語を当てる「マスク付き言語モデル(Masked LM)」と、2つの文が続いているかを当てる「次の文の予測(NSP)」の2つの課題で行う。
覚える数字と、狙われる引っかけ
- ひっかけ「AI事業者ガイドラインの用語の定義では、必要に応じて継続的にパラメータを調整するのが事前学習で、汎化性能を形作ってパラメータを最適化するのが事後学習とされる」は誤り。事前学習と事後学習の説明が逆である。汎化性能を形作りパラメータを最適化するのが事前学習、必要に応じた継続的なパラメータの調整を行うのが事後学習である。研修のたとえなら、まず全員が受ける共通研修で幅広い基礎を作り(事前学習)、その後に部署ごとの追加の指導で調整する(事後学習)順番である。
- ひっかけ「大規模言語モデルの事前学習の目的は、もともと「利用者の指示に役立つ形で安全に従うこと」そのものであるため、事前学習だけで指示に沿った応答が得られる」は誤り。InstructGPT の論文は、次のトークンを予測する目的は「利用者の指示に役立つ形で安全に従う」という目的とは異なり、ずれている(misaligned)と述べている。そこで、人が書いた手本でファインチューニングするなどして指示に合わせる。文章の続きを当てるのが得意な人でも、「この報告を3行でまとめて」という頼みに素直に応じる練習は別に要る、ということである。
- ひっかけ「GPT-3 の論文は、タスクごとに大きなデータセットを新たに用意する必要がない点を、ファインチューニングの主な利点として挙げている」は誤り。GPT-3 の論文は、それまで主流だったファインチューニングでは数千〜数十万件の正解付きの例を使うのが一般的だとし、主な欠点として、タスクごとに新しい大きなデータセットが必要になることを挙げている。データセットが要らないのではなく、要ることが欠点である。たとえば社内の問い合わせ振り分けに使うなら、過去の問い合わせと正しい振り分け先の組を大量に用意しなければならない。
- ひっかけ「BERT の論文では、質問応答などのタスクごとにファインチューニングするとき、事前学習で得たパラメータは使わず、ゼロから学習し直している」は誤り。事前学習で得たパラメータを捨てるのではなく、初めの値として使う。BERT の論文は、ファインチューニングでは事前学習済みのパラメータでモデルを初期化し、各タスクの正解付きのデータですべてのパラメータを調整すると述べ、出力の層を1つ足すだけで幅広いタスクで最高水準の結果を出したとしている。一般教養を身につけた新人を、部署ごとの短い研修で営業にも経理にも育てるイメージである。
- ひっかけ「GPT-3 の論文の few-shot の設定では、いくつかの例を使ってモデルの重みを更新(ファインチューニング)してからタスクを解かせている」は誤り。GPT-3 の論文は、すべてのタスクで重みの更新もファインチューニングも行わず、タスクと例を文章で与えるだけで評価したと述べている。few-shot は、使う時にいくつかの例を条件として与える設定である。研修をやり直すのではなく、仕事を頼むときに「たとえばこういうふうに」と見本を数件見せるだけ、という違いである。
- ひっかけ「RAG(検索拡張生成)で参照するデータソースを追加するには、通常のファインチューニングと同じく、モデルの再トレーニングが必要になる」は誤り。AI事業者ガイドライン(別添)は、RAG では通常のファインチューニングと異なり、モデルの再トレーニングを行わずに参照するデータソースを追加できるため、コストの低減等が期待されるとしている。RAG は、答える前に社内文書などを検索して読み込む仕組み。新しい規程ができたら、新人を研修し直すのではなく、規程集のファイルに1冊足すだけでよい、という違いである。
02試験で正誤を分けるチェック順
- 1学習は、データを使ってモデルのパラメータ(中の数値)を決めたり改善したりする過程で、汎化性能を形作る事前学習と、必要に応じて続けて調整する事後学習の2つからなる場合がある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2汎化性能を形作り、パラメータを最適化するのが事前学習。必要に応じて続けてパラメータを調整するのが事後学習(ファインチューニングなど)である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3多くの大規模言語モデルの事前学習の目的は、インターネット上の文章で次のトークン(語のかけら)を予測することである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4次のトークンの予測(事前学習の目的)は「指示に役立つ形で安全に従う」こととは異なる(ずれている)ため、指示に合わせる追加の学習が行われる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5大量の文章で事前学習し、そのあと特定のタスク用にファインチューニングする方法で、多くの自然言語処理のタスクの性能が大きく上がった。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6ファインチューニングは、事前学習済みのモデルを追加で学習させ、重み(中の数値)を更新する方法である。GPT-3 の論文は、目的のタスク向けの教師ありのデータセット(正解付きのデータ)で学習する形を挙げている。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7GPT-3 の論文は、それまで主流だったファインチューニングの主な欠点として、タスクごとに新しい大きなデータセットが必要になることを挙げた。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8BERT の事前学習は、正解のない文章を使い、入力の語の一部を隠して前後の文脈から元の語を当てる「マスク付き言語モデル(Masked LM)」と、2つの文が続いているかを当てる「次の文の予測(NSP)」の2つの課題で行う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9BERT は、事前学習で得たパラメータを初めの値として使い、各タスクの正解付きのデータで、すべてのパラメータをファインチューニングする。同じ事前学習済みのモデルから、タスクごとに別のモデルを作る。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10コンテキスト内学習(In-Context Learning)は、学習済みのパラメータを更新せず、プロンプト(指示文)に書いた指示や例によって特定のタスクを行わせる方法である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11GPT-3 の few-shot は、重みを更新せず、推論の時(使う時)にいくつかの例を文章で与えるだけでタスクを解かせる設定である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12InstructGPT では、人(ラベラー)が望ましい応答の手本を書いたデータを集め、教師あり学習で GPT-3 をファインチューニングした。指示に従わせるための最初の段である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13ファインチューニングする新しいタスクの領域(ドメイン)が元のモデルの領域と違うときは、一部の層だけをファインチューニングするなどの調整を検討する(ドメイン適応)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14RAG(検索拡張生成)は、通常のファインチューニングと違い、モデルを再学習せずに参照するデータソースを追加できるため、コストの低減が期待される。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
事前学習とファインチューニング(指示チューニング)の○×一問一答
1/8問解答 0・正解 0
生成AI
事前学習とファインチューニング(指示チューニング)|事前学習と事後学習
AI事業者ガイドラインの用語の定義では、学習は、汎化性能を形作ってパラメータを最適化する事前学習と、必要に応じて継続的にパラメータを調整する事後学習の2つのプロセスからなる場合があるとされる。
事前学習とファインチューニング(指示チューニング)の○×一問一答14問|問題と解説
この論点で収録している14問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
事前学習とファインチューニング(指示チューニング)|事前学習と事後学習AI事業者ガイドラインの用語の定義では、学習は、汎化性能を形作ってパラメータを最適化する事前学習と、必要に応じて継続的にパラメータを調整する事後学習の2つのプロセスからなる場合があるとされる。
答え:○(正しい)
解説
正しい。デジタル庁のガイドラインが引くAI事業者ガイドラインの定義は、学習を「データを用いて AI モデルのパラメータを決定または改善するプロセス」とし、事前学習と事後学習の2つから構成される場合があるとしている。汎化性能とは、初めて見る問題にも対応できる力のこと。新入社員の研修で一般教養を身につけ(事前学習)、配属先で仕事の型を覚える(事後学習)流れにたとえられる。 要点:学習は、データを使ってモデルのパラメータ(中の数値)を決めたり改善したりする過程で、汎化性能を形作る事前学習と、必要に応じて続けて調整する事後学習の2つからなる場合がある。
問2
事前学習とファインチューニング(指示チューニング)|どちらが先かAI事業者ガイドラインの用語の定義では、必要に応じて継続的にパラメータを調整するのが事前学習で、汎化性能を形作ってパラメータを最適化するのが事後学習とされる。
答え:×(誤り)
解説
誤り。事前学習と事後学習の説明が逆である。汎化性能を形作りパラメータを最適化するのが事前学習、必要に応じた継続的なパラメータの調整を行うのが事後学習である。研修のたとえなら、まず全員が受ける共通研修で幅広い基礎を作り(事前学習)、その後に部署ごとの追加の指導で調整する(事後学習)順番である。 要点:汎化性能を形作り、パラメータを最適化するのが事前学習。必要に応じて続けてパラメータを調整するのが事後学習(ファインチューニングなど)である。
問3
事前学習とファインチューニング(指示チューニング)|事前学習の目的近年の多くの大規模言語モデルの事前学習では、インターネット上のウェブページの文章について、次に来るトークンを予測することを目的に学習している。
答え:○(正しい)
解説
正しい。InstructGPT の論文は、近年の多くの大規模な言語モデルで使われる学習の目的を「インターネット上のウェブページで次のトークンを予測すること」と説明している。トークンとは、モデルが文章を扱う単位(単語や単語の一部)のこと。「いつもお世話に」の次は「なって」が来やすい、という続き方を膨大な文章から覚えていく穴埋め練習にあたる。 要点:多くの大規模言語モデルの事前学習の目的は、インターネット上の文章で次のトークン(語のかけら)を予測することである。
問4
事前学習とファインチューニング(指示チューニング)|事前学習だけでは足りない大規模言語モデルの事前学習の目的は、もともと「利用者の指示に役立つ形で安全に従うこと」そのものであるため、事前学習だけで指示に沿った応答が得られる。
答え:×(誤り)
解説
誤り。InstructGPT の論文は、次のトークンを予測する目的は「利用者の指示に役立つ形で安全に従う」という目的とは異なり、ずれている(misaligned)と述べている。そこで、人が書いた手本でファインチューニングするなどして指示に合わせる。文章の続きを当てるのが得意な人でも、「この報告を3行でまとめて」という頼みに素直に応じる練習は別に要る、ということである。 要点:次のトークンの予測(事前学習の目的)は「指示に役立つ形で安全に従う」こととは異なる(ずれている)ため、指示に合わせる追加の学習が行われる。
問5
事前学習とファインチューニング(指示チューニング)|事前学習→ファインチューニング大量の文章で事前学習を行ったあと、特定のタスク向けにファインチューニングする方法によって、多くの自然言語処理のタスクの性能が大きく向上した。
答え:○(正しい)
解説
正しい。GPT-3 の論文の要旨は、大きな文章の集まりで事前学習し、そのあと特定のタスクでファインチューニングすることで、多くの自然言語処理のタスクで大きな向上が得られてきたと述べている。ファインチューニングとは、作り終えたモデルに追加で学習させて用途に合わせること。一般常識のある人に、問い合わせ対応のマニュアルで追加の研修をするイメージである。 要点:大量の文章で事前学習し、そのあと特定のタスク用にファインチューニングする方法で、多くの自然言語処理のタスクの性能が大きく上がった。
問6
事前学習とファインチューニング(指示チューニング)|ファインチューニングとはGPT-3 の論文は、ファインチューニングを、事前学習済みのモデルを目的のタスクに合わせた教師ありのデータセットで学習させ、モデルの重みを更新する方法として説明している。
答え:○(正しい)
解説
正しい。GPT-3 の論文は、ファインチューニングを、目的のタスクに特有の教師ありデータセットで学習して、事前学習済みのモデルの重みを更新することと説明している。追加の学習の仕方はこれだけではなく、InstructGPT は人のフィードバックによる強化学習でも調整した。教師ありのデータとは、問いと正しい答えを組にしたデータのこと。たとえば「問い合わせ文」と「担当部署」の組を大量に学ばせて、問い合わせを自動で振り分けるモデルに仕立てる、といった使い方である。 要点:ファインチューニングは、事前学習済みのモデルを追加で学習させ、重み(中の数値)を更新する方法である。GPT-3 の論文は、目的のタスク向けの教師ありのデータセット(正解付きのデータ)で学習する形を挙げている。
問7
事前学習とファインチューニング(指示チューニング)|ファインチューニングの欠点GPT-3 の論文は、タスクごとに大きなデータセットを新たに用意する必要がない点を、ファインチューニングの主な利点として挙げている。
答え:×(誤り)
解説
誤り。GPT-3 の論文は、それまで主流だったファインチューニングでは数千〜数十万件の正解付きの例を使うのが一般的だとし、主な欠点として、タスクごとに新しい大きなデータセットが必要になることを挙げている。データセットが要らないのではなく、要ることが欠点である。たとえば社内の問い合わせ振り分けに使うなら、過去の問い合わせと正しい振り分け先の組を大量に用意しなければならない。 要点:GPT-3 の論文は、それまで主流だったファインチューニングの主な欠点として、タスクごとに新しい大きなデータセットが必要になることを挙げた。
問8
事前学習とファインチューニング(指示チューニング)|BERT の事前学習BERT の事前学習では、入力の語の一部を隠し(マスクし)、その語を前後の文脈から当てる「マスク付き言語モデル」の課題を使う。
答え:○(正しい)
解説
正しい。BERT の論文は、入力のトークン(語のかけら)の15%を無作為に予測の対象に選び、その多く(8割)を [MASK] という記号に置き換えて隠し、文脈だけから元の語を当てる「マスク付き言語モデル」を事前学習の目的に使い、あわせて2つの文が続きかどうかを当てる「次の文の予測」も学ばせたと述べている。左右の文脈をどちらも使えるのは、この穴埋めの形のおかげである。新聞の記事の一部を黒く塗りつぶして、前後の文から塗った言葉を当てる練習にあたる。 要点:BERT の事前学習は、正解のない文章を使い、入力の語の一部を隠して前後の文脈から元の語を当てる「マスク付き言語モデル(Masked LM)」と、2つの文が続いているかを当てる「次の文の予測(NSP)」の2つの課題で行う。
問9
事前学習とファインチューニング(指示チューニング)|BERT のファインチューニングBERT の論文では、質問応答などのタスクごとにファインチューニングするとき、事前学習で得たパラメータは使わず、ゼロから学習し直している。
答え:×(誤り)
解説
誤り。事前学習で得たパラメータを捨てるのではなく、初めの値として使う。BERT の論文は、ファインチューニングでは事前学習済みのパラメータでモデルを初期化し、各タスクの正解付きのデータですべてのパラメータを調整すると述べ、出力の層を1つ足すだけで幅広いタスクで最高水準の結果を出したとしている。一般教養を身につけた新人を、部署ごとの短い研修で営業にも経理にも育てるイメージである。 要点:BERT は、事前学習で得たパラメータを初めの値として使い、各タスクの正解付きのデータで、すべてのパラメータをファインチューニングする。同じ事前学習済みのモデルから、タスクごとに別のモデルを作る。
問10
事前学習とファインチューニング(指示チューニング)|コンテキスト内学習コンテキスト内学習では、学習済みのパラメータを更新することなく、プロンプトに書いた指示や少数の例によって、モデルに特定のタスクを行わせる。
答え:○(正しい)
解説
正しい。AI事業者ガイドラインは、大規模言語モデルを始めとする生成AIでは、コンテキスト内学習により、学習済パラメータを更新することなく、利用者の入力(プロンプト)に応じて特定のタスクに対する学習を行わせられると説明している。メールの返信を頼むとき、過去の返信の例を2〜3通貼って「この調子で」と書けば、その場で書き方を合わせてくれるのがこの使い方である。 要点:コンテキスト内学習(In-Context Learning)は、学習済みのパラメータを更新せず、プロンプト(指示文)に書いた指示や例によって特定のタスクを行わせる方法である。
問11
事前学習とファインチューニング(指示チューニング)|few-shot は重みを変えないGPT-3 の論文の few-shot の設定では、いくつかの例を使ってモデルの重みを更新(ファインチューニング)してからタスクを解かせている。
答え:×(誤り)
解説
誤り。GPT-3 の論文は、すべてのタスクで重みの更新もファインチューニングも行わず、タスクと例を文章で与えるだけで評価したと述べている。few-shot は、使う時にいくつかの例を条件として与える設定である。研修をやり直すのではなく、仕事を頼むときに「たとえばこういうふうに」と見本を数件見せるだけ、という違いである。 要点:GPT-3 の few-shot は、重みを更新せず、推論の時(使う時)にいくつかの例を文章で与えるだけでタスクを解かせる設定である。
問12
事前学習とファインチューニング(指示チューニング)|教師ありファインチューニングInstructGPT の開発では、人が書いた望ましい応答の手本のデータを集め、そのデータを使って GPT-3 を教師あり学習でファインチューニングした。
答え:○(正しい)
解説
正しい。InstructGPT の論文の要旨は、プロンプトに対する望ましいふるまいを人が実演した手本のデータを集め、それを使って GPT-3 を教師あり学習でファインチューニングしたと述べている。指示に沿って答えるよう学ばせる、指示への合わせ込みの第一歩である。新人に、先輩が書いた模範の回答例を見せて書き方をまねさせる練習にあたる。 要点:InstructGPT では、人(ラベラー)が望ましい応答の手本を書いたデータを集め、教師あり学習で GPT-3 をファインチューニングした。指示に従わせるための最初の段である。
問13
事前学習とファインチューニング(指示チューニング)|ドメインが違うときAI事業者ガイドライン(別添)は、ファインチューニングする新しいタスクのドメインが元のモデルのドメインと異なる場合、一部の層のみをファインチューニングするなどの調整を検討するとしている。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(別添)は、モデルの選択・調整の手法として、新しいタスクのドメインが元のモデルのドメインと一致するか確かめ、異なる場合は一部の層のみをファインチューニングする等の調整を検討するとしている。ドメインとは、医療・法律・製造などの分野のこと。一般の文章で学んだモデルを社内の医療用語に慣れさせるときの工夫にあたる。 要点:ファインチューニングする新しいタスクの領域(ドメイン)が元のモデルの領域と違うときは、一部の層だけをファインチューニングするなどの調整を検討する(ドメイン適応)。
問14
事前学習とファインチューニング(指示チューニング)|RAG は再学習が要らないRAG(検索拡張生成)で参照するデータソースを追加するには、通常のファインチューニングと同じく、モデルの再トレーニングが必要になる。
答え:×(誤り)
解説
誤り。AI事業者ガイドライン(別添)は、RAG では通常のファインチューニングと異なり、モデルの再トレーニングを行わずに参照するデータソースを追加できるため、コストの低減等が期待されるとしている。RAG は、答える前に社内文書などを検索して読み込む仕組み。新しい規程ができたら、新人を研修し直すのではなく、規程集のファイルに1冊足すだけでよい、という違いである。 要点:RAG(検索拡張生成)は、通常のファインチューニングと違い、モデルを再学習せずに参照するデータソースを追加できるため、コストの低減が期待される。
事前学習とファインチューニング(指示チューニング)の問題を続けて解く
この論点に対応する14問を絞り込んで出題します。