生成AI
Transformerと自己注意機構・派生モデルの系譜
Transformer は、文中の語どうしの関係を扱うのに、再帰(RNN)や畳み込みの代わりに注意機構(どの語とどの語が関係するかを重みで表す仕組み)を使うモデルです。自己注意で文中の語どうしを直接結ぶので、並列に計算しやすく、離れた語の関係(長距離依存)も捉えやすくなりました。Query・Key・Value の役割、エンコーダとデコーダの分担、GPT など後のモデルへのつながりを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
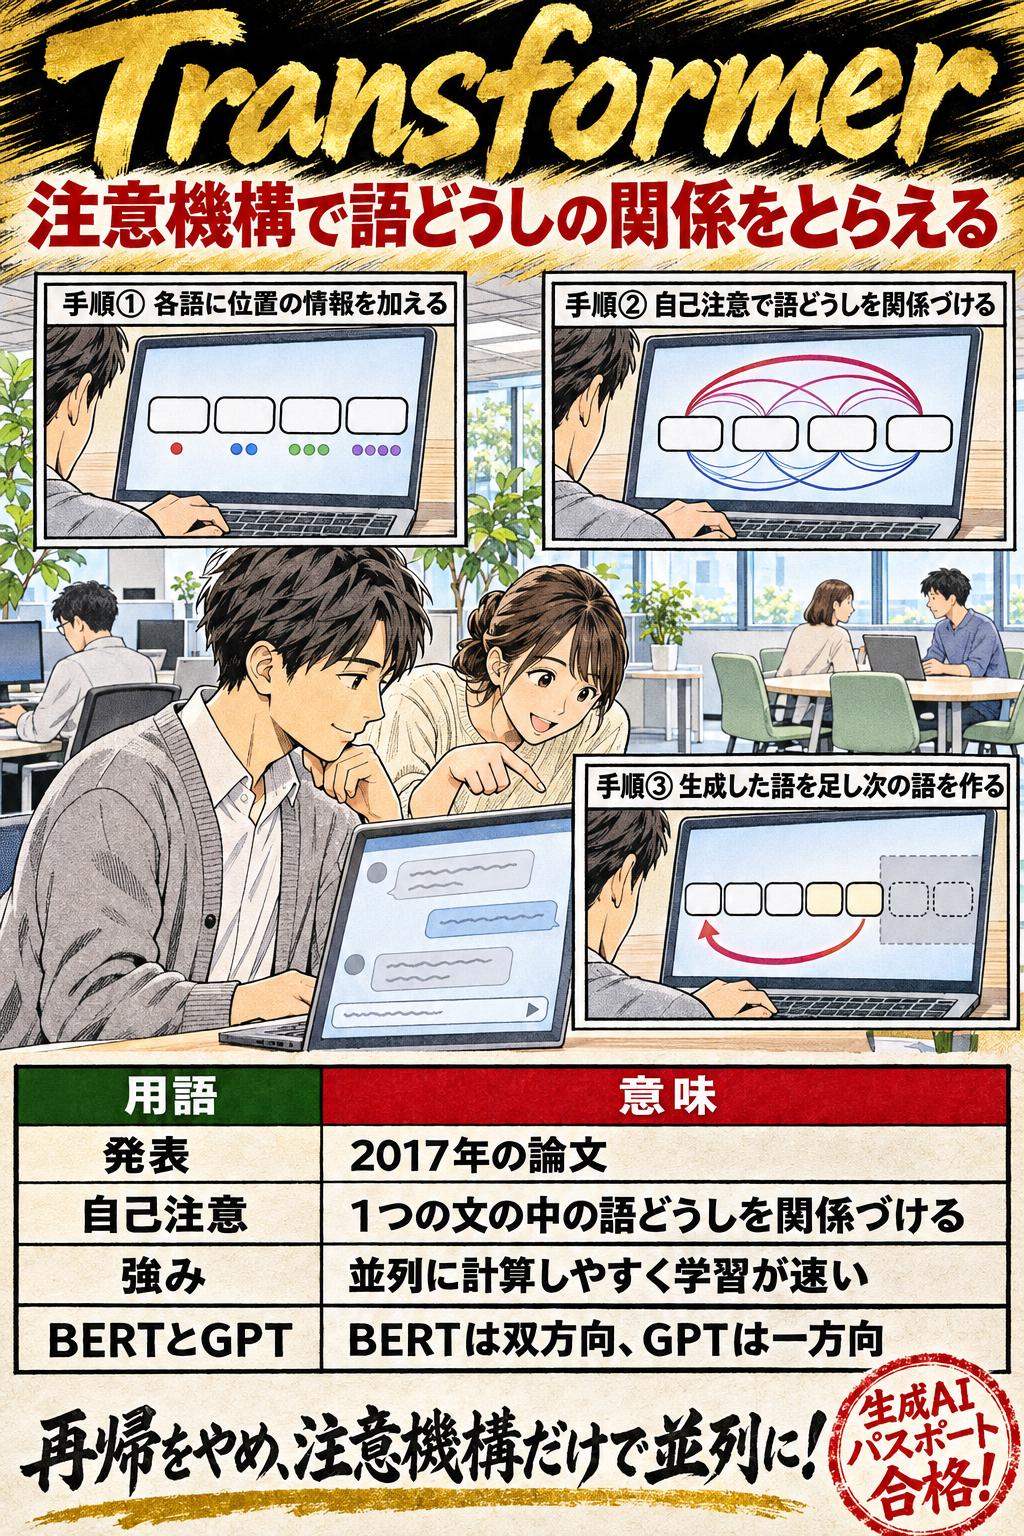
Transformer は、文中の語どうしの関係を扱うのに、再帰(RNN)や畳み込みの代わりに注意機構(どの語とどの語が関係するかを重みで表す仕組み)を使うモデルです。自己注意で文中の語どうしを直接結ぶので、並列に計算しやすく、離れた語の関係(長距離依存)も捉えやすくなりました。Query・Key・Value の役割、エンコーダとデコーダの分担、GPT など後のモデルへのつながりを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 15問
Transformerと自己注意機構・派生モデルの系譜|再帰を使わない構造
Transformer(2017年の論文「Attention Is All You Need」)は、再帰(RNN)や畳み込みを使わず、文中の語どうしの関係を注意機構で扱うモデルの構造である。
比較して覚える
RNN(再帰)とTransformer(自己注意)の違い
文を前から1語ずつ順に読む RNN と、自己注意で語どうしを一度に結ぶ Transformer を並べます。並列に計算しやすいのはどちらか、離れた語の関係を捉えやすいのはどちらか、語順の情報をどう扱うかの取り違えをこの表で切り分けます。
| 事由 | RNN(再帰型) | Transformer(自己注意) |
|---|---|---|
| 処理の進め方 | 前の語の結果を受け取ってから次の語へ進む(文の長さに比例した回数の順番の処理) | すべての位置を一定の回数の処理でつなぐ |
| 並列の計算 | しにくい | しやすい(学習時間を大きく減らせた) |
| 離れた語の関係(長距離依存) | 途中の語を順にたどるので経路が長い | どの2つの位置も短い経路で結ぶので捉えやすい |
| 語順の情報 | 語を前から順に処理する | 位置の情報(位置エンコーディング)を入力に加える |
| 身近なたとえ | 1つの窓口に並んで順番に受け付ける | 窓口をたくさん開けて同時に受け付ける |
処理の進め方
- RNN(再帰型)
- 前の語の結果を受け取ってから次の語へ進む(文の長さに比例した回数の順番の処理)
- Transformer(自己注意)
- すべての位置を一定の回数の処理でつなぐ
並列の計算
- RNN(再帰型)
- しにくい
- Transformer(自己注意)
- しやすい(学習時間を大きく減らせた)
離れた語の関係(長距離依存)
- RNN(再帰型)
- 途中の語を順にたどるので経路が長い
- Transformer(自己注意)
- どの2つの位置も短い経路で結ぶので捉えやすい
語順の情報
- RNN(再帰型)
- 語を前から順に処理する
- Transformer(自己注意)
- 位置の情報(位置エンコーディング)を入力に加える
身近なたとえ
- RNN(再帰型)
- 1つの窓口に並んで順番に受け付ける
- Transformer(自己注意)
- 窓口をたくさん開けて同時に受け付ける
この論点の用語
用語集をすべて見る →01Transformerと自己注意機構・派生モデルの系譜の重要暗記項目
Transformerと自己注意機構・派生モデルの系譜|再帰を使わない構造
Transformer(2017年の論文「Attention Is All You Need」)は、再帰(RNN)や畳み込みを使わず、文中の語どうしの関係を注意機構で扱うモデルの構造である。
Transformerと自己注意機構・派生モデルの系譜|以前のモデルとの違い
Transformer 以前の有力な翻訳などのモデルは、RNN や CNN のエンコーダ・デコーダに注意機構を組み合わせていた。Transformer は再帰と畳み込みそのものを取り除いた。
ひっかけ注意「Transformer は、RNN の再帰の仕組みを土台にし、そこへ注意機構を付け足すことで性能を高めたモデルである」は誤り。 再帰の仕組みを土台にしたのではなく、取り除いた点が新しい。論文は、それまでの有力なモデルが再帰型や畳み込み型のネットワークに注意機構を組み合わせていたのに対し、Transformer は再帰と畳み込みを使わず注意機構に基づいて組んだと述べている。RNN(再帰型ニューラルネットワーク)は、文を前から1語ずつ順に読み進めるモデルで、伝言ゲームのように前の語の情報を順に受け渡す。
Transformerと自己注意機構・派生モデルの系譜|自己注意とは
自己注意(Self-Attention)は、1つの文(系列)の中の異なる位置にある語どうしを関係づけて、その文の表現を計算する注意機構である。
Transformerと自己注意機構・派生モデルの系譜|Query・Key・Value
注意の仕組みは、Query(問い合わせ)と Key(見出し)の適合度から重みを決め、その重みで Value(中身)を足し合わせて出力を作る。
Transformerと自己注意機構・派生モデルの系譜|重みを掛ける相手
注意の出力は、Query と Key の適合度で決めた重みを Value に掛けて足し合わせたものである(重みを掛ける相手は Key ではない)。
ひっかけ注意「注意の仕組みでは、Query と各 Key の適合度から重みを求め、その重みで Key を足し合わせたものを出力とする」は誤り。 重みを掛けて足し合わせるのは Key ではなく Value である。Key は Query と照らし合わせて「どれだけ注目するか」を決めるための見出しの役で、出力の材料になる中身は Value が受け持つ。図書館のたとえなら、本の見出し(Key)で読む量を決め、実際に読み取るのは本文(Value)である。
Transformerと自己注意機構・派生モデルの系譜|並列に計算しやすい
Transformer は再帰を使わないため並列に計算しやすく、学習時間を大きく減らせた。再帰の層は文の長さに比例した順番の処理が要るが、自己注意の層は一定の回数で済む。
Transformerと自己注意機構・派生モデルの系譜|並列化の向き
再帰の層は前の語の結果を待って次へ進むため並列化しにくい。自己注意の層はすべての位置を一定の回数の処理でつなぐため、並列に計算しやすい。
ひっかけ注意「Transformer は、文の先頭から1語ずつ順番に処理する必要があるため、RNN よりも並列に計算しにくい」は誤り。 説明が逆である。論文は、再帰の層は文の長さに比例した回数の順番の処理が必要だが、自己注意の層はすべての位置を一定の回数の処理でつなぐとしている。1語ずつ順に処理しなければならないのは RNN のほうである。行列に並ぶ受付窓口が1つしかない RNN に対し、Transformer は窓口をたくさん開けて同時に受け付けるイメージである。
Transformerと自己注意機構・派生モデルの系譜|長距離依存
離れた位置の語どうしの関係(長距離依存)を学ぶことは文の処理の大きな課題で、位置どうしをつなぐ経路が短いほど学びやすい。自己注意はどの2つの位置も短い経路で結ぶ。
覚える数字と、狙われる引っかけ
- ひっかけ「Transformer は、RNN の再帰の仕組みを土台にし、そこへ注意機構を付け足すことで性能を高めたモデルである」は誤り。再帰の仕組みを土台にしたのではなく、取り除いた点が新しい。論文は、それまでの有力なモデルが再帰型や畳み込み型のネットワークに注意機構を組み合わせていたのに対し、Transformer は再帰と畳み込みを使わず注意機構に基づいて組んだと述べている。RNN(再帰型ニューラルネットワーク)は、文を前から1語ずつ順に読み進めるモデルで、伝言ゲームのように前の語の情報を順に受け渡す。
- ひっかけ「注意の仕組みでは、Query と各 Key の適合度から重みを求め、その重みで Key を足し合わせたものを出力とする」は誤り。重みを掛けて足し合わせるのは Key ではなく Value である。Key は Query と照らし合わせて「どれだけ注目するか」を決めるための見出しの役で、出力の材料になる中身は Value が受け持つ。図書館のたとえなら、本の見出し(Key)で読む量を決め、実際に読み取るのは本文(Value)である。
- ひっかけ「Transformer は、文の先頭から1語ずつ順番に処理する必要があるため、RNN よりも並列に計算しにくい」は誤り。説明が逆である。論文は、再帰の層は文の長さに比例した回数の順番の処理が必要だが、自己注意の層はすべての位置を一定の回数の処理でつなぐとしている。1語ずつ順に処理しなければならないのは RNN のほうである。行列に並ぶ受付窓口が1つしかない RNN に対し、Transformer は窓口をたくさん開けて同時に受け付けるイメージである。
- ひっかけ「Transformer では、デコーダが入力の文を連続的な表現に変換し、エンコーダがその表現から出力の文を1語ずつ生成する」は誤り。エンコーダとデコーダの役割が逆である。論文は、エンコーダが入力の系列を連続的な表現に対応づけ、デコーダがその表現をもとに出力の系列を1要素ずつ生成すると説明している。通訳にたとえると、エンコーダは話を聞いて中身を頭の中で整理する役、デコーダは整理した中身を別の言葉で1語ずつ話す役である。
- ひっかけ「Transformer は自己注意だけで文全体を見渡せるため、入力に語の位置の情報を加える必要はない」は誤り。論文は、再帰も畳み込みも持たないモデルで語順を使えるよう、位置の情報(位置エンコーディング)を入力に加えるとしている。自己注意は語どうしの関係を一度に見るが、そのままでは何番目の語かが分からない。「犬が人をかんだ」と「人が犬をかんだ」は同じ語でも意味が違うので、順番の情報を別に付ける必要がある。
- ひっかけ「Transformer は、画像の分類の精度を高めるために提案されたモデルで、論文でも画像認識のタスクで性能が示された」は誤り。論文が性能を示したのは画像認識ではなく、英語からドイツ語・フランス語への機械翻訳という自然言語処理のタスクである。さらに英語の構文解析(文の組み立ての分析)にもうまく当てはまることを示した。自然言語処理とは、人が日常で使う言葉をコンピュータで扱う技術のことで、翻訳アプリやメールの自動要約もその例である。
- ひっかけ「BERT は、GPT と同じく、前にある語だけに注意を向ける一方向(左から右)の Transformer として事前学習するモデルである」は誤り。一方向ではなく双方向である。BERT の論文は、BERT の構造を多層の双方向の Transformer エンコーダとし、GPT が前の語だけに注意を向ける左から右への構造だったのに対し、BERT はすべての層で左右両方の文脈を使うと述べている。双方向とは、ある語の意味を、その前と後ろの両方の語から決めること。穴あきの文の空欄を、前の文だけでなく後ろの文も読んで埋めるやり方にあたる。
02試験で正誤を分けるチェック順
- 1Transformer(2017年の論文「Attention Is All You Need」)は、再帰(RNN)や畳み込みを使わず、文中の語どうしの関係を注意機構で扱うモデルの構造である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2Transformer 以前の有力な翻訳などのモデルは、RNN や CNN のエンコーダ・デコーダに注意機構を組み合わせていた。Transformer は再帰と畳み込みそのものを取り除いた。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3自己注意(Self-Attention)は、1つの文(系列)の中の異なる位置にある語どうしを関係づけて、その文の表現を計算する注意機構である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4注意の仕組みは、Query(問い合わせ)と Key(見出し)の適合度から重みを決め、その重みで Value(中身)を足し合わせて出力を作る。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5注意の出力は、Query と Key の適合度で決めた重みを Value に掛けて足し合わせたものである(重みを掛ける相手は Key ではない)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6Transformer は再帰を使わないため並列に計算しやすく、学習時間を大きく減らせた。再帰の層は文の長さに比例した順番の処理が要るが、自己注意の層は一定の回数で済む。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7再帰の層は前の語の結果を待って次へ進むため並列化しにくい。自己注意の層はすべての位置を一定の回数の処理でつなぐため、並列に計算しやすい。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8離れた位置の語どうしの関係(長距離依存)を学ぶことは文の処理の大きな課題で、位置どうしをつなぐ経路が短いほど学びやすい。自己注意はどの2つの位置も短い経路で結ぶ。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9Transformer はエンコーダとデコーダからなる。エンコーダは入力の文を連続的な表現(数値の並び)に変え、デコーダはそれを使って出力の文を1要素ずつ生成する。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10デコーダは、それまでに生成した語を次の入力に加えて次の語を生成する(自己回帰)。予測がまだ生成していない先の位置を参照しないよう、先の位置は隠す(マスクする)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11Transformer は再帰も畳み込みも持たないので、語の順番を使えるように、各語の位置の情報(位置エンコーディング)を入力に加える。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12Transformer の論文は、英語からドイツ語・フランス語への機械翻訳という自然言語処理のタスクで性能を示し、英語の構文解析にも当てはまることを示した。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13GPT-3 は GPT-2 の構造を受け継ぎ(層の中の注意のかけ方の一部は変更)、Transformer の層を重ねた自己回帰型の言語モデルである。Transformer は後の大規模言語モデルの土台になった。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14注意機構は文章以外にも広がった。潜在拡散モデル(LDM)は、クロスアテンションの層を加えて、文章などの条件から画像を生成できるようにした。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 15BERT(2018年の論文)は、Transformer のエンコーダを重ねたモデルで、すべての層で左右両方の文脈を使う(双方向)。GPT は前にある語だけに注意を向ける一方向(左から右)の構造である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
Transformerと自己注意機構・派生モデルの系譜の○×一問一答
1/8問解答 0・正解 0
生成AI
Transformerと自己注意機構・派生モデルの系譜|再帰を使わない構造
Transformer は、再帰や畳み込みを使わず、文中の語どうしの関係を注意機構で捉えるネットワークの構造として提案された。
Transformerと自己注意機構・派生モデルの系譜の○×一問一答15問|問題と解説
この論点で収録している15問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
Transformerと自己注意機構・派生モデルの系譜|再帰を使わない構造Transformer は、再帰や畳み込みを使わず、文中の語どうしの関係を注意機構で捉えるネットワークの構造として提案された。
答え:○(正しい)
解説
正しい。論文「Attention Is All You Need」は、Transformer を、再帰と畳み込みを取り除き、注意機構に基づく新しい構造として提案している。各層には注意機構のほかに、語ごとに情報を変換する層(フィードフォワード層)もある。注意機構とは、文中のどの語に注目すべきかを重みで決める仕組みのこと。会議の議事録を読むとき、1行ずつ順番に追うのではなく、関係する発言どうしに線を引いて一度に見比べるような読み方にあたる。 要点:Transformer(2017年の論文「Attention Is All You Need」)は、再帰(RNN)や畳み込みを使わず、文中の語どうしの関係を注意機構で扱うモデルの構造である。
問2
Transformerと自己注意機構・派生モデルの系譜|以前のモデルとの違いTransformer は、RNN の再帰の仕組みを土台にし、そこへ注意機構を付け足すことで性能を高めたモデルである。
答え:×(誤り)
解説
誤り。再帰の仕組みを土台にしたのではなく、取り除いた点が新しい。論文は、それまでの有力なモデルが再帰型や畳み込み型のネットワークに注意機構を組み合わせていたのに対し、Transformer は再帰と畳み込みを使わず注意機構に基づいて組んだと述べている。RNN(再帰型ニューラルネットワーク)は、文を前から1語ずつ順に読み進めるモデルで、伝言ゲームのように前の語の情報を順に受け渡す。 要点:Transformer 以前の有力な翻訳などのモデルは、RNN や CNN のエンコーダ・デコーダに注意機構を組み合わせていた。Transformer は再帰と畳み込みそのものを取り除いた。
問3
Transformerと自己注意機構・派生モデルの系譜|自己注意とは自己注意機構(Self-Attention)は、1つの文の中の異なる位置にある語どうしを関係づけて、その文の表現を計算する仕組みである。
答え:○(正しい)
解説
正しい。論文は自己注意を「1つの系列の異なる位置を関係づけて、その系列の表現を計算する注意機構」と説明している。たとえば「部長は資料を課長に渡したが、彼はまだ読んでいない」という文で、「彼」が誰を指すかを決めるには、文中のほかの語との関係を見比べる必要がある。自己注意は、このような同じ文の中の語どうしの関係を計算に取り込む。 要点:自己注意(Self-Attention)は、1つの文(系列)の中の異なる位置にある語どうしを関係づけて、その文の表現を計算する注意機構である。
問4
Transformerと自己注意機構・派生モデルの系譜|Query・Key・Value注意の仕組みでは、Query と各 Key の適合度から重みを求め、その重みで Value を足し合わせたものを出力とする。
答え:○(正しい)
解説
正しい。論文は、注意の関数を Query と Key・Value の組を出力に対応づけるものとし、出力は Value の重み付きの和で、各 Value の重みは Query と対応する Key の適合度で決まると説明している。図書館で調べものをするとき、知りたいこと(Query)を本の見出し(Key)と照らし、合う本ほど中身(Value)を多く読む、という流れにたとえられる。 要点:注意の仕組みは、Query(問い合わせ)と Key(見出し)の適合度から重みを決め、その重みで Value(中身)を足し合わせて出力を作る。
問5
Transformerと自己注意機構・派生モデルの系譜|重みを掛ける相手注意の仕組みでは、Query と各 Key の適合度から重みを求め、その重みで Key を足し合わせたものを出力とする。
答え:×(誤り)
解説
誤り。重みを掛けて足し合わせるのは Key ではなく Value である。Key は Query と照らし合わせて「どれだけ注目するか」を決めるための見出しの役で、出力の材料になる中身は Value が受け持つ。図書館のたとえなら、本の見出し(Key)で読む量を決め、実際に読み取るのは本文(Value)である。 要点:注意の出力は、Query と Key の適合度で決めた重みを Value に掛けて足し合わせたものである(重みを掛ける相手は Key ではない)。
問6
Transformerと自己注意機構・派生モデルの系譜|並列に計算しやすいTransformer は、再帰を使うモデルよりも並列に計算しやすく、学習にかかる時間を大きく減らせることが示された。
答え:○(正しい)
解説
正しい。論文の要旨は、機械翻訳の実験で Transformer が品質で上回りながら、より並列化しやすく、学習に要する時間が大幅に少ないことを示したと述べている。並列処理とは、複数の計算を同時に進めること。書類の確認を1人が順番に回すより、ページを分けて全員で同時に見るほうが早く終わるのと同じで、大量のデータで学習する大規模なモデルに向いていた。 要点:Transformer は再帰を使わないため並列に計算しやすく、学習時間を大きく減らせた。再帰の層は文の長さに比例した順番の処理が要るが、自己注意の層は一定の回数で済む。
問7
Transformerと自己注意機構・派生モデルの系譜|並列化の向きTransformer は、文の先頭から1語ずつ順番に処理する必要があるため、RNN よりも並列に計算しにくい。
答え:×(誤り)
解説
誤り。説明が逆である。論文は、再帰の層は文の長さに比例した回数の順番の処理が必要だが、自己注意の層はすべての位置を一定の回数の処理でつなぐとしている。1語ずつ順に処理しなければならないのは RNN のほうである。行列に並ぶ受付窓口が1つしかない RNN に対し、Transformer は窓口をたくさん開けて同時に受け付けるイメージである。 要点:再帰の層は前の語の結果を待って次へ進むため並列化しにくい。自己注意の層はすべての位置を一定の回数の処理でつなぐため、並列に計算しやすい。
問8
Transformerと自己注意機構・派生モデルの系譜|長距離依存自己注意は文中のどの2つの位置も短い経路で直接つなぐため、離れた位置にある語どうしの関係(長距離依存)を捉えやすい。
答え:○(正しい)
解説
正しい。論文は、長距離依存の学習が大きな課題で、入力と出力の位置どうしを結ぶ経路が短いほど学びやすいと述べ、自己注意の層がすべての位置を一定の回数の処理でつなぐ点を利点に挙げている。長い契約書で、冒頭の「甲」が数ページ後の条文の主語になっているような関係を、途中の文を順にたどらずに直接結びつけられる、ということである。 要点:離れた位置の語どうしの関係(長距離依存)を学ぶことは文の処理の大きな課題で、位置どうしをつなぐ経路が短いほど学びやすい。自己注意はどの2つの位置も短い経路で結ぶ。
問9
Transformerと自己注意機構・派生モデルの系譜|エンコーダとデコーダTransformer では、デコーダが入力の文を連続的な表現に変換し、エンコーダがその表現から出力の文を1語ずつ生成する。
答え:×(誤り)
解説
誤り。エンコーダとデコーダの役割が逆である。論文は、エンコーダが入力の系列を連続的な表現に対応づけ、デコーダがその表現をもとに出力の系列を1要素ずつ生成すると説明している。通訳にたとえると、エンコーダは話を聞いて中身を頭の中で整理する役、デコーダは整理した中身を別の言葉で1語ずつ話す役である。 要点:Transformer はエンコーダとデコーダからなる。エンコーダは入力の文を連続的な表現(数値の並び)に変え、デコーダはそれを使って出力の文を1要素ずつ生成する。
問10
Transformerと自己注意機構・派生モデルの系譜|自己回帰とマスクTransformer のデコーダは、それまでに生成した語を次の入力に加えながら次の語を生成し、まだ生成していない先の位置は参照しないようにしている。
答え:○(正しい)
解説
正しい。論文は、デコーダは各ステップで自己回帰的で、前に生成した記号を追加の入力として次を生成すると述べる。また、位置 i の予測が i より前の出力だけに依存するよう、先の位置にマスク(目隠し)をかけている。テストの答案を書くとき、模範解答の続きを見ずに、自分が書いた前の文だけを手がかりに次の文を書く、というルールにあたる。 要点:デコーダは、それまでに生成した語を次の入力に加えて次の語を生成する(自己回帰)。予測がまだ生成していない先の位置を参照しないよう、先の位置は隠す(マスクする)。
問11
Transformerと自己注意機構・派生モデルの系譜|語順の情報Transformer は自己注意だけで文全体を見渡せるため、入力に語の位置の情報を加える必要はない。
答え:×(誤り)
解説
誤り。論文は、再帰も畳み込みも持たないモデルで語順を使えるよう、位置の情報(位置エンコーディング)を入力に加えるとしている。自己注意は語どうしの関係を一度に見るが、そのままでは何番目の語かが分からない。「犬が人をかんだ」と「人が犬をかんだ」は同じ語でも意味が違うので、順番の情報を別に付ける必要がある。 要点:Transformer は再帰も畳み込みも持たないので、語の順番を使えるように、各語の位置の情報(位置エンコーディング)を入力に加える。
問12
Transformerと自己注意機構・派生モデルの系譜|最初に試したタスクTransformer は、画像の分類の精度を高めるために提案されたモデルで、論文でも画像認識のタスクで性能が示された。
答え:×(誤り)
解説
誤り。論文が性能を示したのは画像認識ではなく、英語からドイツ語・フランス語への機械翻訳という自然言語処理のタスクである。さらに英語の構文解析(文の組み立ての分析)にもうまく当てはまることを示した。自然言語処理とは、人が日常で使う言葉をコンピュータで扱う技術のことで、翻訳アプリやメールの自動要約もその例である。 要点:Transformer の論文は、英語からドイツ語・フランス語への機械翻訳という自然言語処理のタスクで性能を示し、英語の構文解析にも当てはまることを示した。
問13
Transformerと自己注意機構・派生モデルの系譜|GPT へのつながりGPT-3 は、GPT-2 の基本の構造を受け継ぎ、Transformer の層を重ねて作られた自己回帰型の言語モデルである。
答え:○(正しい)
解説
正しい。GPT-3 の論文は、GPT-3 を自己回帰型の言語モデルとし、GPT-2 と同じモデルと構造を使うが、Transformer の層の注意のかけ方(全体を見る注意と近くだけを見る注意を交互に使う)は変えたと述べている。自己回帰型とは、それまでの文章から次の語を1つずつ予測して書き足していく方式のこと。Transformer という設計図をもとに、細部を手直ししながら規模を大きくした建物を次々に建てていった流れが GPT シリーズである。 要点:GPT-3 は GPT-2 の構造を受け継ぎ(層の中の注意のかけ方の一部は変更)、Transformer の層を重ねた自己回帰型の言語モデルである。Transformer は後の大規模言語モデルの土台になった。
問14
Transformerと自己注意機構・派生モデルの系譜|画像生成への広がり画像を生成する潜在拡散モデル(LDM)は、クロスアテンションの層を取り入れて、文章などを条件に画像を生成できるようにした。
答え:○(正しい)
解説
正しい。LDM の論文の要旨は、モデルの構造にクロスアテンションの層を導入し、文章や範囲の指定(バウンディングボックス)などの条件から生成できるようにしたと述べている。クロスアテンションは、画像を作る側が文章の指示のどの語に注目するかを決める注意機構である。「赤い傘をさした人」という指示の「赤い」「傘」に注目しながら絵を描き進めるイメージである。 要点:注意機構は文章以外にも広がった。潜在拡散モデル(LDM)は、クロスアテンションの層を加えて、文章などの条件から画像を生成できるようにした。
問15
Transformerと自己注意機構・派生モデルの系譜|BERT は双方向BERT は、GPT と同じく、前にある語だけに注意を向ける一方向(左から右)の Transformer として事前学習するモデルである。
答え:×(誤り)
解説
誤り。一方向ではなく双方向である。BERT の論文は、BERT の構造を多層の双方向の Transformer エンコーダとし、GPT が前の語だけに注意を向ける左から右への構造だったのに対し、BERT はすべての層で左右両方の文脈を使うと述べている。双方向とは、ある語の意味を、その前と後ろの両方の語から決めること。穴あきの文の空欄を、前の文だけでなく後ろの文も読んで埋めるやり方にあたる。 要点:BERT(2018年の論文)は、Transformer のエンコーダを重ねたモデルで、すべての層で左右両方の文脈を使う(双方向)。GPT は前にある語だけに注意を向ける一方向(左から右)の構造である。
Transformerと自己注意機構・派生モデルの系譜の問題を続けて解く
この論点に対応する15問を絞り込んで出題します。