生成AI
RLHF・学習データの課題・スケーリング則
RLHF(人間のフィードバックによる強化学習)は、人が出力を比べて順位を付けたデータで報酬モデルを学習し、その報酬が高くなるよう強化学習でモデルを調整する方法です。学習データは量だけでなく品質・偏り(バイアス)・評価用データの混入・著作権が課題になります。スケーリング則は、ほかが足かせにならない条件で、モデル・データ・計算量を大きくすると誤差がべき乗則に従って下がるという経験則、と押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
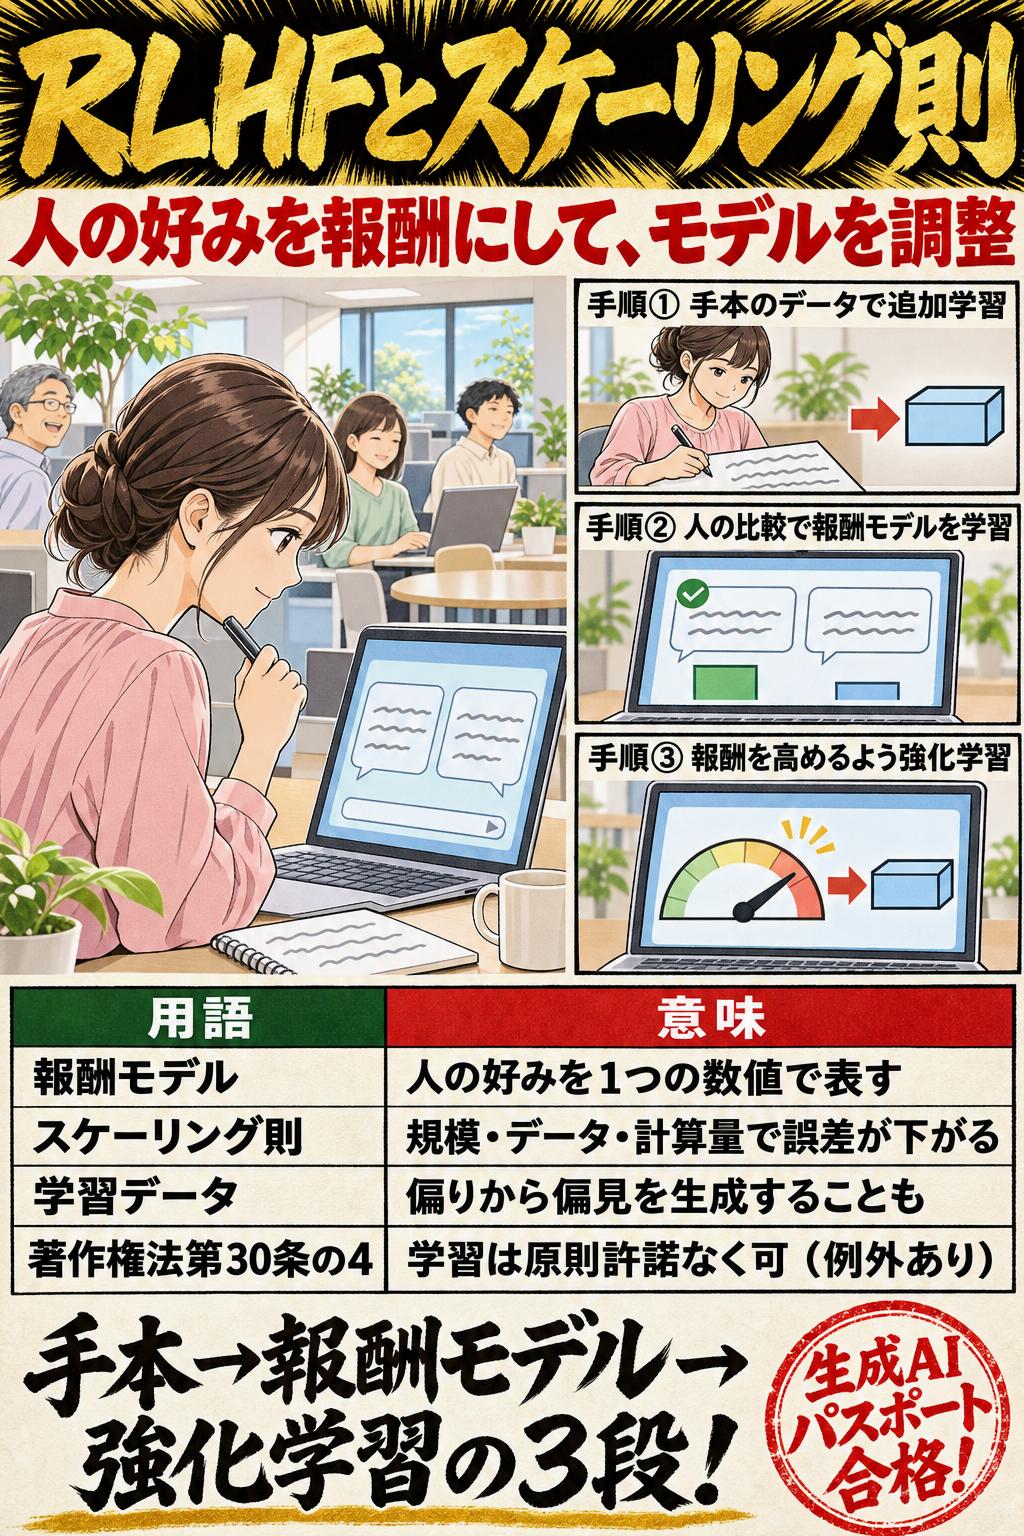
RLHF(人間のフィードバックによる強化学習)は、人が出力を比べて順位を付けたデータで報酬モデルを学習し、その報酬が高くなるよう強化学習でモデルを調整する方法です。学習データは量だけでなく品質・偏り(バイアス)・評価用データの混入・著作権が課題になります。スケーリング則は、ほかが足かせにならない条件で、モデル・データ・計算量を大きくすると誤差がべき乗則に従って下がるという経験則、と押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 14問
RLHF・学習データの課題・スケーリング則|RLHF の流れ
InstructGPT は、①手本のデータで教師ありファインチューニング、②人が出力を比べたデータで報酬モデルを学習、③その報酬を高めるよう強化学習でモデルを調整、の順で作られた。
比較して覚える
InstructGPTの3段階(教師ありFT・報酬モデル・強化学習)
InstructGPT の論文が示した、人の好みに合わせる3つの段を並べます。人が手本を書くのはどの段か、人が出力を比べるのはどの段か、強化学習を使うのはどの段かの取り違えを、この表で切り分けます。
| 事由 | ①教師ありファインチューニング | ②報酬モデルの学習 | ③強化学習 |
|---|---|---|---|
| 使うデータ | 人(ラベラー)が書いた望ましい応答の手本 | 人がモデルの出力を比べて付けた順位 | 報酬モデルが出す報酬(点数) |
| 何を学ぶか | 手本どおりに応答すること | プロンプトと応答から、人がどれだけ好むかを1つの数値で予測すること | 報酬が高くなる応答の仕方(PPO というアルゴリズム) |
| 人の関わり方 | 手本を書く | どちらの出力が好ましいかを選ぶ | 直接は関わらない(人の好みを覚えた報酬モデルが採点する) |
| 身近なたとえ | 先輩の模範回答をまねて書く | 上司が複数の案を比べて「こちらが良い」と選び、採点の基準を作る | 採点係の点数が上がるよう書き方を磨く |
使うデータ
- ①教師ありファインチューニング
- 人(ラベラー)が書いた望ましい応答の手本
- ②報酬モデルの学習
- 人がモデルの出力を比べて付けた順位
- ③強化学習
- 報酬モデルが出す報酬(点数)
何を学ぶか
- ①教師ありファインチューニング
- 手本どおりに応答すること
- ②報酬モデルの学習
- プロンプトと応答から、人がどれだけ好むかを1つの数値で予測すること
- ③強化学習
- 報酬が高くなる応答の仕方(PPO というアルゴリズム)
人の関わり方
- ①教師ありファインチューニング
- 手本を書く
- ②報酬モデルの学習
- どちらの出力が好ましいかを選ぶ
- ③強化学習
- 直接は関わらない(人の好みを覚えた報酬モデルが採点する)
身近なたとえ
- ①教師ありファインチューニング
- 先輩の模範回答をまねて書く
- ②報酬モデルの学習
- 上司が複数の案を比べて「こちらが良い」と選び、採点の基準を作る
- ③強化学習
- 採点係の点数が上がるよう書き方を磨く
この論点の用語
用語集をすべて見る →01RLHF・学習データの課題・スケーリング則の重要暗記項目
RLHF・学習データの課題・スケーリング則|RLHF の流れ
InstructGPT は、①手本のデータで教師ありファインチューニング、②人が出力を比べたデータで報酬モデルを学習、③その報酬を高めるよう強化学習でモデルを調整、の順で作られた。
RLHF・学習データの課題・スケーリング則|報酬モデルの役割
報酬モデルは、プロンプトと応答を受け取り、人がその出力をどれだけ好むかを表す1つの数値(報酬)を出す。
RLHF・学習データの課題・スケーリング則|報酬は人の好みから
RLHF は、人の好み(どの出力が好ましいか)を報酬の信号として使って、モデルをファインチューニングする。
ひっかけ注意「RLHF の報酬モデルは、人の評価を使わず、インターネット上の大量の文章から次のトークンを予測することで学習される」は誤り。 報酬モデルの学習に使うのは、人(ラベラー)がモデルの出力を比べてどれが好ましいかを示したデータである。次のトークンの予測は事前学習の目的である。InstructGPT の論文は、この手法が人の好みを報酬の信号として使ってモデルをファインチューニングすると述べている。採点基準を作るのに、本の続きを当てる練習ではなく、実際の上司の評価を集める、という違いである。
RLHF・学習データの課題・スケーリング則|最後の段は強化学習
RLHF の最後の段では、報酬モデルが出す報酬を高めるよう、強化学習(PPO というアルゴリズム)でモデルを調整する。
ひっかけ注意「InstructGPT の3段目では、報酬モデルの点数を高めるよう、正解のラベルを付けたデータによる教師あり学習だけでモデルを調整した」は誤り。 3段目は教師あり学習ではなく強化学習である。InstructGPT の論文は、教師ありで調整したモデルを、報酬モデルの報酬を最大にするよう PPO というアルゴリズムでファインチューニングしたと述べている。正解を1つ見せてまねさせる(教師あり)のではなく、何度も答えを出させて点数の高い答え方を伸ばしていく、という学び方の違いである。
RLHF・学習データの課題・スケーリング則|大きくするだけでは足りない
言語モデルを大きくしても、それだけで利用者の意図に従うのが上手になるわけではない。大きなモデルでも、事実と違う・有害・役に立たない出力をすることがある。
RLHF・学習データの課題・スケーリング則|小さくても好まれた
人の評価では、パラメータが100分の1以下(175B の約135分の1)の 1.3B(13億)の InstructGPT の出力が、175B(1750億)の GPT-3 の出力より好まれた。
ひっかけ注意「InstructGPT の論文の人による評価では、パラメータが100倍以上多い GPT-3(175B)の出力のほうが、1.3B の InstructGPT の出力より好まれた」は誤り。 結果が逆である。人による評価では、パラメータが100分の1以下(約135分の1)の 1.3B の InstructGPT の出力が、175B の GPT-3 の出力より好まれた。パラメータとはモデルの中で学習によって決まる数値のことで、その数が規模の目安になる。体格の大きい選手より、指導を受けて基本を身につけた選手のほうが試合で評価された、という結果にたとえられる。
RLHF・学習データの課題・スケーリング則|学習データの質
GPT-3 では、ウェブを集めたデータ(Common Crawl)を、質の高い参照用のデータとの似かたで絞り込んで使った。絞り込まないウェブのデータは、選び抜いたデータより質が低い傾向がある。
RLHF・学習データの課題・スケーリング則|評価データの混入
ウェブの大規模なデータで学習すると、評価に使う試験問題(ベンチマーク)が学習データに混ざる(汚染する)おそれがある。GPT-3 では重なりの一部しか取り除けなかった。
ひっかけ注意「GPT-3 の論文は、学習データとベンチマークの試験データの重なりを、絞り込みの処理によってすべて取り除けたと報告している」は誤り。 GPT-3 の論文は、絞り込みの不具合で、見つけた重なりの一部しか学習データから取り除けなかったと述べ、ベンチマークの試験データの一部で学習していた可能性があるとしている。ベンチマークとは、性能を比べるための共通の試験問題のこと。試験問題が事前に教材に混ざっていると、本当の実力より高い点が出てしまうおそれがある。
覚える数字と、狙われる引っかけ
- ひっかけ「RLHF の報酬モデルは、人の評価を使わず、インターネット上の大量の文章から次のトークンを予測することで学習される」は誤り。報酬モデルの学習に使うのは、人(ラベラー)がモデルの出力を比べてどれが好ましいかを示したデータである。次のトークンの予測は事前学習の目的である。InstructGPT の論文は、この手法が人の好みを報酬の信号として使ってモデルをファインチューニングすると述べている。採点基準を作るのに、本の続きを当てる練習ではなく、実際の上司の評価を集める、という違いである。
- ひっかけ「InstructGPT の3段目では、報酬モデルの点数を高めるよう、正解のラベルを付けたデータによる教師あり学習だけでモデルを調整した」は誤り。3段目は教師あり学習ではなく強化学習である。InstructGPT の論文は、教師ありで調整したモデルを、報酬モデルの報酬を最大にするよう PPO というアルゴリズムでファインチューニングしたと述べている。正解を1つ見せてまねさせる(教師あり)のではなく、何度も答えを出させて点数の高い答え方を伸ばしていく、という学び方の違いである。
- ひっかけ「InstructGPT の論文の人による評価では、パラメータが100倍以上多い GPT-3(175B)の出力のほうが、1.3B の InstructGPT の出力より好まれた」は誤り。結果が逆である。人による評価では、パラメータが100分の1以下(約135分の1)の 1.3B の InstructGPT の出力が、175B の GPT-3 の出力より好まれた。パラメータとはモデルの中で学習によって決まる数値のことで、その数が規模の目安になる。体格の大きい選手より、指導を受けて基本を身につけた選手のほうが試合で評価された、という結果にたとえられる。
- ひっかけ「GPT-3 の論文は、学習データとベンチマークの試験データの重なりを、絞り込みの処理によってすべて取り除けたと報告している」は誤り。GPT-3 の論文は、絞り込みの不具合で、見つけた重なりの一部しか学習データから取り除けなかったと述べ、ベンチマークの試験データの一部で学習していた可能性があるとしている。ベンチマークとは、性能を比べるための共通の試験問題のこと。試験問題が事前に教材に混ざっていると、本当の実力より高い点が出てしまうおそれがある。
- ひっかけ「学習データから人種や性別などのセンシティブな属性を取り除けば、関連する情報から属性が類推されることはなく、バイアスは生じなくなる」は誤り。AI事業者ガイドラインは潜在的なバイアスの例として、明らかなセンシティブ属性を取り除いたデータであっても、関連する情報からセンシティブ属性が類推される場合や、複数の属性の組み合わせによってバイアスが生じる場合(交差バイアス)を挙げている。採用の書類から性別の欄を消しても、部活動や名前などから性別が推し量れてしまう、といった状況にあたる。
- ひっかけ「スケーリング則の論文は、モデルの性能を最も大きく左右するのは、ネットワークの幅や深さといった構造の細部であると結論づけた」は誤り。論文の要旨は、ネットワークの幅や深さなどの構造の細部は、広い範囲で影響が小さいと述べている。性能を大きく左右するのは、モデルの大きさ・データセットの大きさ・計算量である。建物にたとえると、細い高層にするか太い低層にするかより、延べ床面積をどれだけ確保するかのほうが効いた、という結果である。
02試験で正誤を分けるチェック順
- 1InstructGPT は、①手本のデータで教師ありファインチューニング、②人が出力を比べたデータで報酬モデルを学習、③その報酬を高めるよう強化学習でモデルを調整、の順で作られた。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2報酬モデルは、プロンプトと応答を受け取り、人がその出力をどれだけ好むかを表す1つの数値(報酬)を出す。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3RLHF は、人の好み(どの出力が好ましいか)を報酬の信号として使って、モデルをファインチューニングする。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4RLHF の最後の段では、報酬モデルが出す報酬を高めるよう、強化学習(PPO というアルゴリズム)でモデルを調整する。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5言語モデルを大きくしても、それだけで利用者の意図に従うのが上手になるわけではない。大きなモデルでも、事実と違う・有害・役に立たない出力をすることがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6人の評価では、パラメータが100分の1以下(175B の約135分の1)の 1.3B(13億)の InstructGPT の出力が、175B(1750億)の GPT-3 の出力より好まれた。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7GPT-3 では、ウェブを集めたデータ(Common Crawl)を、質の高い参照用のデータとの似かたで絞り込んで使った。絞り込まないウェブのデータは、選び抜いたデータより質が低い傾向がある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8ウェブの大規模なデータで学習すると、評価に使う試験問題(ベンチマーク)が学習データに混ざる(汚染する)おそれがある。GPT-3 では重なりの一部しか取り除けなかった。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9学習データにある偏り(バイアス)によって、モデルが固定観念や偏見を含む内容を生成することがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10人種や性別などのセンシティブな属性を取り除いたデータでも、関連する情報から属性が類推されたり、属性の組み合わせで偏りが生じたり(交差バイアス)することがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11AI の学習のための情報解析は、著作物を鑑賞などで楽しむ(享受する)ことを目的としない利用として、必要な限度で原則として許諾なく行えるが、著作権者の利益を不当に害することとなる場合は除かれる(著作権法第30条の4)。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12スケーリング則:ほかの2つが足かせにならない条件では、言語モデルの誤差(損失)は、モデルの大きさ・データの量・学習に使う計算量を大きくするほど、べき乗則に従って下がる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13スケーリング則の論文では、ネットワークの幅や深さなどの構造の細かい違いは、広い範囲で性能への影響が小さかった。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 14途中の推論の手順を書かせる「思考の連鎖」のプロンプトで引き出せる推論の能力は、十分に大きな言語モデルで自然に現れる(emerge)ことが示された。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
RLHF・学習データの課題・スケーリング則の○×一問一答
1/8問解答 0・正解 0
生成AI
RLHF・学習データの課題・スケーリング則|RLHF の流れ
InstructGPT では、教師ありファインチューニングのあと、人が出力を比べて順位を付けたデータで報酬モデルを学習し、その報酬を高めるよう強化学習でモデルをさらに調整した。
RLHF・学習データの課題・スケーリング則の○×一問一答14問|問題と解説
この論点で収録している14問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
RLHF・学習データの課題・スケーリング則|RLHF の流れInstructGPT では、教師ありファインチューニングのあと、人が出力を比べて順位を付けたデータで報酬モデルを学習し、その報酬を高めるよう強化学習でモデルをさらに調整した。
答え:○(正しい)
解説
正しい。InstructGPT の論文は、手本のデータで GPT-3 を教師ありでファインチューニングしたあと、モデルの出力の順位付けのデータを集め、人間のフィードバックによる強化学習(RLHF)でさらにファインチューニングしたと述べている。強化学習とは、よい結果に点数(報酬)を与えて、点数が上がる行動を覚えさせる学び方。上司が複数の案を比べて「こっちが良い」と返し続けることで、部下の書き方が上司の好みに近づくイメージである。 要点:InstructGPT は、①手本のデータで教師ありファインチューニング、②人が出力を比べたデータで報酬モデルを学習、③その報酬を高めるよう強化学習でモデルを調整、の順で作られた。
問2
RLHF・学習データの課題・スケーリング則|報酬モデルの役割RLHF の報酬モデルは、プロンプトと応答を入力として受け取り、人が好む度合いを表す1つの数値(報酬)を出力するように学習される。
答え:○(正しい)
解説
正しい。InstructGPT の論文は、報酬モデルを、プロンプトと応答を受け取って1つの数値の報酬を出すモデルとして学習し、ラベラー(評価する人)がどの出力を好むかを予測させたと説明している。人が毎回すべての回答を採点するのは大変なので、人の採点の癖を覚えた「自動の採点係」を作る、ということである。 要点:報酬モデルは、プロンプトと応答を受け取り、人がその出力をどれだけ好むかを表す1つの数値(報酬)を出す。
問3
RLHF・学習データの課題・スケーリング則|報酬は人の好みからRLHF の報酬モデルは、人の評価を使わず、インターネット上の大量の文章から次のトークンを予測することで学習される。
答え:×(誤り)
解説
誤り。報酬モデルの学習に使うのは、人(ラベラー)がモデルの出力を比べてどれが好ましいかを示したデータである。次のトークンの予測は事前学習の目的である。InstructGPT の論文は、この手法が人の好みを報酬の信号として使ってモデルをファインチューニングすると述べている。採点基準を作るのに、本の続きを当てる練習ではなく、実際の上司の評価を集める、という違いである。 要点:RLHF は、人の好み(どの出力が好ましいか)を報酬の信号として使って、モデルをファインチューニングする。
問4
RLHF・学習データの課題・スケーリング則|最後の段は強化学習InstructGPT の3段目では、報酬モデルの点数を高めるよう、正解のラベルを付けたデータによる教師あり学習だけでモデルを調整した。
答え:×(誤り)
解説
誤り。3段目は教師あり学習ではなく強化学習である。InstructGPT の論文は、教師ありで調整したモデルを、報酬モデルの報酬を最大にするよう PPO というアルゴリズムでファインチューニングしたと述べている。正解を1つ見せてまねさせる(教師あり)のではなく、何度も答えを出させて点数の高い答え方を伸ばしていく、という学び方の違いである。 要点:RLHF の最後の段では、報酬モデルが出す報酬を高めるよう、強化学習(PPO というアルゴリズム)でモデルを調整する。
問5
RLHF・学習データの課題・スケーリング則|大きくするだけでは足りない言語モデルは大きくするだけでは利用者の意図に従うのが上手になるとは限らず、事実と異なる出力や有害な出力をすることがある。
答え:○(正しい)
解説
正しい。InstructGPT の論文の要旨は、言語モデルを大きくしても本質的に利用者の意図に従うのが上手になるわけではなく、事実と異なる・有害な・役に立たない出力を生成しうると述べている。これを利用者の意図と「合っていない」と表現している。知識が豊富な人でも、相手が何を求めているかをくむ練習をしないと、的外れな答えを返すことがあるのと同じである。 要点:言語モデルを大きくしても、それだけで利用者の意図に従うのが上手になるわけではない。大きなモデルでも、事実と違う・有害・役に立たない出力をすることがある。
問6
RLHF・学習データの課題・スケーリング則|小さくても好まれたInstructGPT の論文の人による評価では、パラメータが100倍以上多い GPT-3(175B)の出力のほうが、1.3B の InstructGPT の出力より好まれた。
答え:×(誤り)
解説
誤り。結果が逆である。人による評価では、パラメータが100分の1以下(約135分の1)の 1.3B の InstructGPT の出力が、175B の GPT-3 の出力より好まれた。パラメータとはモデルの中で学習によって決まる数値のことで、その数が規模の目安になる。体格の大きい選手より、指導を受けて基本を身につけた選手のほうが試合で評価された、という結果にたとえられる。 要点:人の評価では、パラメータが100分の1以下(175B の約135分の1)の 1.3B(13億)の InstructGPT の出力が、175B(1750億)の GPT-3 の出力より好まれた。
問7
RLHF・学習データの課題・スケーリング則|学習データの質GPT-3 の開発では、ウェブから集めた大量の文章(Common Crawl)をそのまま使わず、質の高い参照用のデータと似ているかどうかで絞り込んでから学習に使った。
答え:○(正しい)
解説
正しい。GPT-3 の論文は、Common Crawl を質の高い参照用の文章の集まりとの似かたにもとづいて絞り込んで使ったと述べ、絞り込まないか軽く絞り込んだだけの Common Crawl は、選び抜いたデータより質が低い傾向があるとしている。量を集めるだけでなく質をそろえることも大事、ということ。料理で、たくさんの食材を仕入れても、傷んだものを選り分けないとおいしくならないのと同じである。 要点:GPT-3 では、ウェブを集めたデータ(Common Crawl)を、質の高い参照用のデータとの似かたで絞り込んで使った。絞り込まないウェブのデータは、選び抜いたデータより質が低い傾向がある。
問8
RLHF・学習データの課題・スケーリング則|評価データの混入GPT-3 の論文は、学習データとベンチマークの試験データの重なりを、絞り込みの処理によってすべて取り除けたと報告している。
答え:×(誤り)
解説
誤り。GPT-3 の論文は、絞り込みの不具合で、見つけた重なりの一部しか学習データから取り除けなかったと述べ、ベンチマークの試験データの一部で学習していた可能性があるとしている。ベンチマークとは、性能を比べるための共通の試験問題のこと。試験問題が事前に教材に混ざっていると、本当の実力より高い点が出てしまうおそれがある。 要点:ウェブの大規模なデータで学習すると、評価に使う試験問題(ベンチマーク)が学習データに混ざる(汚染する)おそれがある。GPT-3 では重なりの一部しか取り除けなかった。
問9
RLHF・学習データの課題・スケーリング則|学習データのバイアスGPT-3 の論文は、学習データに含まれるバイアスによって、モデルが固定観念や偏見を含む内容を生成することがあると指摘している。
答え:○(正しい)
解説
正しい。GPT-3 の論文の「公平性・バイアス・表現」の節は、学習データにあるバイアスが、モデルに固定観念にもとづく内容や偏見のある内容を生成させうると述べ、性別・人種・宗教について調べている。バイアスとは偏りのこと。たとえば過去の文章に「看護師は女性」という書き方が多ければ、モデルもそのような前提の文章を書きやすくなりうる。 要点:学習データにある偏り(バイアス)によって、モデルが固定観念や偏見を含む内容を生成することがある。
問10
RLHF・学習データの課題・スケーリング則|属性を除いても残る偏り学習データから人種や性別などのセンシティブな属性を取り除けば、関連する情報から属性が類推されることはなく、バイアスは生じなくなる。
答え:×(誤り)
解説
誤り。AI事業者ガイドラインは潜在的なバイアスの例として、明らかなセンシティブ属性を取り除いたデータであっても、関連する情報からセンシティブ属性が類推される場合や、複数の属性の組み合わせによってバイアスが生じる場合(交差バイアス)を挙げている。採用の書類から性別の欄を消しても、部活動や名前などから性別が推し量れてしまう、といった状況にあたる。 要点:人種や性別などのセンシティブな属性を取り除いたデータでも、関連する情報から属性が類推されたり、属性の組み合わせで偏りが生じたり(交差バイアス)することがある。
問11
RLHF・学習データの課題・スケーリング則|学習データと著作権学習データに著作物を使う場合、情報解析のような享受を目的としない利用であっても、著作権者の利益を不当に害することとなる場合は、著作権法第30条の4による許諾なしの利用は認められない。
答え:○(正しい)
解説
正しい。著作権法第30条の4は、思想又は感情の享受を目的としない利用を必要と認められる限度で認める一方、ただし書で、著作物の種類・用途と利用の態様に照らし著作権者の利益を不当に害することとなる場合は、この限りでないとしている。たとえば、ある作家の作品を大量に集めて分析するのは原則として許されるが、売り物の分析用データベースを丸ごと無断で使うような場合は、ただし書が問題になりうる。 要点:AI の学習のための情報解析は、著作物を鑑賞などで楽しむ(享受する)ことを目的としない利用として、必要な限度で原則として許諾なく行えるが、著作権者の利益を不当に害することとなる場合は除かれる(著作権法第30条の4)。
問12
RLHF・学習データの課題・スケーリング則|スケーリング則スケーリング則の論文は、言語モデルの損失が、モデルの大きさ・データセットの大きさ・学習の計算量のそれぞれに対して、べき乗則に従って変化することを示した。
答え:○(正しい)
解説
正しい。Kaplan らの論文「Scaling Laws for Neural Language Models」は、損失がモデルの大きさ、データセットの大きさ、学習に使った計算量に対してべき乗則でスケールし、その傾向が7桁を超える範囲にわたるものもあると述べている。ただし、それはほかの2つが足かせになっていないときの話である。損失とは、予測の外れ具合のこと。人手だけ増やしても在庫が足りなければ売上が伸びない店のように、どれか1つが足りないと伸びは止まる。 要点:スケーリング則:ほかの2つが足かせにならない条件では、言語モデルの誤差(損失)は、モデルの大きさ・データの量・学習に使う計算量を大きくするほど、べき乗則に従って下がる。
問13
RLHF・学習データの課題・スケーリング則|幅や深さの影響は小さいスケーリング則の論文は、モデルの性能を最も大きく左右するのは、ネットワークの幅や深さといった構造の細部であると結論づけた。
答え:×(誤り)
解説
誤り。論文の要旨は、ネットワークの幅や深さなどの構造の細部は、広い範囲で影響が小さいと述べている。性能を大きく左右するのは、モデルの大きさ・データセットの大きさ・計算量である。建物にたとえると、細い高層にするか太い低層にするかより、延べ床面積をどれだけ確保するかのほうが効いた、という結果である。 要点:スケーリング則の論文では、ネットワークの幅や深さなどの構造の細かい違いは、広い範囲で性能への影響が小さかった。
問14
RLHF・学習データの課題・スケーリング則|大きなモデルで現れる能力思考の連鎖(Chain-of-Thought)のプロンプトの論文は、途中の推論の手順を書かせることで推論の能力を引き出せることと、その能力が十分に大きな言語モデルで自然に現れることを示した。
答え:○(正しい)
解説
正しい。Wei らの論文の要旨は、途中の推論の手順の連なり(思考の連鎖)を生成させると大規模言語モデルの複雑な推論の能力が大きく上がることを示し、その推論の能力は十分に大きな言語モデルで自然に現れると述べている。規模を大きくしたときに、小さなモデルでは見られなかった力が出てくることを、創発的能力と呼ぶことがある。子どもが成長すると、ある時期から急に文章題が解けるようになる様子にたとえられる。 要点:途中の推論の手順を書かせる「思考の連鎖」のプロンプトで引き出せる推論の能力は、十分に大きな言語モデルで自然に現れる(emerge)ことが示された。
RLHF・学習データの課題・スケーリング則の問題を続けて解く
この論点に対応する14問を絞り込んで出題します。