生成AI
トークン化・埋め込み・確率的な次トークン予測
生成AIは、文章をトークン(単語や、単語より細かいサブワードなどの単位)に区切り、各トークンを埋め込みで数値の並び(ベクトル)に変え、次に来るトークンの確率を計算して1つずつ選びながら文章を作ります。確率にもとづいて選ぶため、同じ入力でも出力が変わりうることを押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
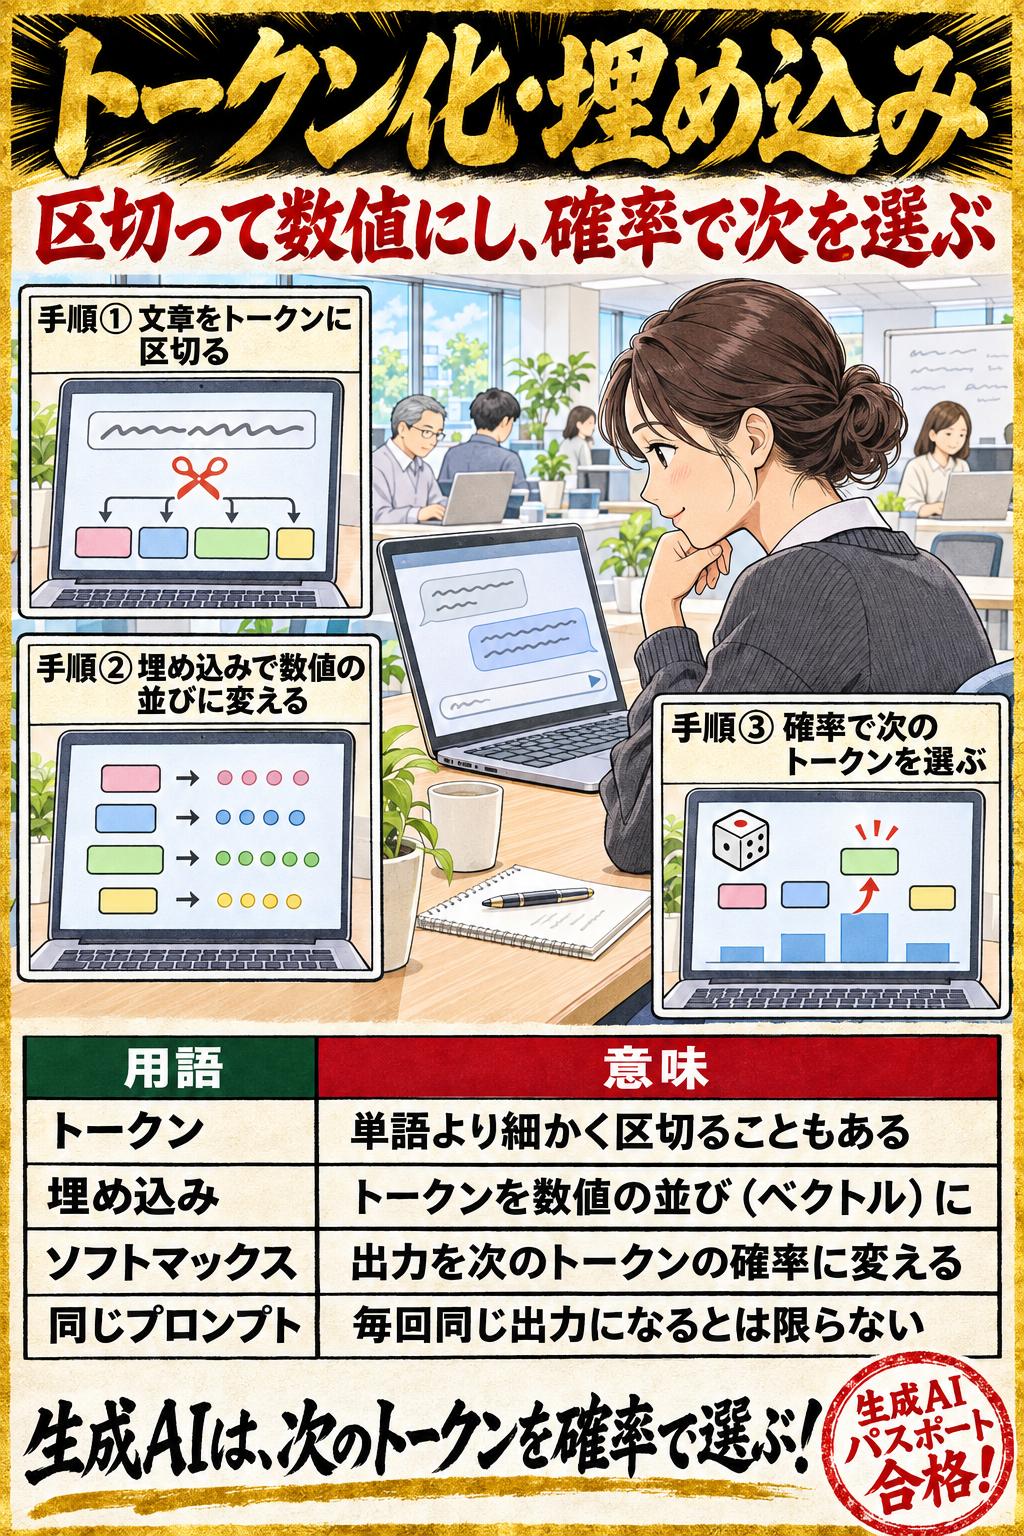
生成AIは、文章をトークン(単語や、単語より細かいサブワードなどの単位)に区切り、各トークンを埋め込みで数値の並び(ベクトル)に変え、次に来るトークンの確率を計算して1つずつ選びながら文章を作ります。確率にもとづいて選ぶため、同じ入力でも出力が変わりうることを押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 11問
トークン化・埋め込み・確率的な次トークン予測|トークン化
トークン化は、文章をモデルが扱う単位(トークン)に区切ることである。Transformer の論文は、文をバイトペア符号化(BPE)などで、単語より細かいサブワードの単位に区切って表した。
この論点の用語
用語集をすべて見る →01トークン化・埋め込み・確率的な次トークン予測の重要暗記項目
トークン化・埋め込み・確率的な次トークン予測|トークン化
トークン化は、文章をモデルが扱う単位(トークン)に区切ることである。Transformer の論文は、文をバイトペア符号化(BPE)などで、単語より細かいサブワードの単位に区切って表した。
トークン化・埋め込み・確率的な次トークン予測|トークン≠単語
トークンは単語と一致するとは限らず、単語より細かいサブワードに区切ることがある。
ひっかけ注意「トークンは必ず1つの単語と一致する単位であり、単語をさらに細かく分けてトークンにすることはない」は誤り。 トークンは単語と一致するとは限らない。Transformer の論文が使ったバイトペア符号化やワードピースのように、単語より細かいサブワードの単位に区切る方法が使われる。長い社名や専門用語を、よく出てくる部品に分けて覚えると、知らない言葉にも対応しやすい。トークンは、モデルにとっての「文字と単語の間くらいの部品」と考えるとよい。
トークン化・埋め込み・確率的な次トークン予測|画像もトークン
トークンはモデルに渡すデータのかたまりで、文章だけでなく画像の入力もトークンとして数える。コンテキストウィンドウの大きさもトークンの数で決まる。
トークン化・埋め込み・確率的な次トークン予測|言語が違うとき
元のモデルと新しいデータの言語が違う場合は、トークン化の方法や語彙の拡張などの調整を検討する。
トークン化・埋め込み・確率的な次トークン予測|埋め込み
埋め込み(Embedding)は、トークンを数値の並び(ベクトル)に変えることである。Transformer は学習した埋め込みで、入力と出力のトークンをベクトルに変える。
トークン化・埋め込み・確率的な次トークン予測|埋め込みは数値にする
埋め込みモデルは、テキストをベクトル表現(数値の並び)に変えるモデルである。
ひっかけ注意「埋め込み(Embedding)とは、トークンを数値に変えずに文字列のまま保存しておき、意味の近い文字列を辞書で探す仕組みのことである」は誤り。 埋め込みは、文字列のまま扱うのではなく、トークンや文章を数値の並び(ベクトル)に変えることである。OpenAI は埋め込みモデルを「テキストをベクトル表現に埋め込むモデル」と案内している(text-embedding-3 など)。数値にすることで、言い方が違っても意味の近い文章を見つけられる。「経費の精算方法」と「立て替えたお金の戻し方」を近い内容として探せる、といった使い方である。
トークン化・埋め込み・確率的な次トークン予測|次のトークンの確率
Transformer のデコーダの出力は、ソフトマックス関数で「次のトークンの予測確率」に変えられる。言語モデルは、この確率の分布をもとに次のトークンを選ぶ。
トークン化・埋め込み・確率的な次トークン予測|1つずつ生成する
自己回帰型の言語モデルは、それまでのトークンを入力に加えて、次のトークンを1つずつ生成する。
ひっかけ注意「GPT-3 のような自己回帰型の言語モデルは、まず文章全体を一度にまとめて決め、そのあと各トークンの確率を計算する」は誤り。 自己回帰型のモデルは、文章全体を先に決めるのではなく、それまでに生成したトークンを入力に加えながら、次のトークンを1つずつ生成する。Transformer の論文はデコーダを各ステップで自己回帰的とし、GPT-3 は自己回帰型の言語モデルである。しりとりのように、前に出た語を見てから次の語を決めることを繰り返して文章ができあがる。
覚える数字と、狙われる引っかけ
- ひっかけ「トークンは必ず1つの単語と一致する単位であり、単語をさらに細かく分けてトークンにすることはない」は誤り。トークンは単語と一致するとは限らない。Transformer の論文が使ったバイトペア符号化やワードピースのように、単語より細かいサブワードの単位に区切る方法が使われる。長い社名や専門用語を、よく出てくる部品に分けて覚えると、知らない言葉にも対応しやすい。トークンは、モデルにとっての「文字と単語の間くらいの部品」と考えるとよい。
- ひっかけ「埋め込み(Embedding)とは、トークンを数値に変えずに文字列のまま保存しておき、意味の近い文字列を辞書で探す仕組みのことである」は誤り。埋め込みは、文字列のまま扱うのではなく、トークンや文章を数値の並び(ベクトル)に変えることである。OpenAI は埋め込みモデルを「テキストをベクトル表現に埋め込むモデル」と案内している(text-embedding-3 など)。数値にすることで、言い方が違っても意味の近い文章を見つけられる。「経費の精算方法」と「立て替えたお金の戻し方」を近い内容として探せる、といった使い方である。
- ひっかけ「GPT-3 のような自己回帰型の言語モデルは、まず文章全体を一度にまとめて決め、そのあと各トークンの確率を計算する」は誤り。自己回帰型のモデルは、文章全体を先に決めるのではなく、それまでに生成したトークンを入力に加えながら、次のトークンを1つずつ生成する。Transformer の論文はデコーダを各ステップで自己回帰的とし、GPT-3 は自己回帰型の言語モデルである。しりとりのように、前に出た語を見てから次の語を決めることを繰り返して文章ができあがる。
- ひっかけ「Transformer では、ソフトマックス関数でトークンをベクトルに変換し、埋め込みで次のトークンの予測確率を求める」は誤り。役割が逆である。Transformer の論文は、学習した埋め込みでトークンをベクトルに変え、ソフトマックス関数でデコーダの出力を次のトークンの予測確率に変えるとしている。工場にたとえると、埋め込みは材料(言葉)を機械が扱える形に整える入口、ソフトマックスは完成品の候補に「どれを出すか」の点数を付ける出口である。
- ひっかけ「生成AIは、同じ基準やポリシーで運用していれば、モデルの性質上、どの場面でも必ず同じ判断を下す」は誤り。AI事業者ガイドライン(別添)は、AI が同じ基準やポリシーで運用されているにもかかわらず、モデルの確率的性質に起因して、場面によって異なる判断を下すことがあると指摘している。確率的とは、決まった1つの答えではなく、確率にもとづいて選ぶということ。問い合わせへの回答を自動化するなら、同じ質問に違う案内をしていないか、定期的に確かめる必要がある。
02試験で正誤を分けるチェック順
- 1トークン化は、文章をモデルが扱う単位(トークン)に区切ることである。Transformer の論文は、文をバイトペア符号化(BPE)などで、単語より細かいサブワードの単位に区切って表した。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2トークンは単語と一致するとは限らず、単語より細かいサブワードに区切ることがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3トークンはモデルに渡すデータのかたまりで、文章だけでなく画像の入力もトークンとして数える。コンテキストウィンドウの大きさもトークンの数で決まる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4元のモデルと新しいデータの言語が違う場合は、トークン化の方法や語彙の拡張などの調整を検討する。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5埋め込み(Embedding)は、トークンを数値の並び(ベクトル)に変えることである。Transformer は学習した埋め込みで、入力と出力のトークンをベクトルに変える。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6埋め込みモデルは、テキストをベクトル表現(数値の並び)に変えるモデルである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7Transformer のデコーダの出力は、ソフトマックス関数で「次のトークンの予測確率」に変えられる。言語モデルは、この確率の分布をもとに次のトークンを選ぶ。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8自己回帰型の言語モデルは、それまでのトークンを入力に加えて、次のトークンを1つずつ生成する。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9トークンをベクトルに変えるのが埋め込み、デコーダの出力を次のトークンの確率に変えるのがソフトマックス関数である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10モデルが生成する内容は非決定的で、同じプロンプトでも毎回同じ出力になるとは限らない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11モデルの確率的な性質により、同じ基準やポリシーで運用していても、場面によって異なる判断を下すことがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
トークン化・埋め込み・確率的な次トークン予測の○×一問一答
1/8問解答 0・正解 0
生成AI
トークン化・埋め込み・確率的な次トークン予測|トークン化
Transformer の論文の機械翻訳の実験では、文をバイトペア符号化(BPE)などで、単語より細かいサブワードの単位に区切った語彙で表した。
トークン化・埋め込み・確率的な次トークン予測の○×一問一答11問|問題と解説
この論点で収録している11問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
トークン化・埋め込み・確率的な次トークン予測|トークン化Transformer の論文の機械翻訳の実験では、文をバイトペア符号化(BPE)などで、単語より細かいサブワードの単位に区切った語彙で表した。
答え:○(正しい)
解説
正しい。Transformer の論文は、英独の実験で文をバイトペア符号化(約37000トークンの語彙)で符号化し、英仏の実験ではトークンを32000のワードピースの語彙に分けたと述べている。バイトペア符号化は、論文が引くサブワード単位の方法である。サブワードとは単語の一部のかけら。「unhappiness」を「un」「happi」「ness」のように分けると、初めて見る単語も知っている部品の組み合わせとして扱える。 要点:トークン化は、文章をモデルが扱う単位(トークン)に区切ることである。Transformer の論文は、文をバイトペア符号化(BPE)などで、単語より細かいサブワードの単位に区切って表した。
問2
トークン化・埋め込み・確率的な次トークン予測|トークン≠単語トークンは必ず1つの単語と一致する単位であり、単語をさらに細かく分けてトークンにすることはない。
答え:×(誤り)
解説
誤り。トークンは単語と一致するとは限らない。Transformer の論文が使ったバイトペア符号化やワードピースのように、単語より細かいサブワードの単位に区切る方法が使われる。長い社名や専門用語を、よく出てくる部品に分けて覚えると、知らない言葉にも対応しやすい。トークンは、モデルにとっての「文字と単語の間くらいの部品」と考えるとよい。 要点:トークンは単語と一致するとは限らず、単語より細かいサブワードに区切ることがある。
問3
トークン化・埋め込み・確率的な次トークン予測|画像もトークンOpenAI のガイドは、トークンをモデルに渡すデータのかたまりとし、文章だけでなく画像もトークンとして扱われると説明している。
答え:○(正しい)
解説
正しい。OpenAI の Prompt engineering のガイドは、コンテキストウィンドウ(一度に扱える量の上限)をトークンで定めるとし、トークンを「文章から画像まで、モデルに渡すデータのかたまり」と説明している。トークンは利用量の単位でもある。スマートフォンの通信量を「ギガ」で数えるように、生成AIでは扱った量をトークンで数える、と考えると分かりやすい。 要点:トークンはモデルに渡すデータのかたまりで、文章だけでなく画像の入力もトークンとして数える。コンテキストウィンドウの大きさもトークンの数で決まる。
問4
トークン化・埋め込み・確率的な次トークン予測|言語が違うときAI事業者ガイドライン(別添)は、元の AI モデルと新しいデータの言語が異なる場合、トークン化の方法や語彙の拡張などの調整を検討するとしている。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(別添)は、モデルを目的に合わせて選択・調整する手法として、元の AI モデルと新しいデータの言語が一致しているかを確かめ、異なる場合はトークン化の方法や語彙の拡張等の調整を検討するとしている。英語中心に作った部品表のままでは、日本語の文を細切れにしすぎて扱いにくくなることがあるため、言葉に合った区切り方を考える、ということである。 要点:元のモデルと新しいデータの言語が違う場合は、トークン化の方法や語彙の拡張などの調整を検討する。
問5
トークン化・埋め込み・確率的な次トークン予測|埋め込みTransformer では、入力と出力のトークンを、学習によって得た埋め込み(Embedding)でベクトルに変換してから処理する。
答え:○(正しい)
解説
正しい。Transformer の論文は、学習した埋め込みを使って、入力と出力のトークンを一定の長さのベクトル(数値の並び)に変換すると述べている。コンピュータは文字のままでは計算できないので、言葉を数値の住所に置き換える。地図の上で「駅」と「電車」は近く、「駅」と「ケーキ」は遠い場所に置くように、意味の近さを数値の近さで表せるのが埋め込みの考え方である。 要点:埋め込み(Embedding)は、トークンを数値の並び(ベクトル)に変えることである。Transformer は学習した埋め込みで、入力と出力のトークンをベクトルに変える。
問6
トークン化・埋め込み・確率的な次トークン予測|埋め込みは数値にする埋め込み(Embedding)とは、トークンを数値に変えずに文字列のまま保存しておき、意味の近い文字列を辞書で探す仕組みのことである。
答え:×(誤り)
解説
誤り。埋め込みは、文字列のまま扱うのではなく、トークンや文章を数値の並び(ベクトル)に変えることである。OpenAI は埋め込みモデルを「テキストをベクトル表現に埋め込むモデル」と案内している(text-embedding-3 など)。数値にすることで、言い方が違っても意味の近い文章を見つけられる。「経費の精算方法」と「立て替えたお金の戻し方」を近い内容として探せる、といった使い方である。 要点:埋め込みモデルは、テキストをベクトル表現(数値の並び)に変えるモデルである。
問7
トークン化・埋め込み・確率的な次トークン予測|次のトークンの確率Transformer のデコーダは、出力をソフトマックス関数で変換し、次に来るトークンの予測確率(確率分布)を求める。
答え:○(正しい)
解説
正しい。Transformer の論文は、ソフトマックス関数を使って、デコーダの出力を次のトークンの予測確率に変換すると述べている。確率分布とは、候補ごとの「来そうな度合い」を合計100%に割り振ったもの。「本日は晴天」の次の候補に「なり」60%、「です」30%、「で」10%…と点数を付け、そこから次の語を選んでいくイメージである。 要点:Transformer のデコーダの出力は、ソフトマックス関数で「次のトークンの予測確率」に変えられる。言語モデルは、この確率の分布をもとに次のトークンを選ぶ。
問8
トークン化・埋め込み・確率的な次トークン予測|1つずつ生成するGPT-3 のような自己回帰型の言語モデルは、まず文章全体を一度にまとめて決め、そのあと各トークンの確率を計算する。
答え:×(誤り)
解説
誤り。自己回帰型のモデルは、文章全体を先に決めるのではなく、それまでに生成したトークンを入力に加えながら、次のトークンを1つずつ生成する。Transformer の論文はデコーダを各ステップで自己回帰的とし、GPT-3 は自己回帰型の言語モデルである。しりとりのように、前に出た語を見てから次の語を決めることを繰り返して文章ができあがる。 要点:自己回帰型の言語モデルは、それまでのトークンを入力に加えて、次のトークンを1つずつ生成する。
問9
トークン化・埋め込み・確率的な次トークン予測|ソフトマックスと埋め込みTransformer では、ソフトマックス関数でトークンをベクトルに変換し、埋め込みで次のトークンの予測確率を求める。
答え:×(誤り)
解説
誤り。役割が逆である。Transformer の論文は、学習した埋め込みでトークンをベクトルに変え、ソフトマックス関数でデコーダの出力を次のトークンの予測確率に変えるとしている。工場にたとえると、埋め込みは材料(言葉)を機械が扱える形に整える入口、ソフトマックスは完成品の候補に「どれを出すか」の点数を付ける出口である。 要点:トークンをベクトルに変えるのが埋め込み、デコーダの出力を次のトークンの確率に変えるのがソフトマックス関数である。
問10
トークン化・埋め込み・確率的な次トークン予測|出力は毎回同じではないOpenAI のガイドは、モデルが生成する内容は非決定的(毎回同じとは限らない)であるため、望む出力を得るプロンプトづくりには工夫が要ると説明している。
答え:○(正しい)
解説
正しい。OpenAI の Prompt engineering のガイドは、モデルが生成する内容は非決定的であるため、望む出力を得るためのプロンプトづくりは技術と科学の両面があると述べ、よい結果を安定して得る手法を紹介している。次のトークンを確率にもとづいて選ぶので、同じ質問でも言い回しが変わる。同じ依頼を2人の同僚に出すと、要点は同じでも文面が違う報告が返ってくるのに似ている。 要点:モデルが生成する内容は非決定的で、同じプロンプトでも毎回同じ出力になるとは限らない。
問11
トークン化・埋め込み・確率的な次トークン予測|確率的な性質生成AIは、同じ基準やポリシーで運用していれば、モデルの性質上、どの場面でも必ず同じ判断を下す。
答え:×(誤り)
解説
誤り。AI事業者ガイドライン(別添)は、AI が同じ基準やポリシーで運用されているにもかかわらず、モデルの確率的性質に起因して、場面によって異なる判断を下すことがあると指摘している。確率的とは、決まった1つの答えではなく、確率にもとづいて選ぶということ。問い合わせへの回答を自動化するなら、同じ質問に違う案内をしていないか、定期的に確かめる必要がある。 要点:モデルの確率的な性質により、同じ基準やポリシーで運用していても、場面によって異なる判断を下すことがある。
トークン化・埋め込み・確率的な次トークン予測の問題を続けて解く
この論点に対応する11問を絞り込んで出題します。