生成AI
LMとLLM・オンプレミス/オープンソースLLM
言語モデル(LM)は文章や単語の出現確率を扱うモデルで、それを非常に大量のデータで構築したものが大規模言語モデル(LLM)です。LLM はプロンプト(指示文)で翻訳・要約などさまざまなタスクをこなせます。クラウド型とオンプレミス型の違い(データをどこで扱うか・どの国の法令が適用されるか)と、公開されたモデルを使うときのライセンスと入手経路の確認を押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
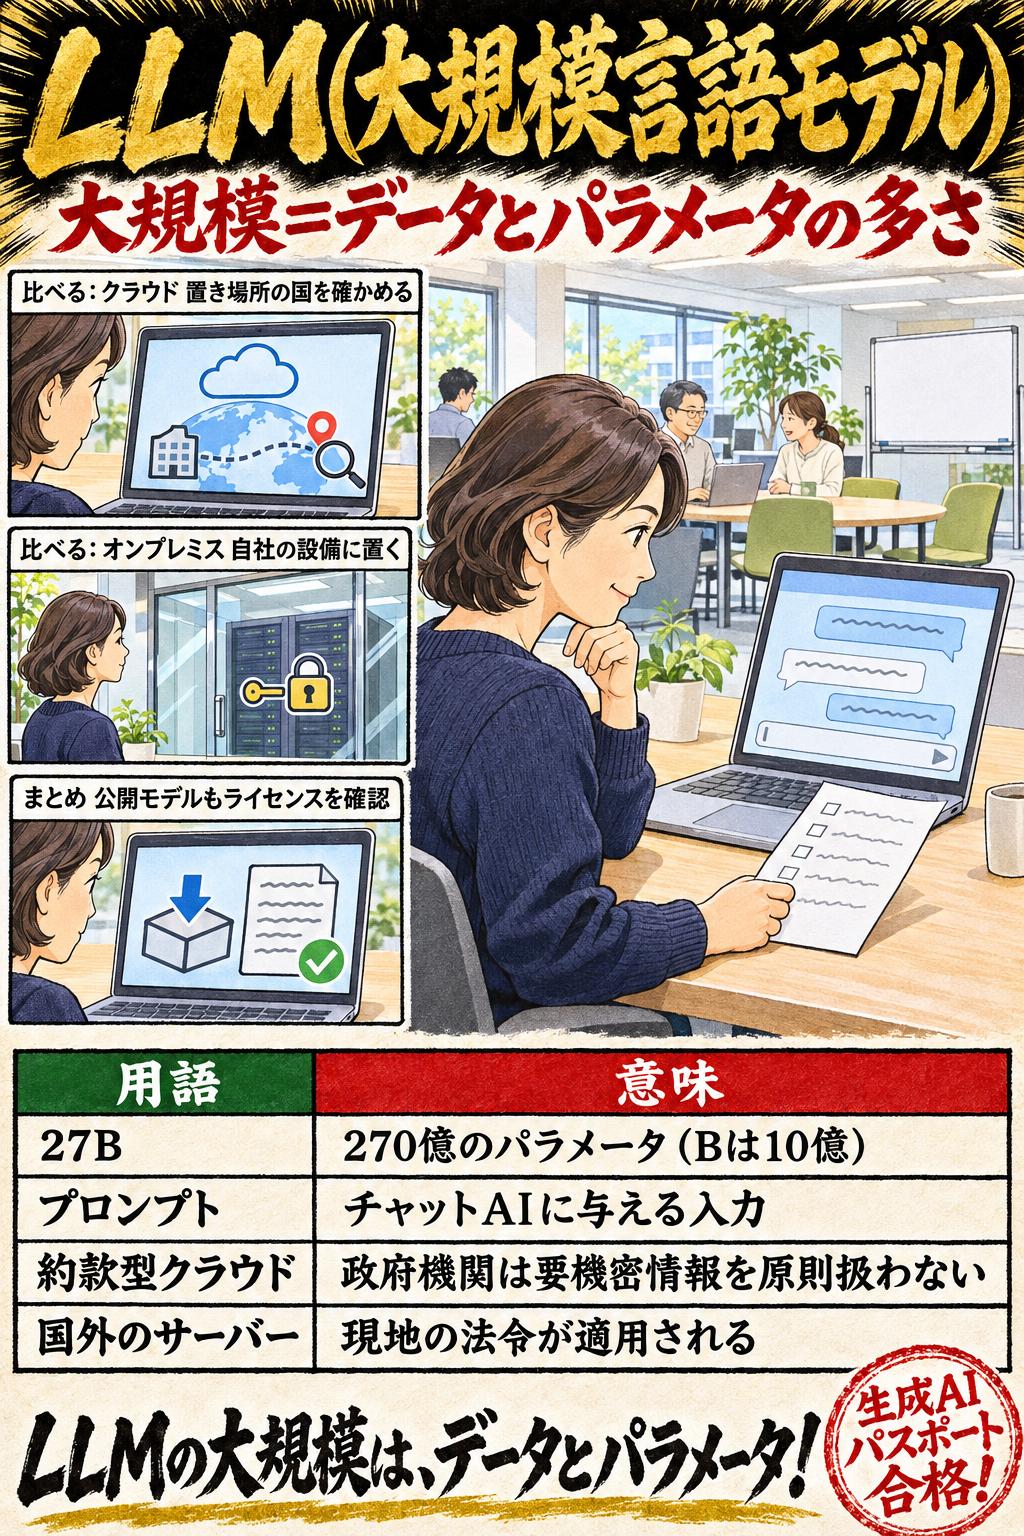
言語モデル(LM)は文章や単語の出現確率を扱うモデルで、それを非常に大量のデータで構築したものが大規模言語モデル(LLM)です。LLM はプロンプト(指示文)で翻訳・要約などさまざまなタスクをこなせます。クラウド型とオンプレミス型の違い(データをどこで扱うか・どの国の法令が適用されるか)と、公開されたモデルを使うときのライセンスと入手経路の確認を押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 13問
LMとLLM・オンプレミス/オープンソースLLM|LLM の定義
大規模言語モデル(LLM)は、文章や単語の出現確率を深層学習のモデルとして扱う言語モデルを、非常に大量の訓練データを使って構築したものである。
この論点の用語
用語集をすべて見る →01LMとLLM・オンプレミス/オープンソースLLMの重要暗記項目
LMとLLM・オンプレミス/オープンソースLLM|LLM の定義
大規模言語モデル(LLM)は、文章や単語の出現確率を深層学習のモデルとして扱う言語モデルを、非常に大量の訓練データを使って構築したものである。
LMとLLM・オンプレミス/オープンソースLLM|「大規模」の意味
LLM の「大規模」は、利用者の数ではなく、訓練データやモデル(パラメータ)の規模が非常に大きいことを指す。
ひっかけ注意「大規模言語モデル(LLM)の「大規模」は、利用者の数が多いことを表し、少量の訓練データで構築した言語モデルも利用者が多ければ LLM と呼ばれる」は誤り。 LLM は、文章や単語の出現確率を扱う言語モデルを、非常に大量の訓練データを用いて構築したものと定義されている。IPA の豆知識も、LLM を非常に大規模な AI モデルとし、規模をパラメータの数で表すとしている。お店の人気(利用者の数)ではなく、仕入れた材料と厨房の大きさ(データとモデル)の話である。
LMとLLM・オンプレミス/オープンソースLLM|規模の表し方
LLM の規模はパラメータ(モデルの中の数値)の数で表すことが多い。「27B」の B は Billion(10億)の頭文字で、270億のパラメータを持つことを表す。
LMとLLM・オンプレミス/オープンソースLLM|プロンプトとは
プロンプトは、チャットAIに利用者が与える入力のことで、個々の入力だけでなく、繰り返したやりとりの入力と出力の全体を指すこともある。
LMとLLM・オンプレミス/オープンソースLLM|型にはまらない出力
従来の AI は用途ごとに型にはまった入力と出力しか扱えなかったが、ChatGPT のような対話型AIは自由な文章の入力から、翻訳・要約・説明など多種多様な文章を生成でき、汎用性が高い。
LMとLLM・オンプレミス/オープンソースLLM|ひとつで複数の用途
生成AIはひとつで翻訳・要約など複数の用途に対応できるため、汎用 AI とも言われる。
ひっかけ注意「LLM を使った対話型AIは、翻訳なら翻訳用、要約なら要約用というように、用途ごとに別のモデルを用意しなければ使えない」は誤り。 IPA の豆知識は、従来の AI は用途別の使い分けが必要だったのに対し、生成AIはひとつで翻訳・要約などの複数の用途に対応できるため、しばしば汎用 AI とも言われると説明している。工具でいえば、ねじ回し・はさみ・栓抜きを別々に持ち歩く代わりに、1本で何役もこなす多機能ナイフを持つようなものである。
LMとLLM・オンプレミス/オープンソースLLM|クラウドとオンプレミス
AI の使い方(展開の形)には、クラウドサービスのほか、オンプレミス(自分の組織の設備に置く)システムなどがある。
LMとLLM・オンプレミス/オープンソースLLM|約款型のサービスと機密
約款への同意だけで使えるクラウドサービス型の生成AIを業務で使う場合、政府機関では原則として要機密情報(守秘の必要な情報)を取り扱わない。
ひっかけ注意「デジタル庁のガイドラインでは、定型約款や規約への同意だけで利用できるクラウドサービス型の生成AIであっても、業務で使う場合は要機密情報を原則として自由に入力してよいとされている」は誤り。 デジタル庁のガイドライン(DS-920)は、不特定多数に提供され、定型約款や規約等への同意のみで利用できるクラウドサービス型の生成AIシステムを業務で使う場合、原則として要機密情報を取り扱わないとしている。誰でも申し込める無料のサービスに、取引先との契約書や人事の情報を貼り付けない、という考え方である。
覚える数字と、狙われる引っかけ
- ひっかけ「大規模言語モデル(LLM)の「大規模」は、利用者の数が多いことを表し、少量の訓練データで構築した言語モデルも利用者が多ければ LLM と呼ばれる」は誤り。LLM は、文章や単語の出現確率を扱う言語モデルを、非常に大量の訓練データを用いて構築したものと定義されている。IPA の豆知識も、LLM を非常に大規模な AI モデルとし、規模をパラメータの数で表すとしている。お店の人気(利用者の数)ではなく、仕入れた材料と厨房の大きさ(データとモデル)の話である。
- ひっかけ「LLM を使った対話型AIは、翻訳なら翻訳用、要約なら要約用というように、用途ごとに別のモデルを用意しなければ使えない」は誤り。IPA の豆知識は、従来の AI は用途別の使い分けが必要だったのに対し、生成AIはひとつで翻訳・要約などの複数の用途に対応できるため、しばしば汎用 AI とも言われると説明している。工具でいえば、ねじ回し・はさみ・栓抜きを別々に持ち歩く代わりに、1本で何役もこなす多機能ナイフを持つようなものである。
- ひっかけ「デジタル庁のガイドラインでは、定型約款や規約への同意だけで利用できるクラウドサービス型の生成AIであっても、業務で使う場合は要機密情報を原則として自由に入力してよいとされている」は誤り。デジタル庁のガイドライン(DS-920)は、不特定多数に提供され、定型約款や規約等への同意のみで利用できるクラウドサービス型の生成AIシステムを業務で使う場合、原則として要機密情報を取り扱わないとしている。誰でも申し込める無料のサービスに、取引先との契約書や人事の情報を貼り付けない、という考え方である。
- ひっかけ「国外にサーバ装置を設置している生成AIサービスでも、日本の利用者が使う限り、データには日本の法令だけが適用される」は誤り。デジタル庁のガイドライン(DS-920)は、国外にサーバ装置を設置している場合は現地の法令が適用され、現地の政府等による検閲や接収を受ける可能性があるとしている。使う人が日本にいても、データを預ける先が海外ならその国のルールが及びうる。サービスを選ぶときは、データがどの国で保管・処理されるかを確かめる。
- ひっかけ「オープンウェイトやオープンソースとして公開されている AI モデルは、誰でも自由に使えるものなので、商用で使う前にライセンスを確かめる必要はない」は誤り。AI事業者ガイドライン(別添)は、学習済みのモデルを選ぶ際に、商用利用可能なライセンスかどうかを確かめるよう求めている。公開されているモデルにもライセンスがあり、OpenAI の gpt-oss も Apache 2.0 のライセンスで提供されている。無料で配られている写真素材にも「商用利用は不可」などの条件があるのと同じで、公開されていることと何にでも使ってよいことは別である。
02試験で正誤を分けるチェック順
- 1大規模言語モデル(LLM)は、文章や単語の出現確率を深層学習のモデルとして扱う言語モデルを、非常に大量の訓練データを使って構築したものである。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 2LLM の「大規模」は、利用者の数ではなく、訓練データやモデル(パラメータ)の規模が非常に大きいことを指す。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 3LLM の規模はパラメータ(モデルの中の数値)の数で表すことが多い。「27B」の B は Billion(10億)の頭文字で、270億のパラメータを持つことを表す。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4プロンプトは、チャットAIに利用者が与える入力のことで、個々の入力だけでなく、繰り返したやりとりの入力と出力の全体を指すこともある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5従来の AI は用途ごとに型にはまった入力と出力しか扱えなかったが、ChatGPT のような対話型AIは自由な文章の入力から、翻訳・要約・説明など多種多様な文章を生成でき、汎用性が高い。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6生成AIはひとつで翻訳・要約など複数の用途に対応できるため、汎用 AI とも言われる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7AI の使い方(展開の形)には、クラウドサービスのほか、オンプレミス(自分の組織の設備に置く)システムなどがある。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8約款への同意だけで使えるクラウドサービス型の生成AIを業務で使う場合、政府機関では原則として要機密情報(守秘の必要な情報)を取り扱わない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9国外にサーバー装置を置くサービスでは、現地の法令が適用され、現地の政府等による検閲や接収を受ける可能性がある。データをどこで扱うかを確かめる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10サーバー装置がある国の法令が適用されることがあるため、利用者が日本にいても、日本の法令だけで考えない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 112026年11月時点で OpenAI は、許容的なライセンス(Apache 2.0)で提供するオープンウェイトのモデル(gpt-oss)も公開している。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12事前学習済みのモデルを選んで追加で学習させる場合は、商用利用できるライセンスか、事前学習のデータ、必要な機械の性能、真正性(開発元や入手経路が信頼できるか)を確かめる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 13公開されているモデルにもライセンス(使ってよい条件)があるので、商用利用できるかを確かめてから使う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
LMとLLM・オンプレミス/オープンソースLLMの○×一問一答
1/8問解答 0・正解 0
生成AI
LMとLLM・オンプレミス/オープンソースLLM|LLM の定義
大規模言語モデル(LLM)とは、文章や単語の出現確率を深層学習モデルとして扱う言語モデルを、非常に大量の訓練データを用いて構築したものである。
LMとLLM・オンプレミス/オープンソースLLMの○×一問一答13問|問題と解説
この論点で収録している13問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
LMとLLM・オンプレミス/オープンソースLLM|LLM の定義大規模言語モデル(LLM)とは、文章や単語の出現確率を深層学習モデルとして扱う言語モデルを、非常に大量の訓練データを用いて構築したものである。
答え:○(正しい)
解説
正しい。デジタル庁のガイドライン(DS-920)の用語の補足は、AIプロダクト品質保証ガイドラインを引いて LLM をこのように定義している。言語モデル(LM)は「どんな言葉の並びが出てきやすいか」を確率で扱うモデルで、その大規模なものが LLM である。スマートフォンの文字入力で次の言葉の候補が出るのも言語モデルの考え方で、それを桁違いに大きくしたものが LLM と考えるとよい。 要点:大規模言語モデル(LLM)は、文章や単語の出現確率を深層学習のモデルとして扱う言語モデルを、非常に大量の訓練データを使って構築したものである。
問2
LMとLLM・オンプレミス/オープンソースLLM|「大規模」の意味大規模言語モデル(LLM)の「大規模」は、利用者の数が多いことを表し、少量の訓練データで構築した言語モデルも利用者が多ければ LLM と呼ばれる。
答え:×(誤り)
解説
誤り。LLM は、文章や単語の出現確率を扱う言語モデルを、非常に大量の訓練データを用いて構築したものと定義されている。IPA の豆知識も、LLM を非常に大規模な AI モデルとし、規模をパラメータの数で表すとしている。お店の人気(利用者の数)ではなく、仕入れた材料と厨房の大きさ(データとモデル)の話である。 要点:LLM の「大規模」は、利用者の数ではなく、訓練データやモデル(パラメータ)の規模が非常に大きいことを指す。
問3
LMとLLM・オンプレミス/オープンソースLLM|規模の表し方LLM の規模を表す「27B」の B は Billion(10億)の頭文字で、そのモデルが270億のパラメータ(数値)を持つことを表す。
答え:○(正しい)
解説
正しい。IPA の豆知識の用語集は、LLM の規模を表すのに 27B のように B を使うことが多く、B は Billion(10億)の頭文字で、27B はそのモデルが270億のパラメータを内包することを意味すると説明している。パラメータとは、学習で調整される数値のこと。料理のレシピの分量の目盛りが何百億個もあり、それを学習で細かく合わせていくイメージである。 要点:LLM の規模はパラメータ(モデルの中の数値)の数で表すことが多い。「27B」の B は Billion(10億)の頭文字で、270億のパラメータを持つことを表す。
問4
LMとLLM・オンプレミス/オープンソースLLM|プロンプトとはプロンプトは、チャットAIに対して利用者が与える入力のことで、個々の入力だけでなく、繰り返したやりとりの入力と出力の全体を指すこともある。
答え:○(正しい)
解説
正しい。IPA の豆知識の用語集は、プロンプトを「チャットAIでAIに対して与えるユーザーからの入力」とし、個々の入力だけでなく、やりとりが繰り返された場合の入力と出力の全体を指すこともあると説明している。上司が部下に渡す「依頼メモ」にあたり、それまでのやりとりの流れ全体もまとめて依頼の文脈になる、と考えるとよい。 要点:プロンプトは、チャットAIに利用者が与える入力のことで、個々の入力だけでなく、繰り返したやりとりの入力と出力の全体を指すこともある。
問5
LMとLLM・オンプレミス/オープンソースLLM|型にはまらない出力従来のAIは特定の型の入力と用途に限られていたのに対し、LLM を使った対話型AIは、自由な文章の入力から翻訳・要約・説明など型にはまらない文章を生成できる。
答え:○(正しい)
解説
正しい。IPA の豆知識は、従来の AI は特定の型の入力しか受け付けず出力も特定の用途に限られたが、ChatGPT のような対話型AIは自由に入力した文章から翻訳・要約・知識の説明など多種多様な文章を生成でき、汎用 AI の代名詞となっていると説明している。写真に写った物の名前を答えるだけの AI と、何でも相談できる窓口の違いにたとえられる。 要点:従来の AI は用途ごとに型にはまった入力と出力しか扱えなかったが、ChatGPT のような対話型AIは自由な文章の入力から、翻訳・要約・説明など多種多様な文章を生成でき、汎用性が高い。
問6
LMとLLM・オンプレミス/オープンソースLLM|ひとつで複数の用途LLM を使った対話型AIは、翻訳なら翻訳用、要約なら要約用というように、用途ごとに別のモデルを用意しなければ使えない。
答え:×(誤り)
解説
誤り。IPA の豆知識は、従来の AI は用途別の使い分けが必要だったのに対し、生成AIはひとつで翻訳・要約などの複数の用途に対応できるため、しばしば汎用 AI とも言われると説明している。工具でいえば、ねじ回し・はさみ・栓抜きを別々に持ち歩く代わりに、1本で何役もこなす多機能ナイフを持つようなものである。 要点:生成AIはひとつで翻訳・要約など複数の用途に対応できるため、汎用 AI とも言われる。
問7
LMとLLM・オンプレミス/オープンソースLLM|クラウドとオンプレミスデジタル庁のガイドラインは、AI の活用の形として、クラウドサービスのほか、オンプレミスシステムやサイバーフィジカルシステムなど様々な展開モデルを挙げている。
答え:○(正しい)
解説
正しい。デジタル庁のガイドライン(DS-920)は、AI の便益として、様々な分野への応用とあわせ、様々な展開モデル(クラウドサービス、オンプレミスシステム、サイバーフィジカルシステム等)の活用が考えられるとしている。クラウドはサービス会社の設備を借りて使う形、オンプレミスは自社の建物内にサーバーを置いて使う形。賃貸の倉庫を借りるか、自社倉庫を建てるかの違いにたとえられる。 要点:AI の使い方(展開の形)には、クラウドサービスのほか、オンプレミス(自分の組織の設備に置く)システムなどがある。
問8
LMとLLM・オンプレミス/オープンソースLLM|約款型のサービスと機密デジタル庁のガイドラインでは、定型約款や規約への同意だけで利用できるクラウドサービス型の生成AIであっても、業務で使う場合は要機密情報を原則として自由に入力してよいとされている。
答え:×(誤り)
解説
誤り。デジタル庁のガイドライン(DS-920)は、不特定多数に提供され、定型約款や規約等への同意のみで利用できるクラウドサービス型の生成AIシステムを業務で使う場合、原則として要機密情報を取り扱わないとしている。誰でも申し込める無料のサービスに、取引先との契約書や人事の情報を貼り付けない、という考え方である。 要点:約款への同意だけで使えるクラウドサービス型の生成AIを業務で使う場合、政府機関では原則として要機密情報(守秘の必要な情報)を取り扱わない。
問9
LMとLLM・オンプレミス/オープンソースLLM|国外のサーバー国外にサーバ装置を設置している生成AIサービスでは、現地の法令が適用され、現地の政府等による検閲や接収を受ける可能性がある。
答え:○(正しい)
解説
正しい。デジタル庁のガイドライン(DS-920)は、要機密情報を取り扱わない場合であっても、国外にサーバ装置を設置している場合は現地の法令が適用され、現地の政府等による検閲や接収を受ける可能性があることに留意するよう求めている。荷物を海外の倉庫に預けると、その国のルールで中身を調べられることがあるのと同じで、データの置き場所も確かめる。 要点:国外にサーバー装置を置くサービスでは、現地の法令が適用され、現地の政府等による検閲や接収を受ける可能性がある。データをどこで扱うかを確かめる。
問10
LMとLLM・オンプレミス/オープンソースLLM|適用される法令国外にサーバ装置を設置している生成AIサービスでも、日本の利用者が使う限り、データには日本の法令だけが適用される。
答え:×(誤り)
解説
誤り。デジタル庁のガイドライン(DS-920)は、国外にサーバ装置を設置している場合は現地の法令が適用され、現地の政府等による検閲や接収を受ける可能性があるとしている。使う人が日本にいても、データを預ける先が海外ならその国のルールが及びうる。サービスを選ぶときは、データがどの国で保管・処理されるかを確かめる。 要点:サーバー装置がある国の法令が適用されることがあるため、利用者が日本にいても、日本の法令だけで考えない。
問11
LMとLLM・オンプレミス/オープンソースLLM|オープンウェイトのモデル2026年11月時点で、OpenAI は API で使うモデルだけでなく、Apache 2.0 という許容的なライセンスで提供するオープンウェイトのモデルも公開している。
答え:○(正しい)
解説
正しい。OpenAI の API のモデルの一覧は「Open-weight models」として gpt-oss-120b・gpt-oss-20b を挙げ、許容的な Apache 2.0 のライセンスで提供すると案内している(2026年11月時点)。オープンウェイトとは、モデルの中身の数値(重み)を公開した形のこと。サービスとして借りるだけでなく、条件を守れば自分たちの環境に持ち込んで使える選択肢がある、ということである。 要点:2026年11月時点で OpenAI は、許容的なライセンス(Apache 2.0)で提供するオープンウェイトのモデル(gpt-oss)も公開している。
問12
LMとLLM・オンプレミス/オープンソースLLM|モデルを選ぶときの確認AI事業者ガイドライン(別添)は、事前学習済みの AI モデルに事後学習を行う場合、商用利用可能なライセンスかどうかや、開発元や取得経路が信頼できるか(真正性)などを確かめてモデルを選ぶよう求めている。
答え:○(正しい)
解説
正しい。AI事業者ガイドライン(別添)は、事前学習済の AI モデルに事後学習を行う場合、商用利用可能なライセンスかどうか、事前学習データ、学習・実行に必要なスペック、真正性等から適切に選択するとし、採用するモデルの開発元や取得経路が信頼できることを確認するとしている。ネットで見つけた便利なソフトを会社で使う前に、配布元と利用規約を確かめるのと同じ手順である。 要点:事前学習済みのモデルを選んで追加で学習させる場合は、商用利用できるライセンスか、事前学習のデータ、必要な機械の性能、真正性(開発元や入手経路が信頼できるか)を確かめる。
問13
LMとLLM・オンプレミス/オープンソースLLM|公開モデルにもライセンスオープンウェイトやオープンソースとして公開されている AI モデルは、誰でも自由に使えるものなので、商用で使う前にライセンスを確かめる必要はない。
答え:×(誤り)
解説
誤り。AI事業者ガイドライン(別添)は、学習済みのモデルを選ぶ際に、商用利用可能なライセンスかどうかを確かめるよう求めている。公開されているモデルにもライセンスがあり、OpenAI の gpt-oss も Apache 2.0 のライセンスで提供されている。無料で配られている写真素材にも「商用利用は不可」などの条件があるのと同じで、公開されていることと何にでも使ってよいことは別である。 要点:公開されているモデルにもライセンス(使ってよい条件)があるので、商用利用できるかを確かめてから使う。
LMとLLM・オンプレミス/オープンソースLLMの問題を続けて解く
この論点に対応する13問を絞り込んで出題します。