生成AI
マルチモーダルモデルと推論モデル(推論時の計算)
GPT シリーズは2024年に画像の入力や音声の入出力に対応したモデルが加わり、マルチモーダル化が進みました。2024年の o1 からは、強化学習で複雑な推論を行うよう学習した推論モデルが登場し、答える前に考える量(推論の強さ)を増やすほど難しい課題の結果がよくなりうる一方、時間とトークンが増えます。各社のモデルが何を入力・出力できるか、思考の連鎖(途中の手順を書かせる)を押さえると解けます。
要点 8件・基本問題 8問読む → 覚える → 解くまでこのページで完結
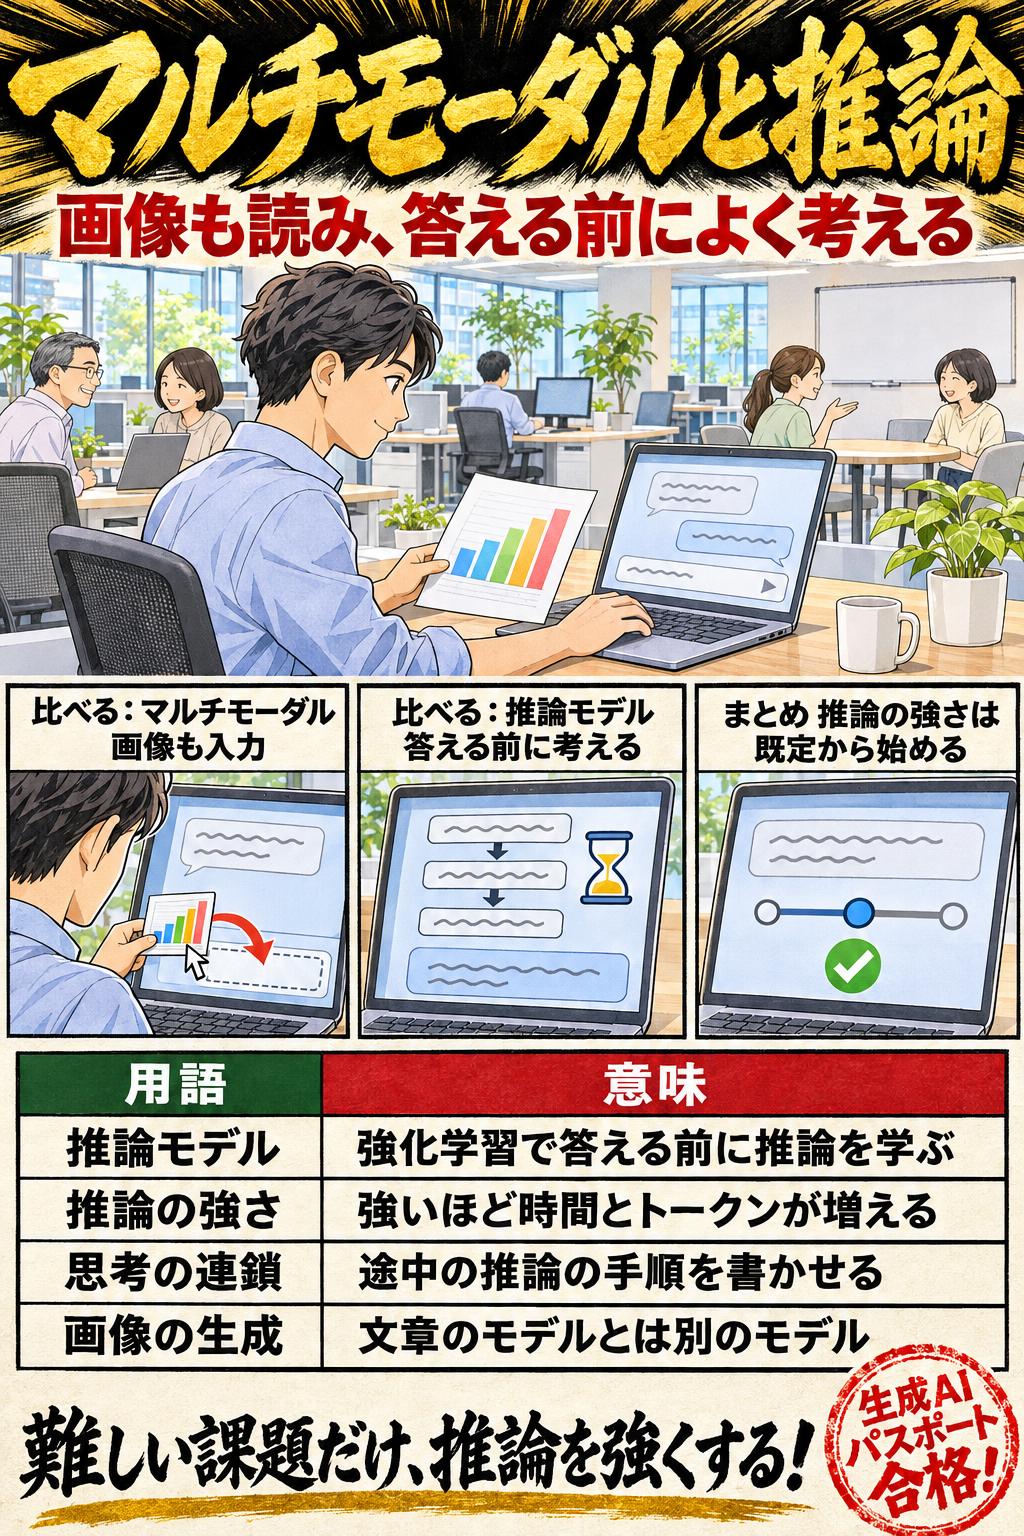
GPT シリーズは2024年に画像の入力や音声の入出力に対応したモデルが加わり、マルチモーダル化が進みました。2024年の o1 からは、強化学習で複雑な推論を行うよう学習した推論モデルが登場し、答える前に考える量(推論の強さ)を増やすほど難しい課題の結果がよくなりうる一方、時間とトークンが増えます。各社のモデルが何を入力・出力できるか、思考の連鎖(途中の手順を書かせる)を押さえると解けます。
このサイトでの学習
学習優先度 A対応する一問一答 12問
マルチモーダルモデルと推論モデル(推論時の計算)|画像・音声への対応
OpenAI は2024年4月に画像を入力できる GPT-4 Turbo with Vision を API で一般提供し、同年10月には音声を入力・出力できるモデルも出した。
この論点の用語
用語集をすべて見る →01マルチモーダルモデルと推論モデル(推論時の計算)の重要暗記項目
マルチモーダルモデルと推論モデル(推論時の計算)|画像・音声への対応
OpenAI は2024年4月に画像を入力できる GPT-4 Turbo with Vision を API で一般提供し、同年10月には音声を入力・出力できるモデルも出した。
マルチモーダルモデルと推論モデル(推論時の計算)|Claude は画像も読める
2026年11月時点の Claude の現行モデルは、どれも文章と画像を入力でき、文章を出力する。多言語・画像の理解(vision)・ツールの利用にも対応している。
マルチモーダルモデルと推論モデル(推論時の計算)|入力と出力は別
2026年11月時点の GPT-6.2 Astra は、文章と画像を入力でき、出力は文章である(音声・動画は対応していない)。画像の生成は別の画像のモデル(GPT Image)が担う。
ひっかけ注意「2026年11月時点の OpenAI の GPT-6.2 Astra は、文章と画像を入力でき、出力も文章・画像・音声から選べる」は誤り。 GPT-6.2 Astra のモデルのページは、出力は文章だけとし、画像は入力のみ、音声と動画は対応していないとしている。画像を読めることと画像を作れることは別の能力である。写真を見て説明文を書くのが得意な担当者に、イラストを描いてもらえるとは限らないのと同じで、作る作業は画像のモデルに頼む。
マルチモーダルモデルと推論モデル(推論時の計算)|得意ごとに別のモデル
OpenAI は、文章の主力のモデルのほかに、画像の生成・編集のモデル(GPT Image)や、音声の会話・書き起こしのモデルを別に提供している。
マルチモーダルモデルと推論モデル(推論時の計算)|推論モデルの始まり
推論モデル(Reasoning Model)は、強化学習によって、答える前に複雑な推論を行うよう学習したモデルである。OpenAI は2024年9月に o1-preview を公開した。
マルチモーダルモデルと推論モデル(推論時の計算)|推論の強さ
推論の強さ(reasoning effort)は、モデルが依頼について考える量の目安で、強くすると複雑な課題の結果がよくなりうる一方、時間がかかり、使うトークンも増える。
マルチモーダルモデルと推論モデル(推論時の計算)|強さと速さの関係
短く範囲のはっきりした作業には低い推論の強さ、手順や情報源が多い難しい作業には高い推論の強さが向く。
ひっかけ注意「推論モデルの推論の強さ(reasoning effort)を上げると、考える量が減るため、応答が速くなり、使うトークンも少なくなる」は誤り。 推論の強さを上げるとモデルが考える量が増え、時間がかかりトークンも多く使う。OpenAI の案内は、軽い設定は短く範囲のはっきりした作業に、高い設定は手順・情報源・比較が多い難しい作業に向くとしている。会議の議題を決めるのに、5分で済ませるか、半日かけて資料を読み込むかの違いで、深く考えるほど時間も手間もかかる。
マルチモーダルモデルと推論モデル(推論時の計算)|考える時間を増やす
推論の時の計算を増やす設定(ChatGPT の Max)は、選んだモデルに1つの課題についてより長く考えさせるもので、速さや使用量より深さが大事な最も難しい問題に使う。
覚える数字と、狙われる引っかけ
- ひっかけ「2026年11月時点の OpenAI の GPT-6.2 Astra は、文章と画像を入力でき、出力も文章・画像・音声から選べる」は誤り。GPT-6.2 Astra のモデルのページは、出力は文章だけとし、画像は入力のみ、音声と動画は対応していないとしている。画像を読めることと画像を作れることは別の能力である。写真を見て説明文を書くのが得意な担当者に、イラストを描いてもらえるとは限らないのと同じで、作る作業は画像のモデルに頼む。
- ひっかけ「推論モデルの推論の強さ(reasoning effort)を上げると、考える量が減るため、応答が速くなり、使うトークンも少なくなる」は誤り。推論の強さを上げるとモデルが考える量が増え、時間がかかりトークンも多く使う。OpenAI の案内は、軽い設定は短く範囲のはっきりした作業に、高い設定は手順・情報源・比較が多い難しい作業に向くとしている。会議の議題を決めるのに、5分で済ませるか、半日かけて資料を読み込むかの違いで、深く考えるほど時間も手間もかかる。
- ひっかけ「OpenAI の案内では、推論モデルを使うときは、どの課題でも常に最も高い推論の強さを選ぶのがよいとされている」は誤り。OpenAI の ChatGPT のモデルの案内は、既定の推論の強さから始め、計画・分析・確認が必要な課題のときに上げるよう勧め、ほとんどの課題には Max や Ultra は要らないとしている。社内の簡単な連絡にまで役員会と同じ審議をかけないのと同じで、課題の重さに合わせて考える量を選ぶ。
- ひっかけ「思考の連鎖(Chain-of-Thought)のプロンプトは、途中の考えを書かせずに最終的な答えだけを出させることで、計算や推論の精度を高める方法である」は誤り。思考の連鎖は、最終的な答えだけでなく、途中の推論の手順の連なりを生成させる方法である。Wei らの論文は、途中の手順を書いた例をプロンプトに示すことで、算数・常識・記号の推論の性能が上がったと述べている。上司に結論だけでなく「なぜそう判断したか」を順に説明させると、考えの抜けに気づきやすいのと似ている。
02試験で正誤を分けるチェック順
- 1OpenAI は2024年4月に画像を入力できる GPT-4 Turbo with Vision を API で一般提供し、同年10月には音声を入力・出力できるモデルも出した。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 22026年11月時点の Claude の現行モデルは、どれも文章と画像を入力でき、文章を出力する。多言語・画像の理解(vision)・ツールの利用にも対応している。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 32026年11月時点の GPT-6.2 Astra は、文章と画像を入力でき、出力は文章である(音声・動画は対応していない)。画像の生成は別の画像のモデル(GPT Image)が担う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 4OpenAI は、文章の主力のモデルのほかに、画像の生成・編集のモデル(GPT Image)や、音声の会話・書き起こしのモデルを別に提供している。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 5推論モデル(Reasoning Model)は、強化学習によって、答える前に複雑な推論を行うよう学習したモデルである。OpenAI は2024年9月に o1-preview を公開した。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 6推論の強さ(reasoning effort)は、モデルが依頼について考える量の目安で、強くすると複雑な課題の結果がよくなりうる一方、時間がかかり、使うトークンも増える。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 7短く範囲のはっきりした作業には低い推論の強さ、手順や情報源が多い難しい作業には高い推論の強さが向く。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 8推論の時の計算を増やす設定(ChatGPT の Max)は、選んだモデルに1つの課題についてより長く考えさせるもので、速さや使用量より深さが大事な最も難しい問題に使う。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 9推論の強さは既定から始め、必要な課題で上げる。ほとんどの課題に最も高い設定は要らない。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 10思考の連鎖(Chain-of-Thought)は、途中の推論の手順を一続きで書かせることで、大規模言語モデルの複雑な推論の能力を大きく高める方法である。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 11思考の連鎖のプロンプトでは、途中の推論の手順を書いた例を示して、モデルにも途中の手順を書かせる。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
- 12Google DeepMind は、Gemini 4 Argon の安全対策として、モデルの思考の連鎖と行動を監視し、必要なときは実行を止める対策を示している。
問題文の限定語を先に拾い、上の暗記項目と照合してから結論を出します。
03この論点の根拠
- 内容の基準日
- 2026-11-20
- 復習方法
- 要点を確認した後、○×一問一答で条件の違いを見分ける
法改正により扱いが変わる場合があります。試験日程や申込みに関する情報は、 必ず公式案内も確認してください。
問題演習
マルチモーダルモデルと推論モデル(推論時の計算)の○×一問一答
1/8問解答 0・正解 0
生成AI
マルチモーダルモデルと推論モデル(推論時の計算)|画像・音声への対応
OpenAI の API では、2024年に画像を入力できる GPT-4 Turbo with Vision が一般提供され、同じ年に音声の入力と出力に対応したモデルも公開された。
マルチモーダルモデルと推論モデル(推論時の計算)の○×一問一答12問|問題と解説
この論点で収録している12問を、正誤と解説つきで通して読めます。 上の演習で迷った問題を見直すときに使ってください。
問1
マルチモーダルモデルと推論モデル(推論時の計算)|画像・音声への対応OpenAI の API では、2024年に画像を入力できる GPT-4 Turbo with Vision が一般提供され、同じ年に音声の入力と出力に対応したモデルも公開された。
答え:○(正しい)
解説
正しい。OpenAI の API の変更履歴は、2024年4月9日に GPT-4 Turbo with Vision の一般提供を、2024年10月17日に音声の入力と出力の両方に対応する gpt-4o-audio-preview の公開を伝えている。文章だけでなく、写真を見せて質問したり、声で話しかけて声で答えを聞いたりできるようになった、というマルチモーダル化の流れである。 要点:OpenAI は2024年4月に画像を入力できる GPT-4 Turbo with Vision を API で一般提供し、同年10月には音声を入力・出力できるモデルも出した。
問2
マルチモーダルモデルと推論モデル(推論時の計算)|Claude は画像も読める2026年11月時点の Anthropic の Claude の現行モデルは、いずれも文章と画像を入力として受け取り、文章を出力できる。
答え:○(正しい)
解説
正しい。Anthropic の Models overview は、現行のモデルはすべて文章と画像の入力、文章の出力、多言語、画像の理解(vision)、ツールの利用に対応していると説明している(2026年11月時点)。たとえば、手書きのホワイトボードの写真を渡して「議事録の形に清書して」と頼む使い方ができる。 要点:2026年11月時点の Claude の現行モデルは、どれも文章と画像を入力でき、文章を出力する。多言語・画像の理解(vision)・ツールの利用にも対応している。
問3
マルチモーダルモデルと推論モデル(推論時の計算)|入力と出力は別2026年11月時点の OpenAI の GPT-6.2 Astra は、文章と画像を入力でき、出力も文章・画像・音声から選べる。
答え:×(誤り)
解説
誤り。GPT-6.2 Astra のモデルのページは、出力は文章だけとし、画像は入力のみ、音声と動画は対応していないとしている。画像を読めることと画像を作れることは別の能力である。写真を見て説明文を書くのが得意な担当者に、イラストを描いてもらえるとは限らないのと同じで、作る作業は画像のモデルに頼む。 要点:2026年11月時点の GPT-6.2 Astra は、文章と画像を入力でき、出力は文章である(音声・動画は対応していない)。画像の生成は別の画像のモデル(GPT Image)が担う。
問4
マルチモーダルモデルと推論モデル(推論時の計算)|得意ごとに別のモデル2026年11月時点の OpenAI は、文章の主力モデルとは別に、画像の生成・編集のためのモデルや、音声の会話・書き起こしのためのモデルも提供している。
答え:○(正しい)
解説
正しい。OpenAI のモデルの一覧は、主力のモデルとは別に、画像の生成と編集のモデル(GPT-Image)や、リアルタイムの音声の会話・書き起こしのモデル(GPT-Live・GPT-Transcribe など)の区分を設けている(2026年11月時点)。会社で、企画書は企画部、図版はデザイン部、録音の文字起こしは専門の業者、と得意な所に振り分けるのに似ている。 要点:OpenAI は、文章の主力のモデルのほかに、画像の生成・編集のモデル(GPT Image)や、音声の会話・書き起こしのモデルを別に提供している。
問5
マルチモーダルモデルと推論モデル(推論時の計算)|推論モデルの始まりOpenAI が2024年9月に公開した o1-preview と o1-mini は、強化学習によって複雑な推論のタスクを行うよう学習した大規模言語モデルである。
答え:○(正しい)
解説
正しい。OpenAI の API の変更履歴(2024年9月12日)は、o1-preview と o1-mini を「強化学習で複雑な推論のタスクを行うよう学習した新しい大規模言語モデル」として公開したと伝えている。思いついた答えをすぐ口にするのではなく、計算用紙に途中の考えを書きながら解くような働き方を身につけたモデルである。 要点:推論モデル(Reasoning Model)は、強化学習によって、答える前に複雑な推論を行うよう学習したモデルである。OpenAI は2024年9月に o1-preview を公開した。
問6
マルチモーダルモデルと推論モデル(推論時の計算)|推論の強さChatGPT で推論の強さ(reasoning effort)を上げると、複雑な課題では結果がよくなることがある一方、時間がかかり、使うトークンも増える。
答え:○(正しい)
解説
正しい。OpenAI の ChatGPT のモデルの案内は、推論の強さはモデルが依頼について考える量の目安で、強くすると複雑な課題の結果がよくなりうるが、時間がかかりトークンも多く使うとしている。答えを出す時(推論の時)に計算を多く使って考えさせる、ということ。急ぎのメールの言い換えは軽く、複数の見積もりの比較はじっくり、と使い分ける。 要点:推論の強さ(reasoning effort)は、モデルが依頼について考える量の目安で、強くすると複雑な課題の結果がよくなりうる一方、時間がかかり、使うトークンも増える。
問7
マルチモーダルモデルと推論モデル(推論時の計算)|強さと速さの関係推論モデルの推論の強さ(reasoning effort)を上げると、考える量が減るため、応答が速くなり、使うトークンも少なくなる。
答え:×(誤り)
解説
誤り。推論の強さを上げるとモデルが考える量が増え、時間がかかりトークンも多く使う。OpenAI の案内は、軽い設定は短く範囲のはっきりした作業に、高い設定は手順・情報源・比較が多い難しい作業に向くとしている。会議の議題を決めるのに、5分で済ませるか、半日かけて資料を読み込むかの違いで、深く考えるほど時間も手間もかかる。 要点:短く範囲のはっきりした作業には低い推論の強さ、手順や情報源が多い難しい作業には高い推論の強さが向く。
問8
マルチモーダルモデルと推論モデル(推論時の計算)|考える時間を増やすChatGPT の Max は、選んだモデルに1つの課題についてより長く考えさせる設定で、速さや使用量より深さが大事な最も難しい問題に向いている(2026年11月時点)。
答え:○(正しい)
解説
正しい。OpenAI の ChatGPT のモデルの案内は、Max は選んだモデルが1つの課題について推論する時間を増やすもので、速さや使用量より深さが大事な最も難しい問題に使うとしている。学習をやり直すのではなく、答える時に時間をかけて性能を引き出す考え方である。大事な契約の判断だけは、締め切りを延ばしてでもじっくり検討する、という使い方にあたる。 要点:推論の時の計算を増やす設定(ChatGPT の Max)は、選んだモデルに1つの課題についてより長く考えさせるもので、速さや使用量より深さが大事な最も難しい問題に使う。
問9
マルチモーダルモデルと推論モデル(推論時の計算)|いつも最高にはしないOpenAI の案内では、推論モデルを使うときは、どの課題でも常に最も高い推論の強さを選ぶのがよいとされている。
答え:×(誤り)
解説
誤り。OpenAI の ChatGPT のモデルの案内は、既定の推論の強さから始め、計画・分析・確認が必要な課題のときに上げるよう勧め、ほとんどの課題には Max や Ultra は要らないとしている。社内の簡単な連絡にまで役員会と同じ審議をかけないのと同じで、課題の重さに合わせて考える量を選ぶ。 要点:推論の強さは既定から始め、必要な課題で上げる。ほとんどの課題に最も高い設定は要らない。
問10
マルチモーダルモデルと推論モデル(推論時の計算)|思考の連鎖思考の連鎖(Chain-of-Thought)とは、答えに至るまでの途中の推論の手順を順に書かせることで、大規模言語モデルが複雑な推論をこなす能力を高める方法である。
答え:○(正しい)
解説
正しい。Wei らの論文は、途中の推論の手順の連なり(思考の連鎖)を生成させると、大規模言語モデルの複雑な推論の能力が大きく向上することを示し、算数・常識・記号の推論で性能が上がったと述べている。算数の文章題で、答えだけ書くより「まず単価を出して、次に個数を掛けて」と途中式を書くほうが間違えにくいのと同じ考え方である。 要点:思考の連鎖(Chain-of-Thought)は、途中の推論の手順を一続きで書かせることで、大規模言語モデルの複雑な推論の能力を大きく高める方法である。
問11
マルチモーダルモデルと推論モデル(推論時の計算)|途中を書かせる思考の連鎖(Chain-of-Thought)のプロンプトは、途中の考えを書かせずに最終的な答えだけを出させることで、計算や推論の精度を高める方法である。
答え:×(誤り)
解説
誤り。思考の連鎖は、最終的な答えだけでなく、途中の推論の手順の連なりを生成させる方法である。Wei らの論文は、途中の手順を書いた例をプロンプトに示すことで、算数・常識・記号の推論の性能が上がったと述べている。上司に結論だけでなく「なぜそう判断したか」を順に説明させると、考えの抜けに気づきやすいのと似ている。 要点:思考の連鎖のプロンプトでは、途中の推論の手順を書いた例を示して、モデルにも途中の手順を書かせる。
問12
マルチモーダルモデルと推論モデル(推論時の計算)|思考の監視Google DeepMind は、Gemini 4 Argon の安全対策として、モデルの思考の連鎖(chain-of-thought)と行動を監視し、必要なときは実行を止めると説明している。
答え:○(正しい)
解説
正しい。Google DeepMind の Gemini のページは、安全対策として、Gemini 4 Argon の思考の連鎖と行動を監視し、必要なときに実行を止める対策(意図とずれた動きへの対策)を展開していると説明している(2026年11月時点)。推論モデルは考える過程を持つので、その過程も点検の対象になる。作業の結果だけでなく、作業日報の中身も見て危ない兆しに気づく、という管理にあたる。 要点:Google DeepMind は、Gemini 4 Argon の安全対策として、モデルの思考の連鎖と行動を監視し、必要なときは実行を止める対策を示している。
マルチモーダルモデルと推論モデル(推論時の計算)の問題を続けて解く
この論点に対応する12問を絞り込んで出題します。